Loading page

Pour 72 des 139 domaines de marque éligibles, le domaine enregistré n’apparaît jamais parmi les 22 115 destinations identifiables de ChatGPT Shopping.
ChatGPT peut recommander un produit, nommer la marque et, malgré tout, afficher des liens d’achat qui mènent vers d’autres sites.
Pour 72 des 139 domaines de marque éligibles à l’analyse, aucune destination d’achat identifiable ne correspondait au domaine enregistré. Le taux médian de correspondance était de 0 %.
Sur 22 115 destinations identifiables rattachées à des résultats d’achat historiques de ChatGPT, du 1er décembre 2025 au 31 mars 2026, seules 6,4 % d’entre elles partageaient le domaine enregistré de la marque du produit.
Il ne s’agit pas d’un résultat de ventes. L’étude observe des destinations d’achat affichées, pas des impressions, des clics, des achats, des commandes ni du chiffre d’affaires.
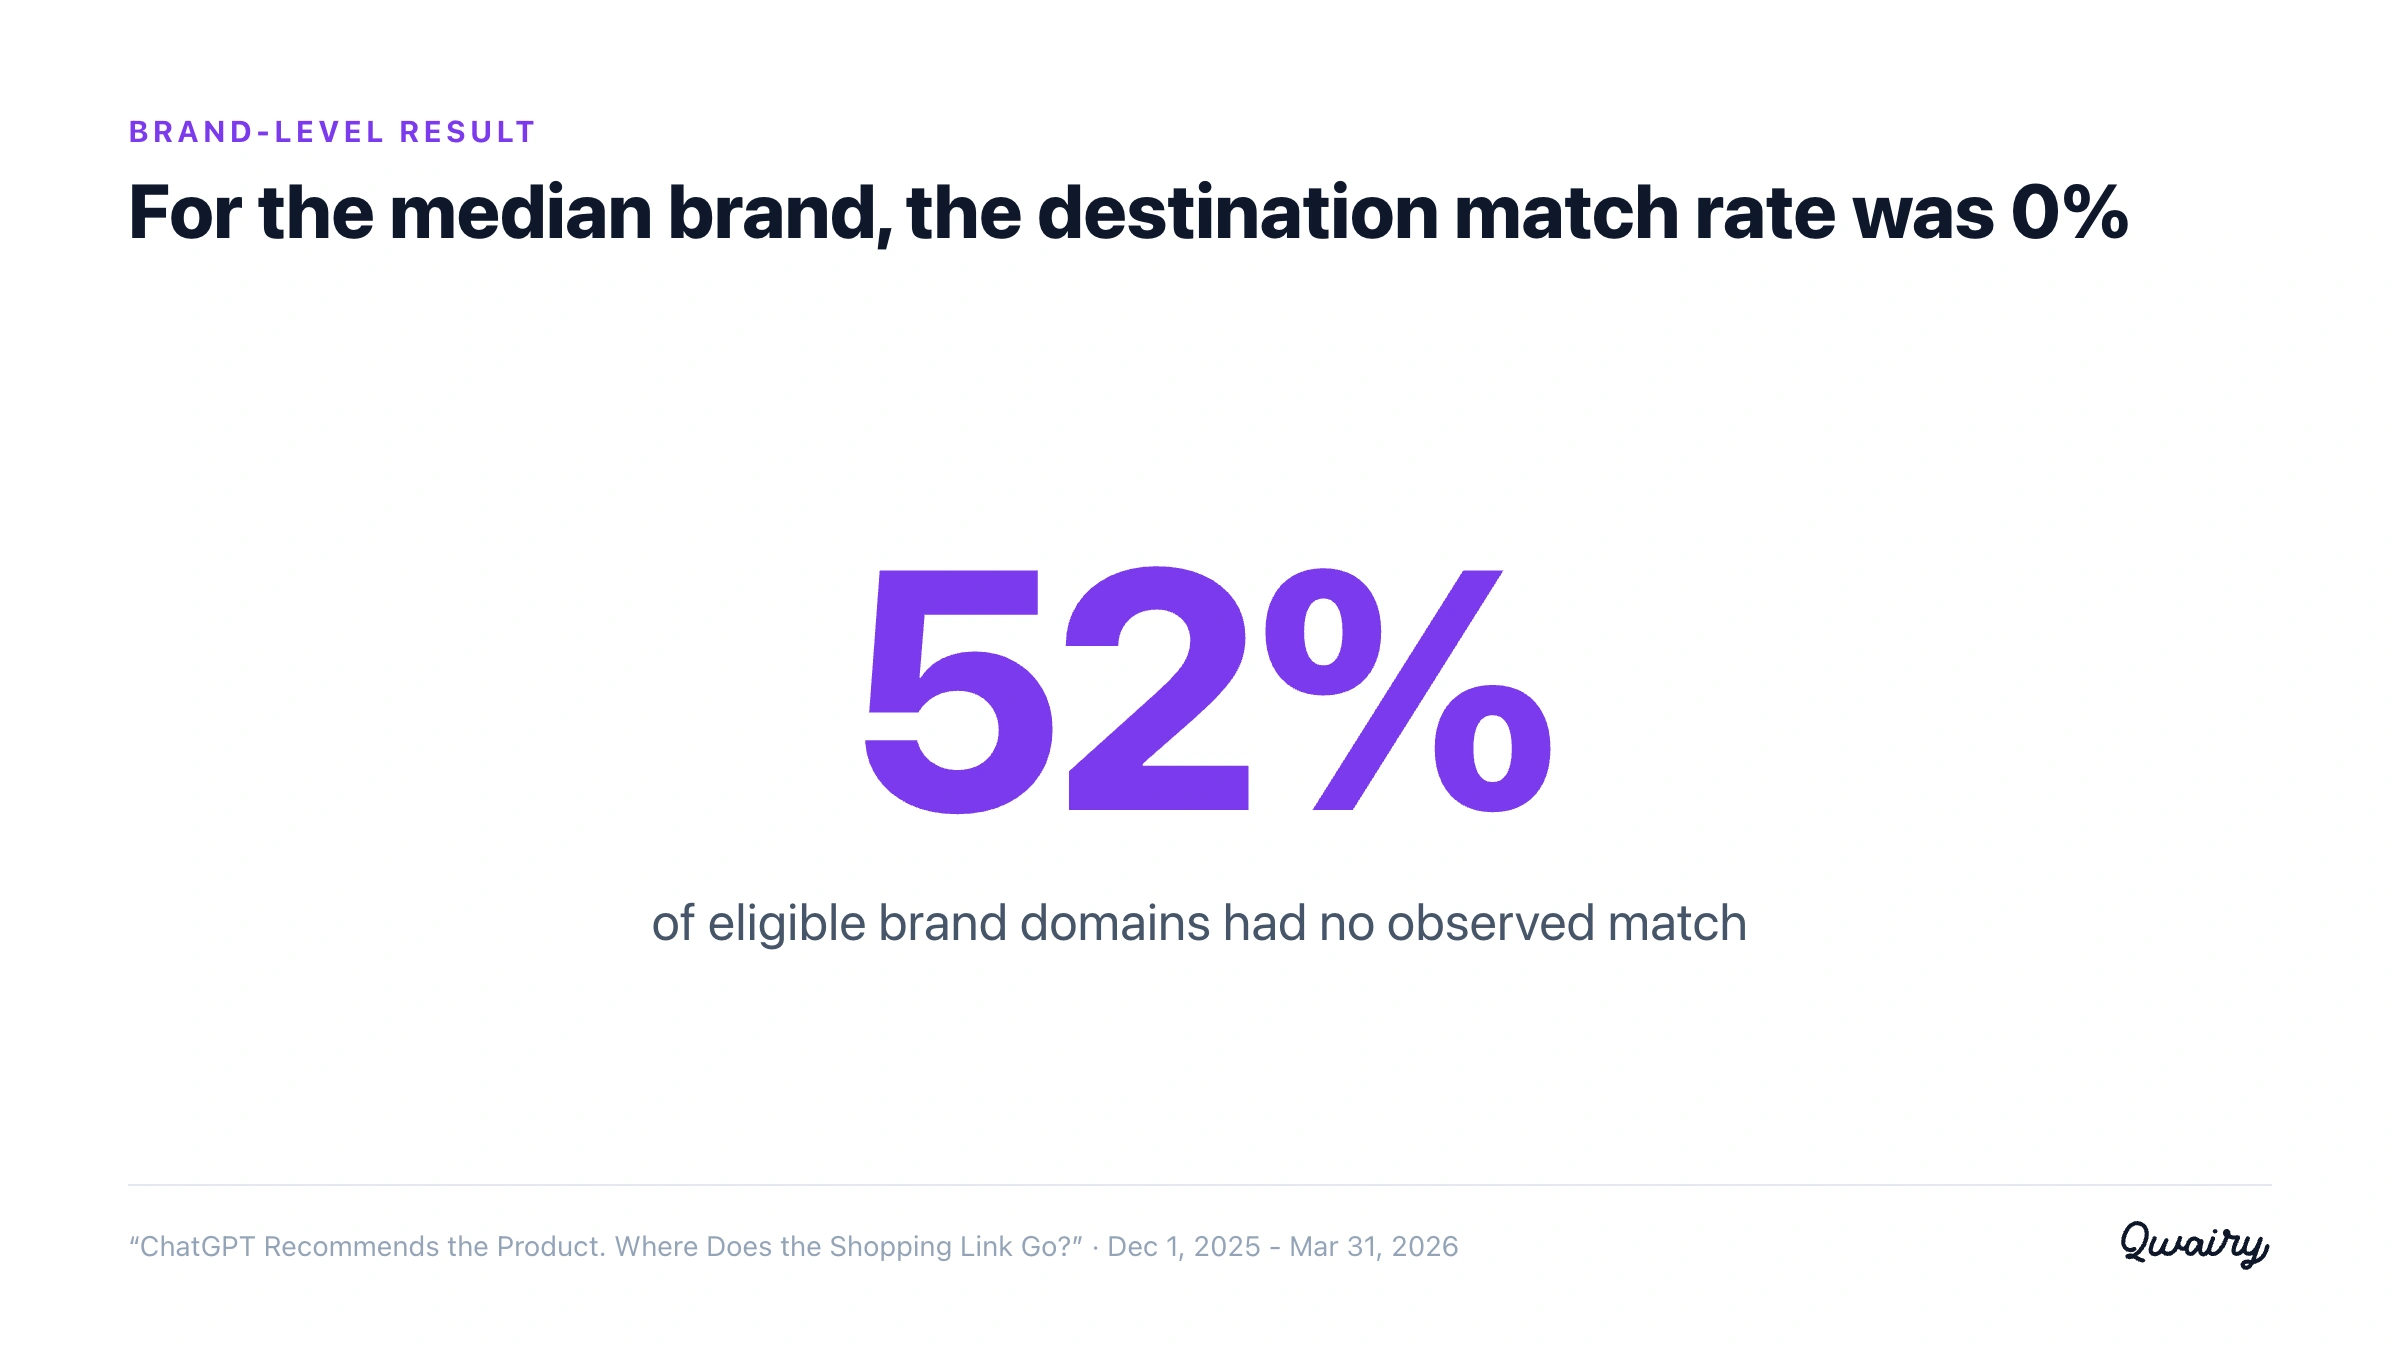
51,8 %, soit 72 des 139 domaines de marque éligibles, n’avaient aucune correspondance observée. Un zéro ne vaut que pour les produits, les prompts, les marchés et les dates représentés dans le panel.
Dans une capture d’interface de juillet 2026, ChatGPT recommande la Nike Pegasus 41. Les options d’achat visibles à côté mènent vers Intersport, Sport 2000 et SportsShoes.com, tandis que nike.com est absent de la liste visible.
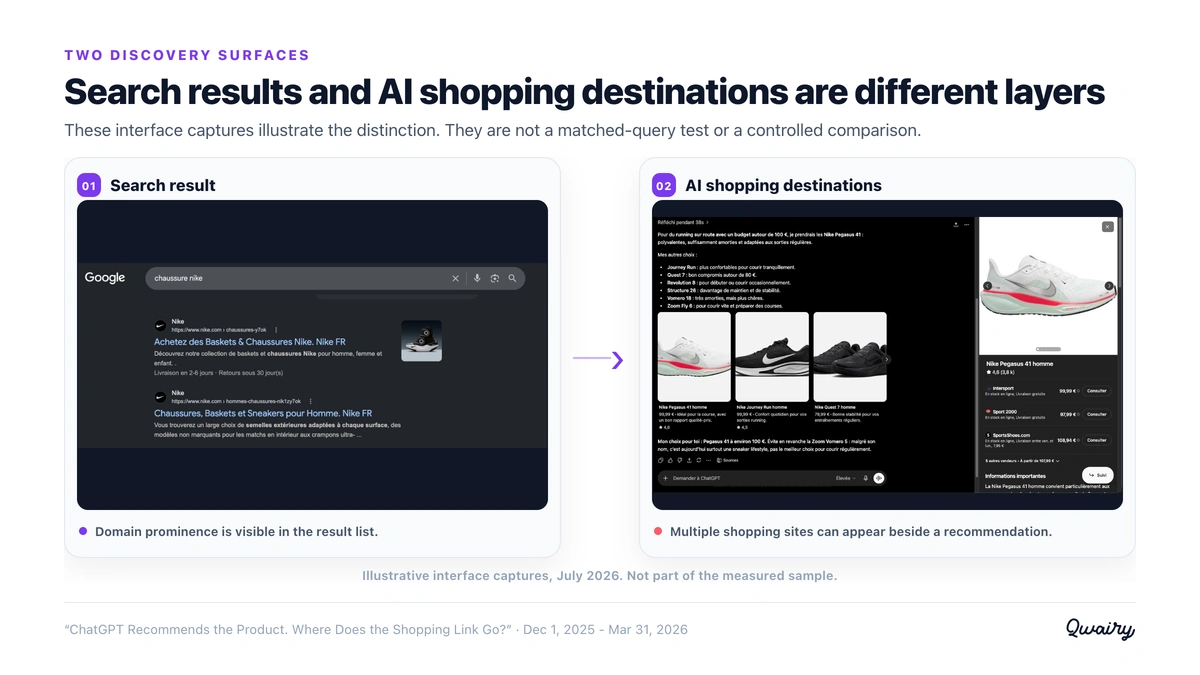
Captures d’interface données à titre d’illustration, juillet 2026. Elles se situent hors de la période mesurée et ne constituent ni un test à requêtes appariées ni une comparaison contrôlée.
Cet exemple rend le mécanisme concret : la recommandation de produit et le site d’achat forment deux couches distinctes. Il ne montre pas que Nike a perdu un clic ou une vente, et il ne fait pas partie de l’échantillon mesuré.
La documentation actuelle d’OpenAI sur le shopping indique que ChatGPT peut afficher des images de produits, des détails, des prix et des liens vers les sites de marchands.
Lorsque plusieurs marchands proposent un produit, l’interface peut présenter plusieurs options.
La documentation actuelle décrit aussi des facteurs comme la disponibilité, le prix, la qualité et le fait qu’un marchand soit le fabricant ou le vendeur principal.
Elle a été mise à jour après la période d’étude : elle ne prouve donc pas que les mêmes règles de classement s’appliquaient de décembre 2025 à mars 2026 (Centre d’aide d’OpenAI ).
La distinction est simple :
OpenAI continue de faire évoluer cette couche.
Le 24 mars 2026, l’entreprise a annoncé une comparaison de produits plus riche et de nouveaux moyens, pour les marchands, de fournir leurs données produit via l’Agentic Commerce Protocol (OpenAI ).
Cet article constitue donc un repère historique figé, et non une description permanente de l’interface actuelle.
Une destination identifiable est une URL d’achat qui peut être normalisée en nom d’hôte. Qwairy comptait une destination comme « même domaine » lorsque ce nom d’hôte était identique au domaine enregistré de la marque du produit ou correspondait à l’un de ses sous-domaines. Nous décrivons tout le reste, en langage courant, comme d’autres domaines d’achat. Il peut s’agir de places de marché et de revendeurs, mais aussi de domaines régionaux, de filiales, de sites de la maison mère, d’entités commerciales distinctes ou de vitrines sur des places de marché. Dans l’analyse, tous sont simplement classés comme noms d’hôte sans correspondance. Il s’agit d’une comparaison technique, et non d’une cartographie complète de la propriété, de l’autorisation, de la livraison ou de la distribution. Une correspondance de nom d’hôte n’identifie pas non plus le vendeur final et ne prouve pas où le paiement a eu lieu.
Les observations principales portaient sur 139 domaines de marque éligibles. Leurs parts de « même domaine » étaient très inégales. La moyenne à poids égal était de 5,7 %, mais la médiane de 0 %. Au total, 51,8 %, soit 72 domaines sur 139, n’avaient aucune destination « même domaine » observée dans le panel. Le 75e percentile s’établissait à 9,1 %.
Sur l’ensemble du panel principal, 6,43 % des destinations identifiables partageaient le domaine enregistré de la marque du produit. Dans cet article, les chiffres du récit arrondissent ce résultat à 6,4 %.
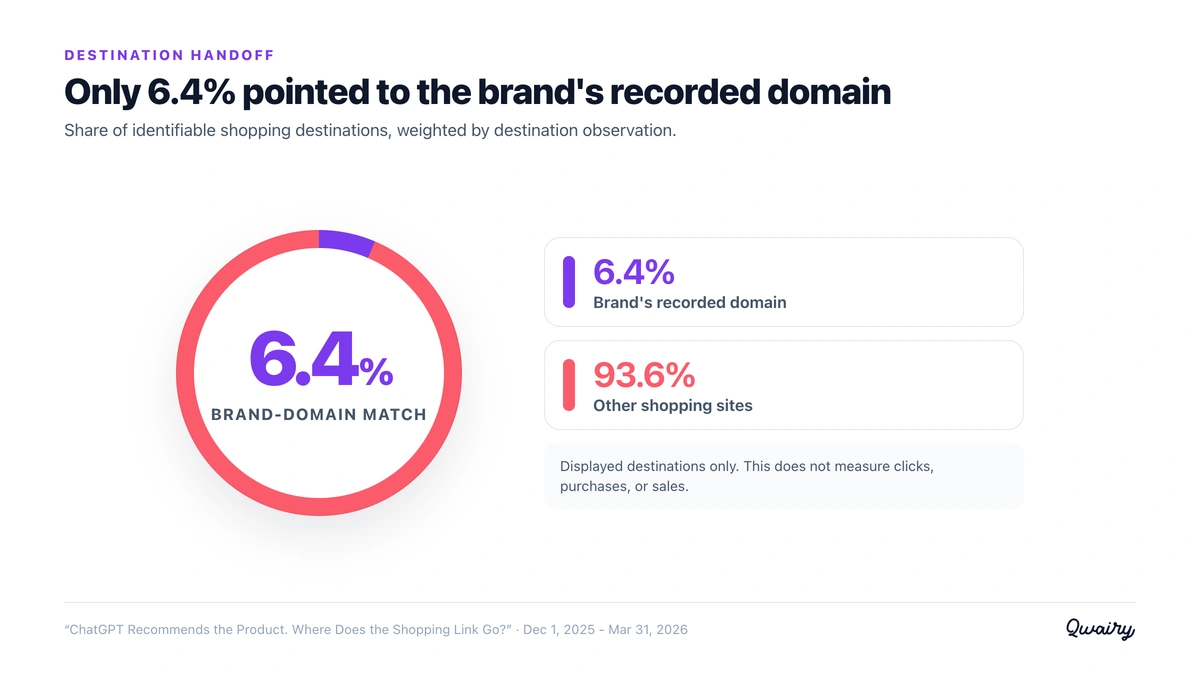
Résultat pondéré par destination sur 22 115 destinations d’achat identifiables. Destinations affichées uniquement, pas de clics, d’achats ni de ventes. Le panel n’était dominé par aucun domaine de marque en particulier. Les dix domaines de marque les plus observés représentaient 34,4 % des destinations éligibles, et le plus important 8,9 %.
Lancez un audit gratuit : en quelques minutes, ChatGPT, Gemini et Perplexity répondent en direct à 8 questions d’achat sur votre marché, et vous voyez qui ils recommandent.
Le taux calculé au niveau des destinations ne montre pas si le domaine enregistré de la marque et d’autres domaines d’achat apparaissaient ensemble. La composition des fiches produits, elle, le montre. Parmi les 7 551 fiches produits comptant au moins une destination identifiable :
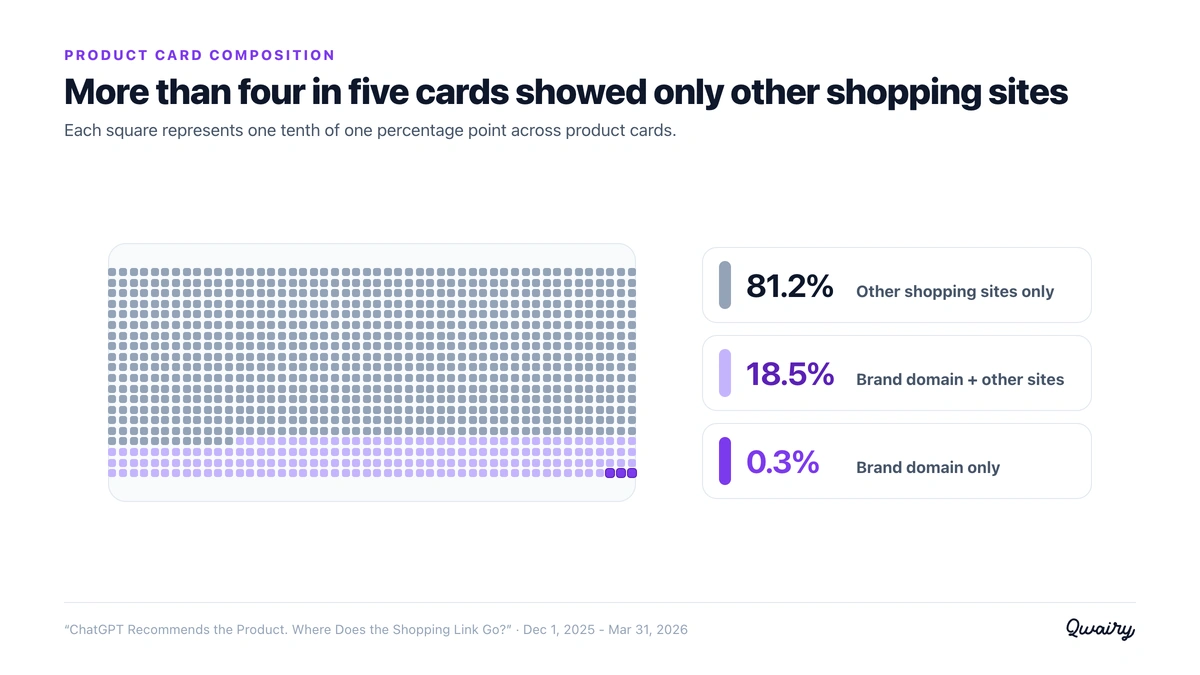
Les fiches sont classées d’après toutes les destinations identifiables rattachées à chaque fiche produit historique. « Domaine de la marque » désigne le domaine enregistré de la marque du produit ou l’un de ses sous-domaines. Les fiches mixtes comptent. Elles montrent que la couche d’achat peut présenter un choix de sites plutôt qu’un lien unique. En donnant le même poids à chaque fiche, on obtient une part moyenne « même domaine » de 5,5 %, proche de l’estimation principale.
Les observations répétées posent une question de pondération. Les marques de produits à gros volume, les fiches comptant de nombreuses destinations ou les routes répétées peuvent influencer un simple total. Qwairy a donc calculé le résultat selon quatre angles :
Angle d’analyse | Résultat « même domaine » | Ce qu’il contrôle |
Toutes les destinations identifiables | 6,43 % | Estimation principale au niveau des destinations |
Poids égal par domaine de marque | 5,7 % | Les domaines à gros volume |
Poids égal par fiche produit | 5,5 % | Les fiches comptant de nombreuses destinations |
10 785 routes uniques produit-destination | 6,5 % | Les routes identiques répétées |
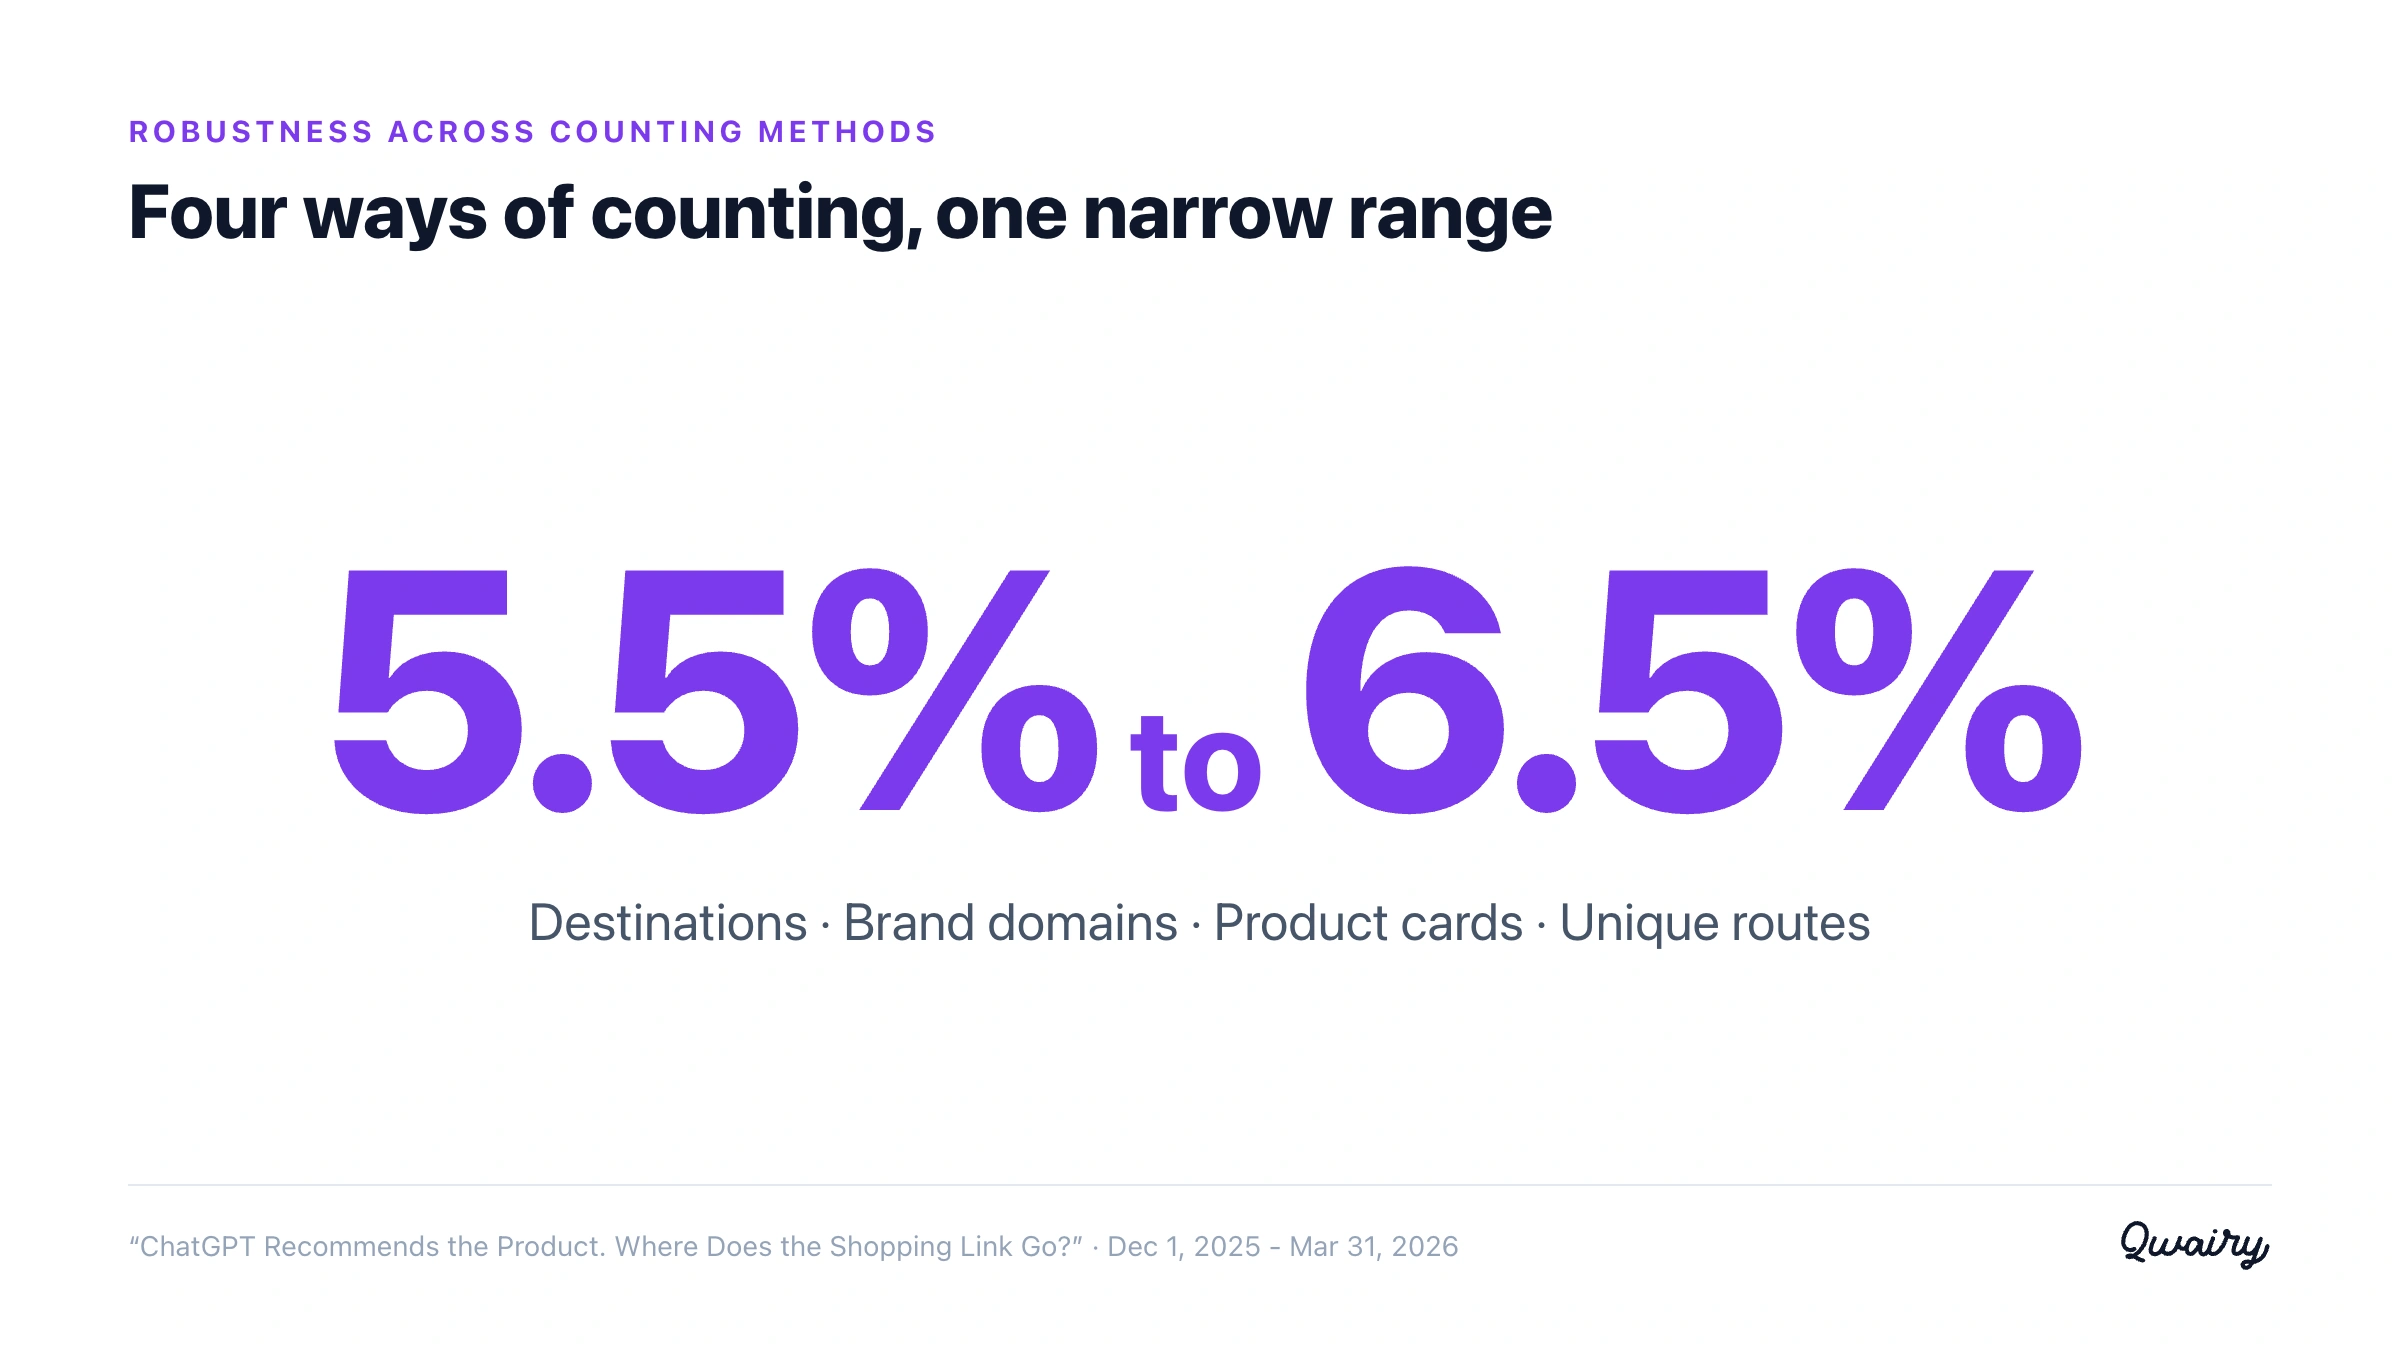
Changer l’unité d’analyse a légèrement déplacé l’estimation, sans inverser le résultat. Deux cohortes de sensibilité aboutissent à la même conclusion générale :
Qwairy a également effectué un rééchantillonnage au niveau du domaine de marque afin de préserver la corrélation au sein de chaque domaine. L’intervalle descriptif de rééchantillonnage à 95 % qui en résulte va de 4,53 % à 8,42 % autour de l’estimation de 6,43 %. Ce n’est pas un intervalle de confiance de population. Il décrit la variation entre les domaines de marque représentés dans le panel et ne lève pas les limites de mesure exposées ci-dessous.
Des recherches externes confirment la nécessité de distinguer présentation, visite et achat. Adobe a indiqué que le trafic issu de l’IA vers les sites de distribution américains avait augmenté de 393 % sur un an au premier trimestre 2026 et convertissait 42 % mieux que le trafic non issu de l’IA dans son jeu de données de mars. Ces chiffres concernent des visites par référence une fois la destination choisie, et non des destinations affichées dans une réponse (Adobe Digital Insights ). Un preprint observationnel de juin 2026 a associé les recommandations à des recherches et à des visites ultérieures de la marque chez des utilisateurs sans engagement récent observé avec cette marque, sans observer de transactions (From Prompt to Purchase ). Une autre étude, publiée dans Marketing Science, a analysé des sessions et des transactions attribuées à ChatGPT d’août 2024 à juillet 2025, soit une étape plus précoce du canal (Marketing Science ). Ces résultats ne peuvent pas être combinés avec les 6,4 % de Qwairy. Ils mesurent des étapes différentes du parcours.
La bonne réponse n’est pas de réduire le commerce par l’IA à un seul indicateur. Suivez au moins quatre couches :
Examinez ensuite les écarts sans présumer de leur cause. Données produit, lisibilité par les machines, disponibilité, informations de livraison et couverture des domaines régionaux sont des vérifications raisonnables, mais cette étude n’identifie aucun mécanisme de classement. La stratégie de distribution modifie aussi l’interprétation. Une destination sans correspondance peut être attendue et précieuse. Une équipe qui privilégie son propre domaine enregistré peut voir dans le même schéma un écart de présence à examiner.
Voyez quelles discussions Reddit, YouTube, LinkedIn et forums les réponses IA citent, selon les modèles et pays pris en charge.
Il s’agit d’une étude observationnelle rétrospective d’observations de production de ChatGPT Shopping dans le panel de Qwairy. Elle n’inclut aucune réexécution synthétique créée pour cet article. La fenêtre principale court du 1er décembre 2025 au 31 mars 2026 inclus. La complétude et la structure du champ de destination ont changé après mars ; les observations ultérieures n’ont donc pas été regroupées dans l’estimation principale. Le périmètre se limite à ChatGPT. Aucune inférence entre moteurs n’est faite.
Pour entrer dans la cohorte principale, un domaine de marque devait compter au moins 50 options de marchands capturées et au moins 95 % d’URL de destination exploitables. Le seuil de 95 % a été calculé avant le retrait des options sans URL. Ces URL inconnues ont ensuite été exclues du dénominateur du taux de correspondance, ce qui laisse 22 115 observations de destinations identifiables. L’attribution de la marque du produit exigeait qu’un nom de marque enregistré de plus de trois caractères apparaisse dans le titre du produit. Les titres de produit normalisés correspondant à plus d’un domaine de marque ont été exclus. Dans le test de sensibilité plus strict par préfixe de titre, le titre de produit normalisé devait commencer par le nom de marque enregistré. Chaque relation retenue exigeait un enregistrement de domaine actif ayant passé la validation technique au moment de l’analyse. Cela ne prouve pas, en soi, la propriété du fabricant. Les enregistrements actuels de domaine et de statut ont été appliqués rétrospectivement ; des migrations historiques peuvent donc créer des écarts.
Les URL de destination et les domaines de marque ont été normalisés avant comparaison. Une correspondance exigeait un nom d’hôte identique ou un sous-domaine du domaine enregistré. La formule principale était :
destinations identifiables « même domaine » / toutes les destinations identifiables
Les estimateurs alternatifs utilisaient un poids égal par domaine de marque, un poids égal par fiche produit et les routes uniques. Une route unique était définie par le domaine de marque, le titre de produit normalisé, le pays et le nom d’hôte de la destination.
L’intervalle descriptif repose sur un rééchantillonnage bootstrap au niveau du domaine de marque, en préservant toutes les observations au sein de chaque grappe de domaine rééchantillonnée.
La présence du produit et la présence de la destination sont deux couches distinctes de ChatGPT Shopping. Dans ce panel historique, 6,4 % des destinations identifiables partageaient le domaine enregistré de la marque du produit. Le résultat est resté cohérent dans les analyses par domaine, par fiche, par route et de sensibilité. Il ne révèle pas où quiconque a acheté. Pour les équipes e-commerce, ce repère n’est pas un objectif universel. La prochaine étape utile consiste à cartographier le passage de relais sur leur propre catalogue. Avec Qwairy, les équipes peuvent identifier quels prompts font apparaître leurs produits, quels domaines de destination s’affichent à côté, et où la présence du produit est plus forte que la présence « même domaine ». Les produits souvent recommandés mais rarement accompagnés du domaine enregistré de la marque constituent un point de départ concret pour l’enquête. Servez-vous de cette liste de priorités pour examiner les données produit, la couverture des flux catalogue, la disponibilité, les informations de livraison et la correspondance des domaines régionaux. Répétez ensuite les mêmes prompts suivis pour voir si la présence des destinations évolue dans le temps. Qwairy mesure les couches de recommandation et de destination. Les clics, les paiements et le chiffre d’affaires doivent rester validés par vos analytics first-party.
Suivez les questions qui comptent pour votre activité, voyez quelles marques chaque réponse mentionne et quelles sources elle cite, puis travaillez sur les manques.
Offre gratuite avec 120 crédits initiaux • Sans carte bancaire
Autres articles
AI Overviews en France : ce que Google cite vraiment, face aux États-Unis
Qwairy et Converteo ont analysé 12 120 réponses AI Overviews en France et aux États-Unis : requêtes déclenchantes, sources citées, autorité et volatilité.
Questions de suivi IA : la première réponse n’est pas la décision
72 % des réponses IA invitent à poser une autre question, et la présélection se rebat quand l’acheteur répond. Le benchmark Qwairy montre ce que décide ce tour.