Loading page

Étude LLM du T2 2025 : 32 961 requêtes et trois modèles analysés pour comprendre les citations IA, prolongée au T3 2025 sur 184 128 requêtes.
Notre étude du T3 2025, qui analyse 184 128 requêtes, prolonge cette recherche avec un échantillon 5,6 fois plus grand et des analyses du BOFU, des taux de citation et du positionnement des marques.
Lorsque nous avons lancé Qwairy, notre outil GEO, notre mission était d’aider les marketeurs à améliorer la visibilité de leur marque dans les LLM comme ChatGPT, AI Overview (Gemini) et Perplexity. La recherche évolue. Notre façon de naviguer sur le web depuis 20 ans est en train d’être remplacée, peu à peu, par un nouveau paradigme. Je le remarque tous les jours. Pas plus tard que le week-end dernier, j’étais avec ma mère. Quand elle a voulu trouver un café, elle a tout de suite dit :
« Voyons ce que ChatGPT recommande. » En construisant Qwairy, nous avons vite compris que les responsables marketing avaient besoin de données pour étayer leurs analyses. Après beaucoup de travail, nous sommes fiers de vous présenter cette étude complète, fondée sur 32 961 requêtes réparties sur trois LLM (SearchGPT, Gemini et Perplexity). Voyons ce que nous pouvons en retirer pour renforcer la présence de votre marque dans les résultats des LLM.
Avant de commencer, nous voulons vous expliquer comment nous avons généré et collecté les données. Toutes les données ont été générées sur notre outil GEO, Qwairy. Qwairy est un outil qui vous aide à améliorer la présence de votre marque dans les LLM. Les données proviennent soit de nos propres analyses de marques, soit de clients qui ont ajouté leurs marques à la plateforme. Au total, nous avons généré 32 961 réponses sur trois LLM (SearchGPT, Gemini et Perplexity), toutes entre fin 2024 et début 2025. Nous avons posé le même ensemble de questions à chaque modèle. Chaque réponse inclut aussi les sources utilisées par les LLM, pour un total de 59 992 sources (une réponse pouvant comporter plusieurs sources). Comme tout jeu de données, celui-ci comporte des biais inhérents. Nous voulons être aussi transparents que possible. Toutes les réponses ont été générées via les API des LLM. Les modèles utilisés étaient GPT-4-o-mini Search, désigné sous le nom de SearchGPT dans cette étude, Sonar (Perplexity) et Gemini 2.0. Ces résultats décrivent les modèles et les réponses API de la période étudiée ; ils ne représentent pas nécessairement les interfaces grand public actuelles. Un biais important à signaler : toutes les données ont été générées via Qwairy, par nous-mêmes et par nos clients. Notre jeu de données couvre des marques variées (e-commerce, SaaS, blogs, etc.). Nous prévoyons de mener cette analyse chaque trimestre pour aider les SEO, les marketeurs et les CMO. À mesure que Qwairy sera plus utilisé, chaque rapport deviendra plus complet. Enfin, il faut préciser que la plupart de nos clients actuels sont francophones. Nous accueillons de plus en plus de clients internationaux, donc les prochains rapports seront plus représentatifs à l’échelle mondiale. Cela dit, le monde du SEO est depuis longtemps façonné par des études américaines, et cela continue. Un peu de regard français ne fera pas de mal. 😉 Notre objectif avec cette première étude est de donner aux CMO, aux responsables SEO et aux professionnels du marketing les données dont ils ont besoin pour mieux comprendre comment se classer dans les résultats générés par les LLM. Nous ne prétendons pas avoir percé le code du classement dans les LLM, mais nous sommes convaincus que ces données peuvent vous aider à renforcer votre présence sur des plateformes comme ChatGPT.
Le premier aspect que nous avons analysé concerne les réponses générées par les LLM. Nous avons cherché à identifier des schémas récurrents dans ces réponses.
Avec les moteurs de réponses et les LLM, un nouveau paradigme émerge dans le marketing de la recherche. Il ne s’agit plus d’apparaître dans le « top 10 » classique des résultats de Google. Aujourd’hui, l’objectif est d’être explicitement mentionné dans la réponse du LLM. Si vous êtes Tesla et que quelqu’un cherche la meilleure voiture électrique avec un LLM, vous voulez être la première marque mentionnée. La première analyse que nous avons menée porte donc sur le nombre de concurrents cités par les différents LLM :
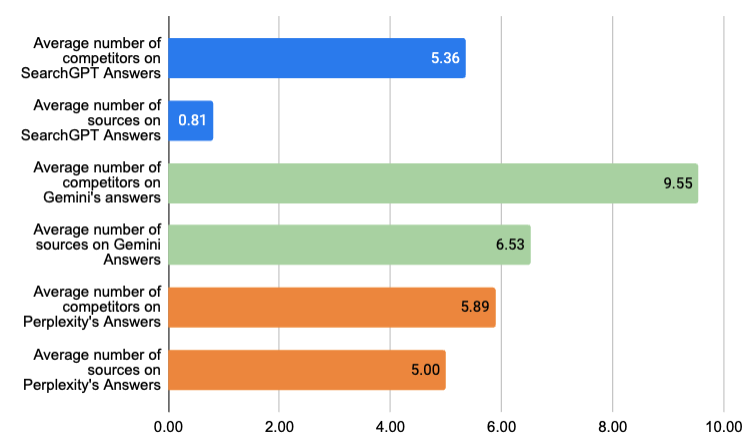
💡 Enseignements : le classement ne se joue plus sur 10 résultats. Pour être bien classé, il faut être présent en tant que marque dans les LLM. 💡 Enseignement : dans cet échantillon, Gemini mentionnait davantage de concurrents que SearchGPT et Perplexity. Ces observations ne permettent pas, à elles seules, d’en établir la cause. 💡 SearchGPT semble ne citer que 0,81 source en moyenne. Une précision s’impose : ChatGPT ne fournissait pas toutes les sources à nos débuts avec Qwairy. Nous avons trouvé une solution, et les résultats seront plus précis à l’avenir.
Le deuxième point que nous voulions analyser est le nombre de caractères par réponse, selon le modèle utilisé.
Modèle | Nombre de caractères | Estimation du nombre de mots (équivalent) |
SearchGPT | 1 686,9 | 280 à 340 |
Gemini | 2 955 | 490 à 590 |
Sonar | 2 029 | 340 à 410 |
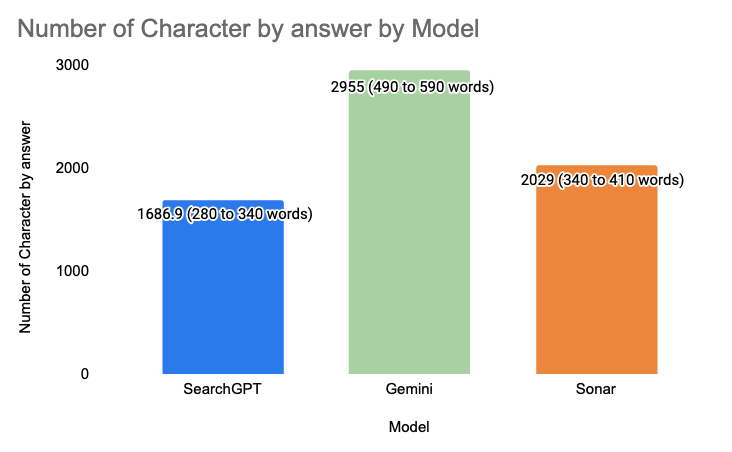
💡 Enseignement : dans cet échantillon, Gemini utilisait davantage de mots que SearchGPT. Cette différence décrit les réponses des modèles étudiés et ne suffit pas à établir une longueur de contenu optimale aujourd’hui.
Expressions les plus utilisées par SearchGPT
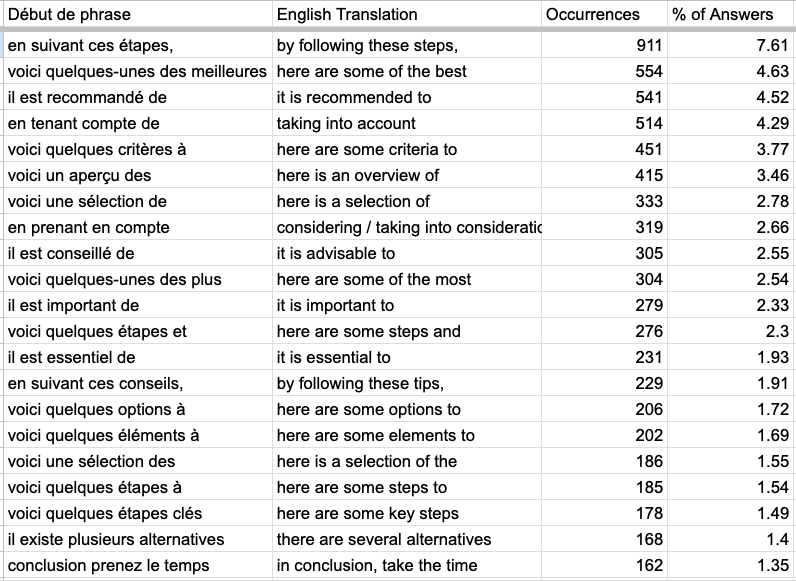
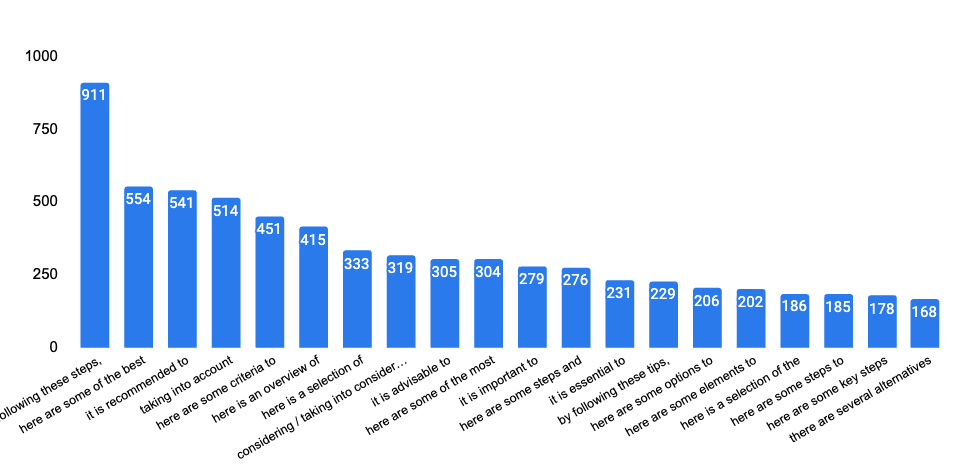
💡 Enseignement : l’expression « en suivant ces étapes » apparaît dans 7,61 % des réponses SearchGPT du panel concerné, qui comprend plus de 11 000 réponses. Le graphique indique 911 occurrences; il ne s’agit pas de 11 000 occurrences de cette expression. Remarquez aussi la présence d’expressions comme « recommandé », « en considérant », « prenez le temps ». Les LLM ne sont pas parfaits et veulent éviter tout risque de donner un mauvais conseil. Précisons que nous avons traduit ces expressions en français pour la lecture de cet article. Les expressions originales citées dans les graphiques restent en anglais.
Expressions les plus utilisées par Gemini
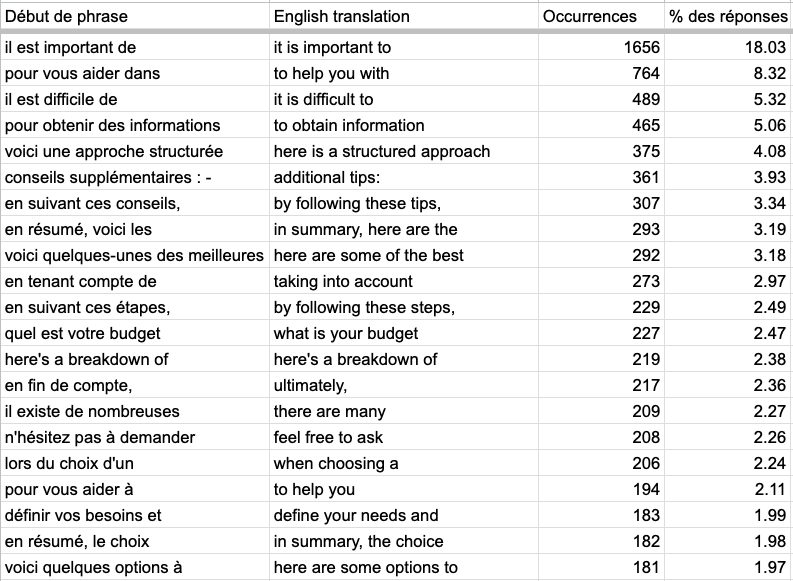
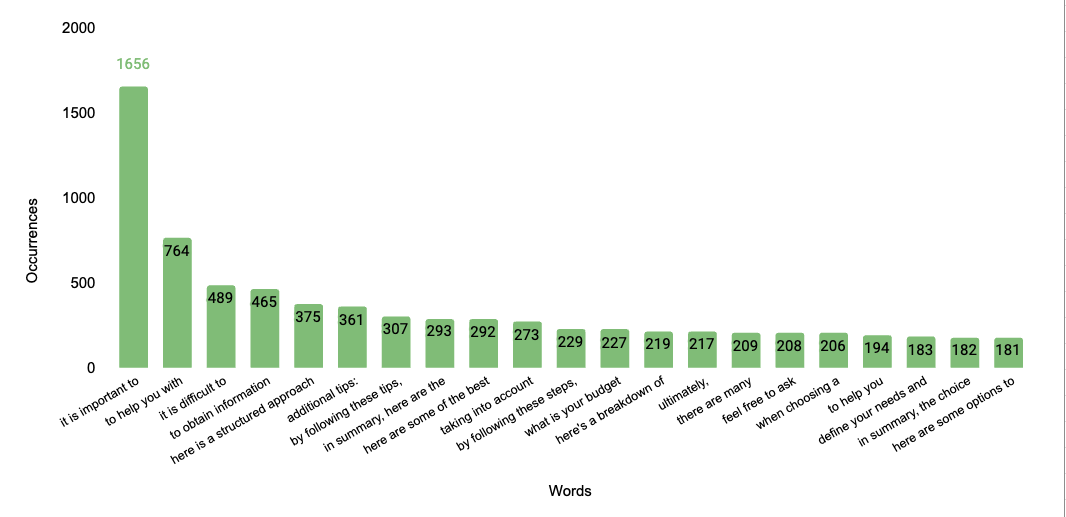
💡 Enseignements : l’expression la plus courante est « il est important de ». Cela montre combien il importe aux LLM de vous mettre en garde avant votre décision. Là encore, ces expressions suivent des schémas communs :
Expressions les plus utilisées par Sonar
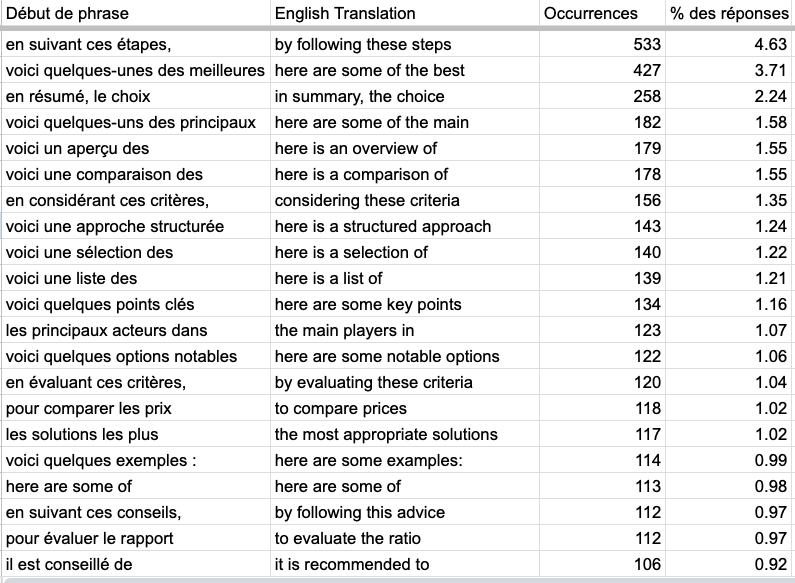
💡 Enseignement : comme pour SearchGPT, l’expression la plus utilisée par Sonar est « en suivant ces étapes ». Nous avons posé les mêmes questions principales à tous les LLM, donc il semble s’agir d’une formule très courante chez les LLM.
Lancez un audit gratuit : en quelques minutes, ChatGPT, Gemini et Perplexity répondent en direct à 8 questions d’achat sur votre marché, et vous voyez qui ils recommandent.
Nous voulions aussi analyser la façon dont les LLM s’expriment. Notre hypothèse est que si vous vous exprimez comme un LLM, vous pourriez avoir plus de chances d’être bien classé (il s’agit de notre hypothèse personnelle). Les LLM doivent traiter votre contenu avant de l’utiliser, et notre hypothèse est que vous leur simplifieriez la tâche en vous exprimant comme eux.
Comment s’exprime SearchGPT ? ✅ Forme impersonnelle (par ex. « il est recommandé ») : présente dans 17,8 % de toutes les réponses de SearchGPT. ✅ Verbe incitatif (par ex. « découvrez », « choisissez ») : présent dans 25,2 % de toutes les réponses de SearchGPT. ✅ Emploi du conditionnel (par ex. « pourrait », « serait ») : présent dans 18,9 % de toutes les réponses de SearchGPT. ✅ Emploi de l’impératif (par ex. « essayez », « profitez ») : présent dans 25,3 % de toutes les réponses de SearchGPT.
Comment s’exprime Gemini ? ✅ Forme impersonnelle (par ex. « il est recommandé ») : présente dans 38,42 % de toutes les réponses de Gemini. ✅ Verbe incitatif (par ex. « découvrez », « choisissez ») : présent dans 37,47 % de toutes les réponses de Gemini. ✅ Emploi du conditionnel (par ex. « pourrait », « serait ») : présent dans 26,41 % de toutes les réponses de Gemini. ✅ Emploi de l’impératif (par ex. « essayez », « profitez ») : présent dans 32,69 % de toutes les réponses de Gemini.
Comment s’exprime Sonar ? ✅ Forme impersonnelle (par ex. « il est recommandé ») : présente dans 11,68 % de toutes les réponses de Sonar. ✅ Verbe incitatif (par ex. « découvrez », « choisissez ») : présent dans 17,52 % de toutes les réponses de Sonar. ✅ Emploi du conditionnel (par ex. « pourrait », « serait ») : présent dans 17,60 % de toutes les réponses de Sonar. ✅ Emploi de l’impératif (par ex. « essayez », « profitez ») : présent dans 16,35 % de toutes les réponses de Sonar. 💡 Enseignements : en tant que marketeurs, nous devons savoir comment ces outils s’expriment, pour deux raisons. D’abord, ces outils parlent à nos clients, et nous voulons comprendre plus précisément comment ils leur parlent. Ensuite, ces outils analysent notre site, et nous pourrions renforcer notre présence en nous exprimant comme eux (ce n’est qu’une hypothèse pour l’instant).
99 % des réponses utilisent « - » quand elles s’expriment. Cela signifie qu’une réponse type de LLM ressemble à ceci : Pour en savoir plus sur le football, vous devriez lire :
Cela veut-il dire que vous avez plus de chances d’être bien classé si vous utilisez « - » dans vos contenus ? Mieux vaut le tester 😉 Cela tend en tout cas à prouver que les LLM aiment les réponses structurées et les contenus qu’ils peuvent traiter et comprendre facilement.
Nous avons observé des différences nettes entre les modèles : Gemini tend à fournir des réponses plus longues et plus complètes, en citant davantage de concurrents, alors que SearchGPT est plus concis et plus sélectif dans ses citations. Cette distinction doit influencer la manière d’écrire et de structurer vos contenus selon la plateforme visée. Les expressions les plus fréquentes et les structures de discours révèlent elles aussi des schémas constants. Les LLM privilégient une communication prudente, structurée et souvent impersonnelle, avec de fréquentes recommandations ou formulations au conditionnel. En reprenant ces schémas linguistiques dans nos propres contenus, nous pourrions mieux nous aligner sur leurs critères de sélection implicites, une hypothèse qui mérite d’être explorée plus avant. Enfin, l’usage quasi systématique des puces (avec « - ») montre que les LLM préfèrent des formats clairs, organisés et faciles à assimiler. C’est une tactique simple mais puissante à intégrer dans toute stratégie de contenu à l’ère des moteurs de réponses. En bref, comprendre comment les LLM répondent est essentiel pour comprendre comment exister dans ce nouvel écosystème, et ce n’est que le début.
La deuxième partie de cette analyse porte sur toutes les sources utilisées par ces LLM. Nous sommes convaincus qu’il existe une grande opportunité de renforcer la présence de votre marque dans les LLM si vous parvenez à être présent sur leurs sources. Sur les 32 961 requêtes ajoutées sur Qwairy, les LLM ont cité 59 992 sources différentes. Nous avons mené deux analyses pour recueillir des données à ce sujet :
Nous avons aussi analysé le sujet des sources, et nous en tirons quelques enseignements.
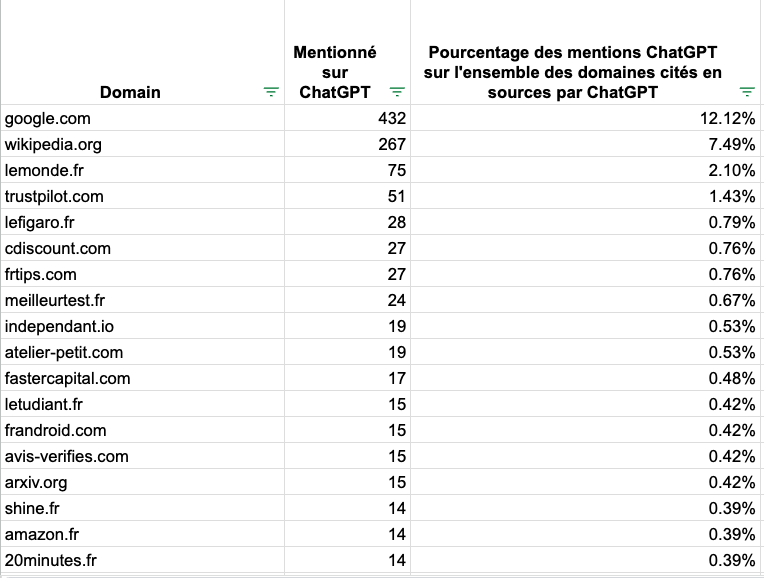
💡 Enseignements : sans grande surprise, Wikipedia est l’un des sites les plus utilisés par SearchGPT comme source. Wikipedia était l’une des principales Vous remarquerez aussi que Google est régulièrement utilisé comme source. Il s’agit surtout de sites comme Google Maps ou d’autres services Google.
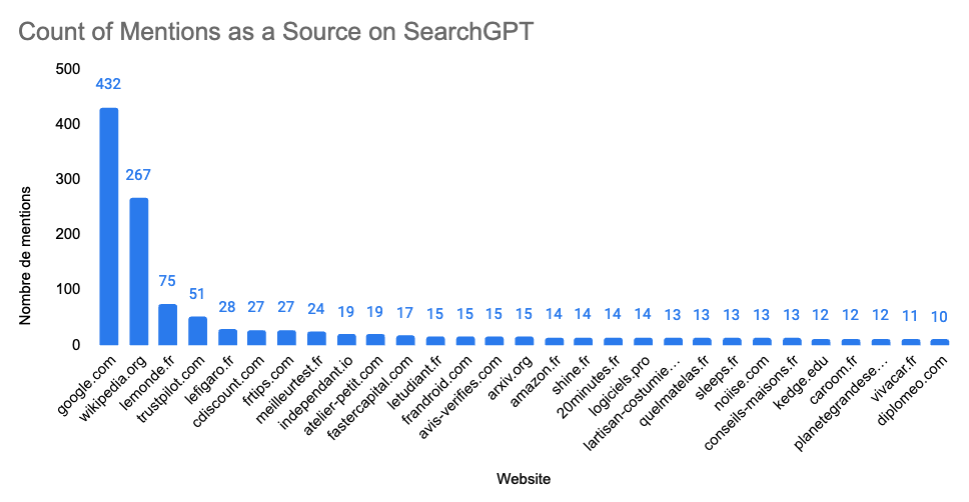
Lemonde est un quotidien français qui a un partenariat avec ChatGPT. D’autres journaux comme lefigaro ou letudiant sont très présents parmi les sources. Enfin, SearchGPT adore les sites comparateurs comme Trustpilot ou Avis Vérifiés. Avertissement : pour le moment, nous n’avons que 6 000 sources pour SearchGPT. Les données sont moins nombreuses que pour les autres LLM, car nous avons eu des difficultés à récupérer les sources au début de notre utilisation.
Nombre de domaines uniques cités par SearchGPT : 3 557
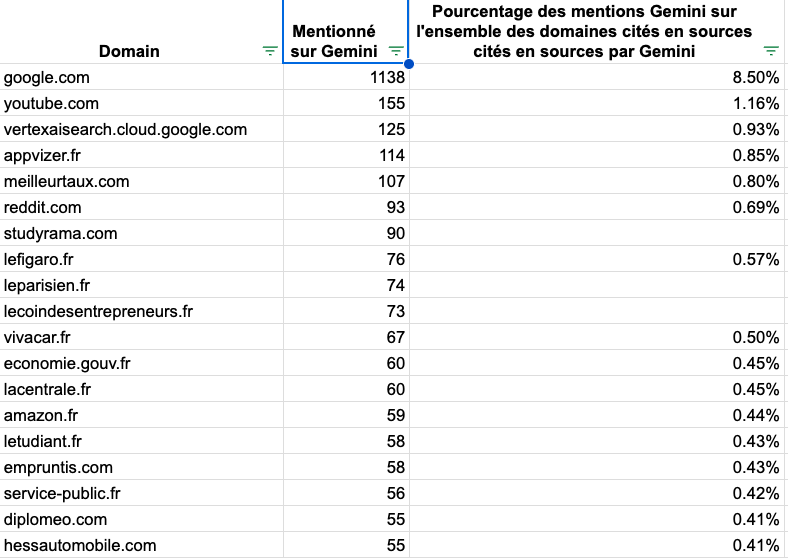
Avec Gemini, c’est différent. 💡 Enseignements : d’abord, et ce n’est pas une grande surprise, la plupart des domaines de Google sont les plus cités. Google.com désigne des services Google. Et YouTube appartient à Google, au cas où vous l’auriez oublié. Autre différence avec SearchGPT : on voit apparaître des sites de services publics français. Google a toujours tenu à bien positionner ces sites, en particulier dans le contexte du YMYL. Enfin, vous pouvez aussi voir apparaître Reddit et de nombreux autres médias indépendants français (lecoindesentrepreneurs.fr, studyrama). Ces médias travaillent leur SEO depuis des années, et il semble que cela leur profite.
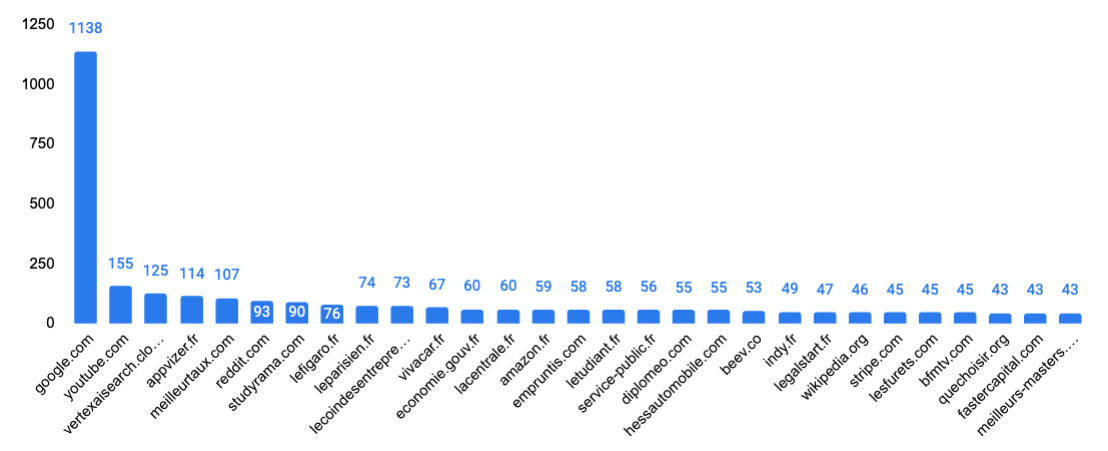
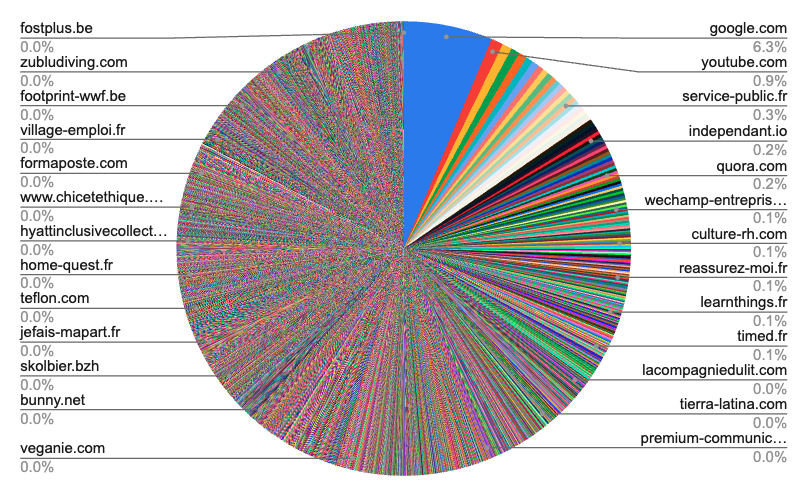
Nombre de domaines uniques cités par Gemini : 13 388
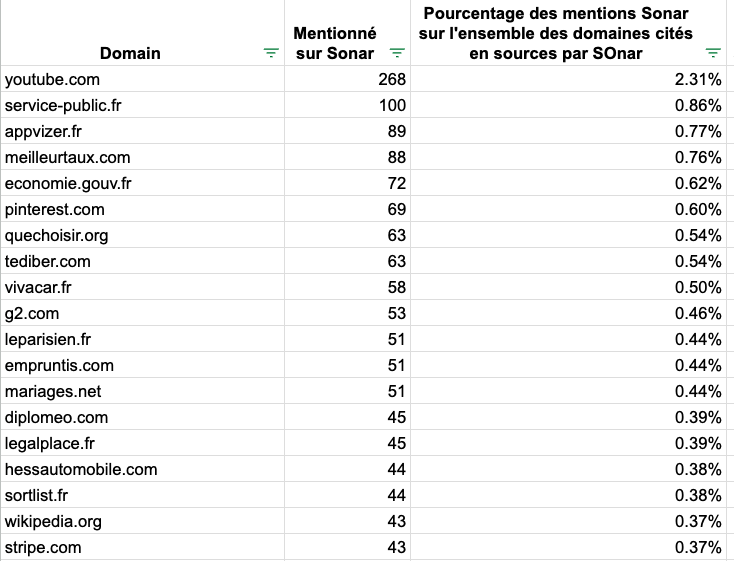
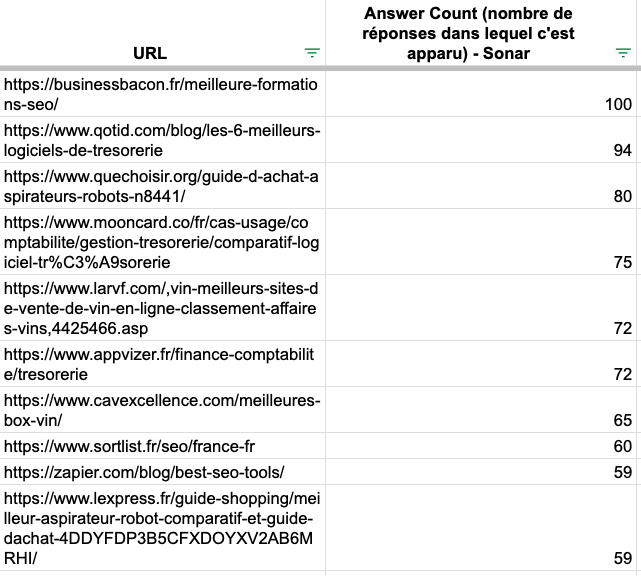
Perplexity se distingue nettement dans son usage des sources. La première chose que nous avons constatée, c’est que YouTube est la source la plus utilisée : Perplexity semble aimer afficher des vidéos YouTube, et si vous voulez mieux apparaître dans son service, mieux vaut vous mettre à YouTube au plus vite. Ensuite, nous avons constaté que les domaines utilisés par Perplexity sont plus diversifiés que ceux des autres modèles. Aucun domaine n’est utilisé plus que les autres. Nombre de domaines uniques cités par Sonar : 11 591
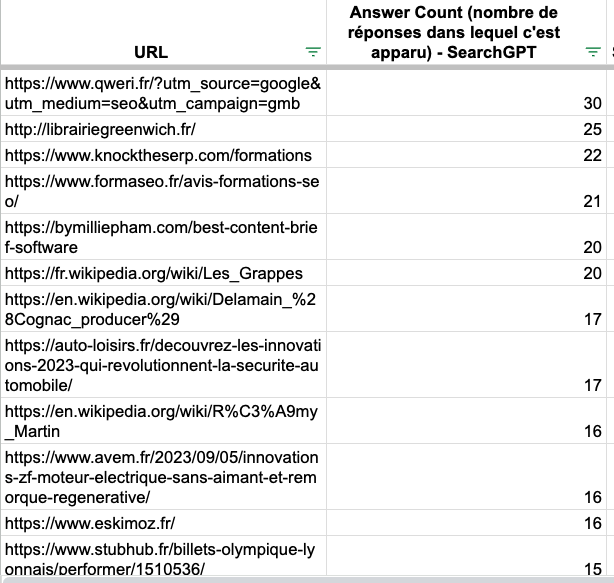
Vous serez peut-être surpris de voir apparaître des sites dont vous n’avez jamais entendu parler. Au niveau de l’URL, cela peut arriver si un client ajoute plusieurs fois une requête très similaire. Imaginons une agence SEO à Paris qui ajoute toutes les questions suivantes sur Qwairy :
La même source peut revenir plusieurs fois. Nous pensons pouvoir présenter davantage de données dans la prochaine analyse, le trimestre prochain, qui contiendra plus de données (nous visons au moins 100 000 réponses, contre 32 000 pour celle-ci). Cette analyse nous aide néanmoins déjà à comprendre de nombreux points intéressants. D’abord, Wikipedia revient souvent comme référence.
Détaillez votre visibilité modèle par modèle pour voir où chaque IA vous mentionne, et où elle ne le fait pas.
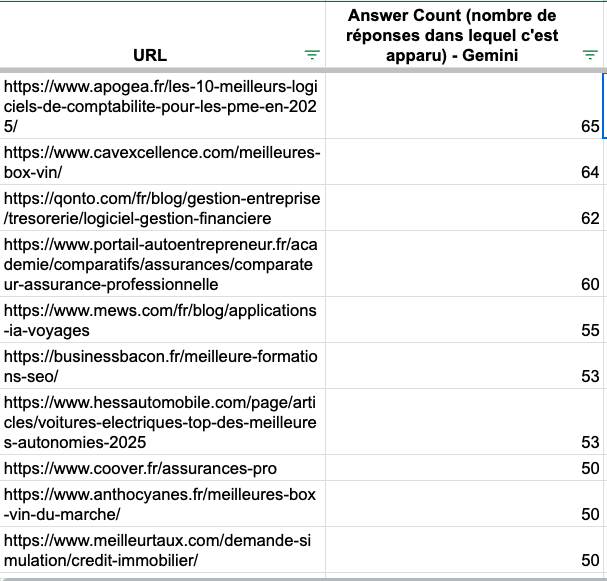
Sur Gemini, les sources semblent provenir davantage d’articles de blog traditionnels.
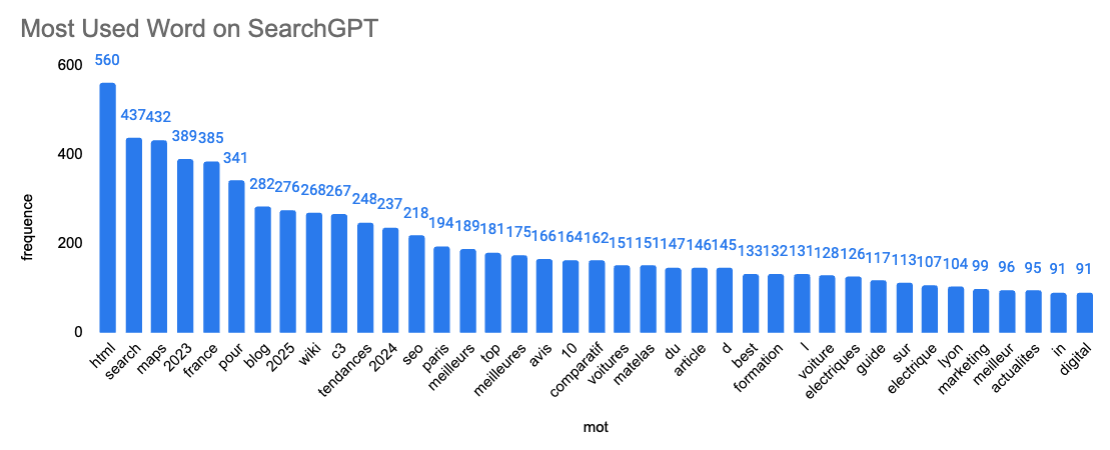
Pour compléter cette étude, nous avons décidé d’analyser le slug de chaque URL afin de voir quels mots reviennent le plus. Commençons par ChatGPT.
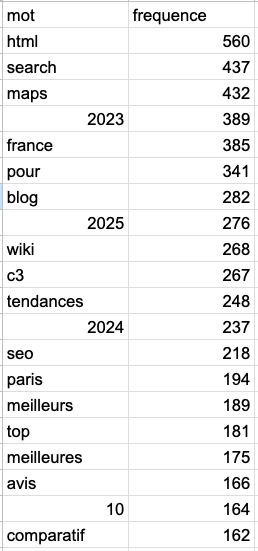
💡 Enseignements : de nombreuses URL contiennent encore 2023 dans leur slug. Il est intéressant de le constater : la plupart des modèles sont entraînés sur des données passées, et il semble que ChatGPT, plus que les autres, réutilise des données de 2023. Cela ne veut évidemment pas dire qu’il faut ajouter 2023 à votre slug pour être cité comme source par SearchGPT 😅 Enfin, des termes comme « meilleurs » et « top » reviennent régulièrement.
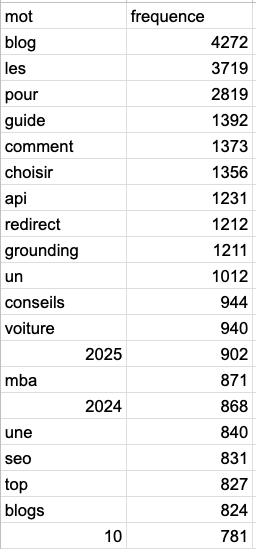
Ici, les données sont légèrement différentes. On voit que Gemini utilise davantage d’URL dont le slug contient des mots comme « guide » ou « comment », voire « choisir ».
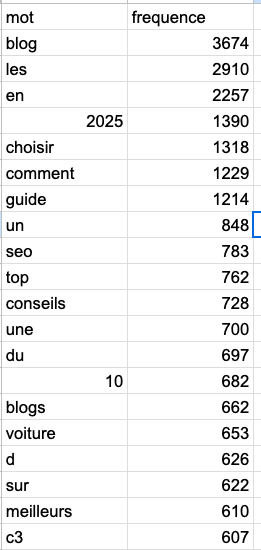
2025 domine sur Perplexity, ce qui pourrait indiquer que Perplexity préfère les contenus récents.
6 037 sources (domaines) sont utilisées par Sonar et Gemini sur un total de plus de 13 000 sources 1 383 sources sont communes entre ChatGPT et Gemini 1 321 sources sont communes entre ChatGPT et Sonar sur un total de 2 557 sources
Avec plus de 32 000 requêtes analysées et près de 60 000 sources examinées, cette étude explore les facteurs de classement dans les LLM à partir des modèles et des réponses API étudiés fin 2024 et début 2025. Elle montre que les réponses et les sources varient selon le modèle. Dans ce nouveau paysage, des moteurs comme SearchGPT, Gemini et Perplexity ne renvoient plus une liste de 10 liens bleus. Ils génèrent des réponses directes. L’enjeu n’est plus de se classer haut, mais d’être mentionné dans la réponse.
Les LLM ne cherchent pas seulement à vous citer, ils cherchent à vous comprendre. Cela signifie parler leur langage, structurer vos contenus comme les leurs et être visible là où ils puisent leurs réponses.
Pour les marketeurs, cela ouvre à la fois des opportunités et des responsabilités :
Cette étude n’est que le début. Nous prévoyons de la mettre à jour chaque trimestre, avec plus de données et des enseignements plus précis. Chez Qwairy, notre mission est de donner aux CMO, aux SEO et aux équipes marketing le playbook de la visibilité à l’ère des moteurs de réponses.
Suivez les questions qui comptent pour votre activité, voyez quelles marques chaque réponse mentionne et quelles sources elle cite, puis travaillez sur les manques.
Offre gratuite avec 120 crédits initiaux • Sans carte bancaire
Autres articles
AI Overviews en France : ce que Google cite vraiment, face aux États-Unis
Qwairy et Converteo ont analysé 12 120 réponses AI Overviews en France et aux États-Unis : requêtes déclenchantes, sources citées, autorité et volatilité.
Questions de suivi IA : la première réponse n’est pas la décision
72 % des réponses IA invitent à poser une autre question, et la présélection se rebat quand l’acheteur répond. Le benchmark Qwairy montre ce que décide ce tour.