Loading page

Étude LLM de 2025 : 184 128 requêtes et 1 479 145 sources sur 20 modèles. Découvrez les écarts de citation et de visibilité mesurés dans les réponses IA.

Quand nous avons publié notre première étude sur 32 961 requêtes (T2 2025), la réponse a dépassé toutes nos attentes. Des marketeurs du monde entier nous ont écrit pour réclamer plus de données, plus de modèles et plus d’enseignements. Trois mois plus tard, nous revenons avec une étude 5,6 fois plus grande.
Nous avons analysé 184 128 requêtes, soit 459 % de données en plus que dans notre étude initiale, sur les modèles de LLM étudiés en 2025, dont Mistral, DeepSeek, Grok et GPT-5, suivis pour la première fois. Les résultats et recommandations de cette étude décrivent les modèles et les requêtes observés entre juillet et octobre 2025. Les comportements des moteurs et leurs sources peuvent évoluer depuis cette période. Mais il ne s’agit pas seulement d’échelle. Cette étude introduit des dimensions d’analyse totalement inédites :
Le paysage de la recherche IA évolue plus vite que personne ne l’avait prévu. Le week-end dernier, j’ai surpris dans un café une conversation qui résume parfaitement ce basculement :
« Je vais demander à ChatGPT quel restaurant tester. » Pas à Google. À ChatGPT. C’est la nouvelle réalité. La recherche est en train d’être réinventée, et les marques qui ne s’adaptent pas disparaîtront tout simplement de la liste des options envisagées par les consommateurs. Chez Qwairy, notre mission est de vous donner les données dont vous avez besoin pour gagner dans ce nouveau paysage grâce à l’optimisation pour les moteurs génératifs (GEO). Cette étude, ce sont 1 479 145 sources analysées, 20 modèles de LLM suivis, 106 % de croissance mensuelle et d’innombrables heures d’analyse pour vous livrer des enseignements exploitables. Si le GEO est nouveau pour vous, nous vous recommandons de lire notre guide complet pour comprendre les crawlers IA et GEO vs SEO : quelle différence ? pour avoir une vue d’ensemble. Entrons dans le vif du sujet.
Toutes les données ont été générées avec Qwairy, notre plateforme de GEO (Generative Engine Optimization) conçue pour aider les marques à améliorer leur présence dans les réponses générées par les LLM. Le jeu de données comprend :
Notre analyse couvre 20 modèles de LLM répartis sur 8 grandes plateformes d’IA :
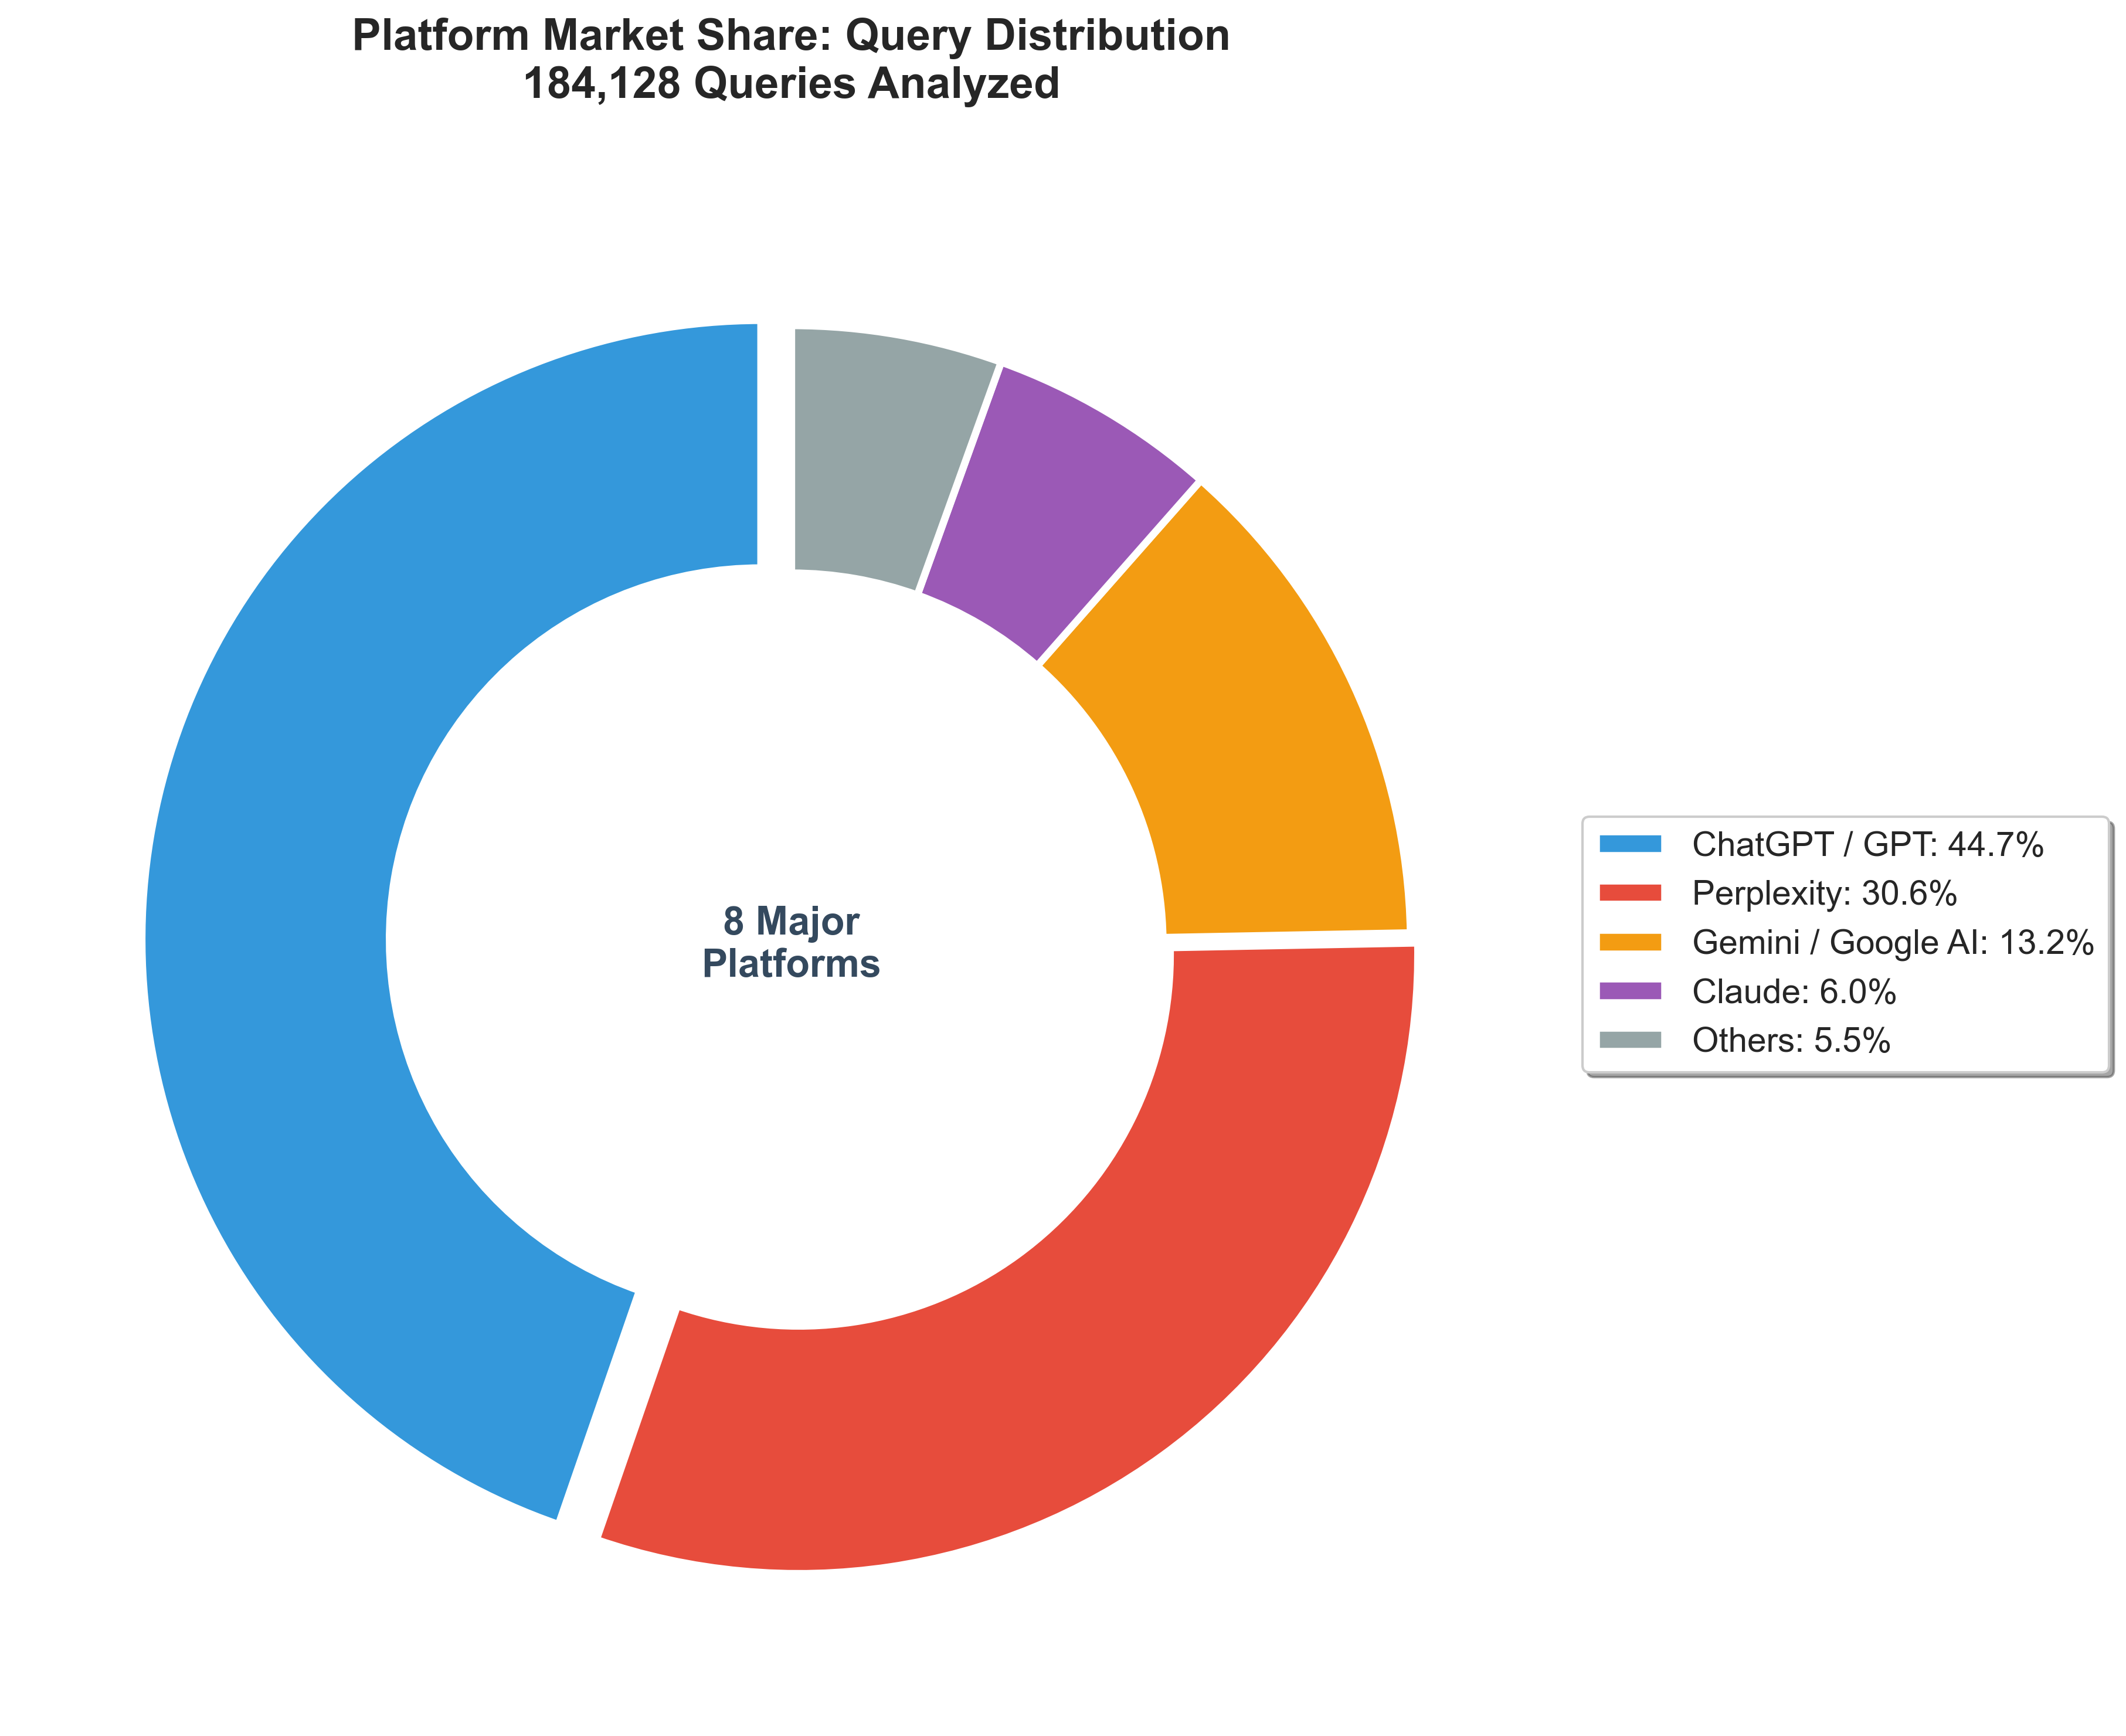
ChatGPT / GPT (OpenAI) : 82 268 requêtes (44,7 %)
Perplexity : 56 250 requêtes (30,6 %)
Gemini / Google AI (Google) : 24 344 requêtes (13,2 %)
Claude (Anthropic) : 11 120 requêtes (6,0 %)
Microsoft Copilot : 5 566 requêtes (3,0 %)
Grok (xAI) : 4 100 requêtes (2,2 %)
Mistral : 347 requêtes (0,2 %)
DeepSeek : 133 requêtes (0,1 %)
Pour en savoir plus sur l’optimisation pour chaque plateforme, consultez nos guides sur comment se positionner dans ChatGPT et comment améliorer sa visibilité sur Perplexity.
Comme tout jeu de données, le nôtre comporte des biais inhérents :
Notre objectif : donner aux directeurs marketing (CMO), aux responsables SEO et aux professionnels du marketing des enseignements fondés sur les données pour naviguer dans la révolution de la recherche IA. Nous ne prétendons pas avoir résolu la question du classement dans les LLM. Mais nous sommes convaincus que ces données peuvent améliorer concrètement la visibilité IA de votre marque.
Premier enseignement essentiel : tous les LLM ne se comportent pas de la même façon. Comprendre comment chaque modèle structure ses réponses est indispensable pour concevoir des contenus qui fonctionnent sur des plateformes précises.
L’une des différences les plus frappantes entre les modèles tient à la quantité qu’ils en disent.
Modèle | Caractères en moyenne | Équivalent en mots | Style |
Google AI Overview | 6 174 | 1 235 à 1 544 | Très détaillé |
ChatGPT Core | 5 650 | 1 130 à 1 413 | Complet |
Grok | 5 249 | 1 050 à 1 312 | Équilibré |
Gemini Core | 3 896 | 779 à 974 | Modéré |
Perplexity Core | 3 409 | 682 à 852 | Modéré |
Gemini 2.0 Flash | 2 963 | 593 à 741 | Concis |
Microsoft Copilot | 2 562 | 512 à 641 | Concis |
GPT-4o-mini | 2 524 | 505 à 631 | Très concis |
Perplexity Sonar | 2 233 | 447 à 558 | Très concis |
Claude 3.7 Sonnet | 1 059 | 212 à 265 | Ultra-concis |
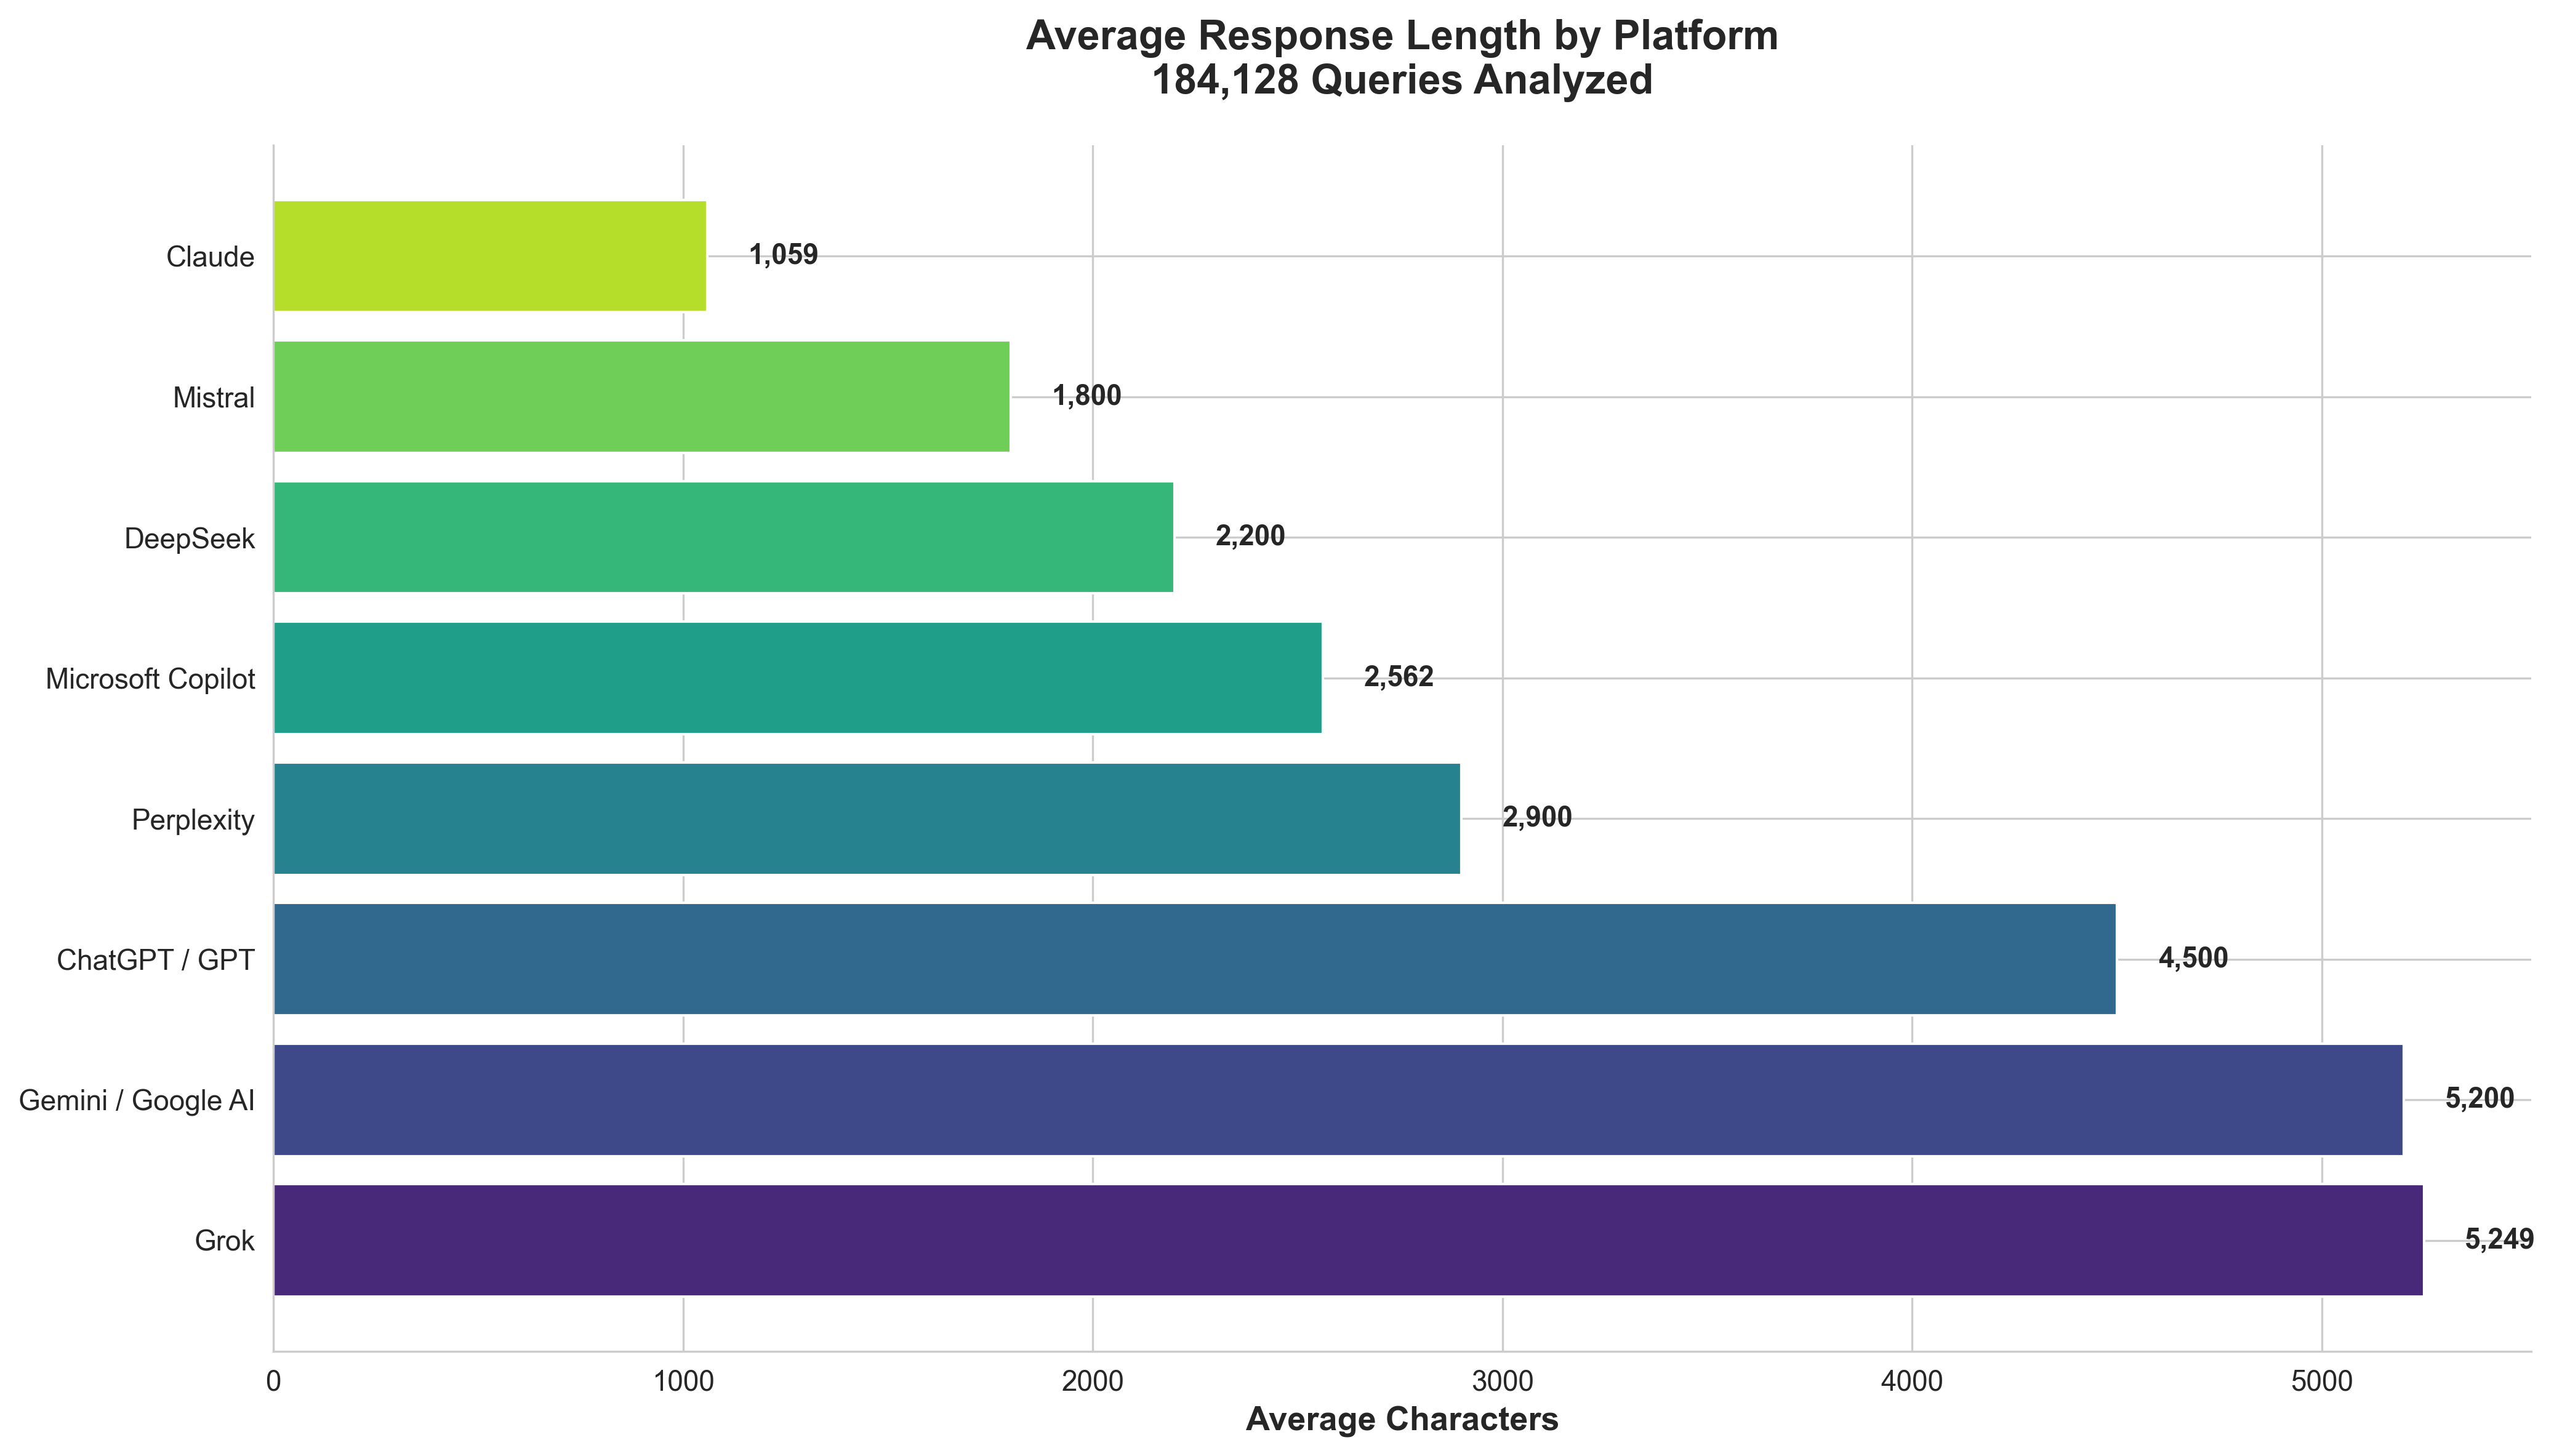
💡 Enseignement clé : Claude 3.7 Sonnet est 6 fois plus concis que Google AI Overview. Si vous optimisez pour Claude, la concision est déterminante. Pour Google AI Overview, ce sont les contenus complets et détaillés qui gagnent. 💡 Comparaison avec l’étude précédente : les réponses de ChatGPT sont devenues 235 % plus longues (de 1 687 à 5 650 caractères), ce qui suggère une tendance vers des réponses plus détaillées.
À l’ère de la recherche IA, l’enjeu n’est plus de figurer dans le « top 10 ». Il s’agit d’être explicitement mentionné dans la réponse.
Plateforme | Concurrents moyens par requête | Approche | Évolution par rapport à l’étude précédente |
Mistral | 11,69 | La plus exhaustive jamais mesurée | NOUVEAU |
Grok | 7,94 | Très complète | NOUVEAU |
ChatGPT / GPT | 3,54 | Complète | Comparaison T2/T3 non établie sur la même métrique |
Gemini / Google AI | 3,18 | Équilibrée | Stable (~3,77 au T2) |
Claude | 2,77 | Équilibrée | Stable |
Microsoft Copilot | 2,75 | Équilibrée | Stable |
Perplexity | 1,38 | Sélective | Stable |
DeepSeek | 5,72 | Complète | NOUVEAU |
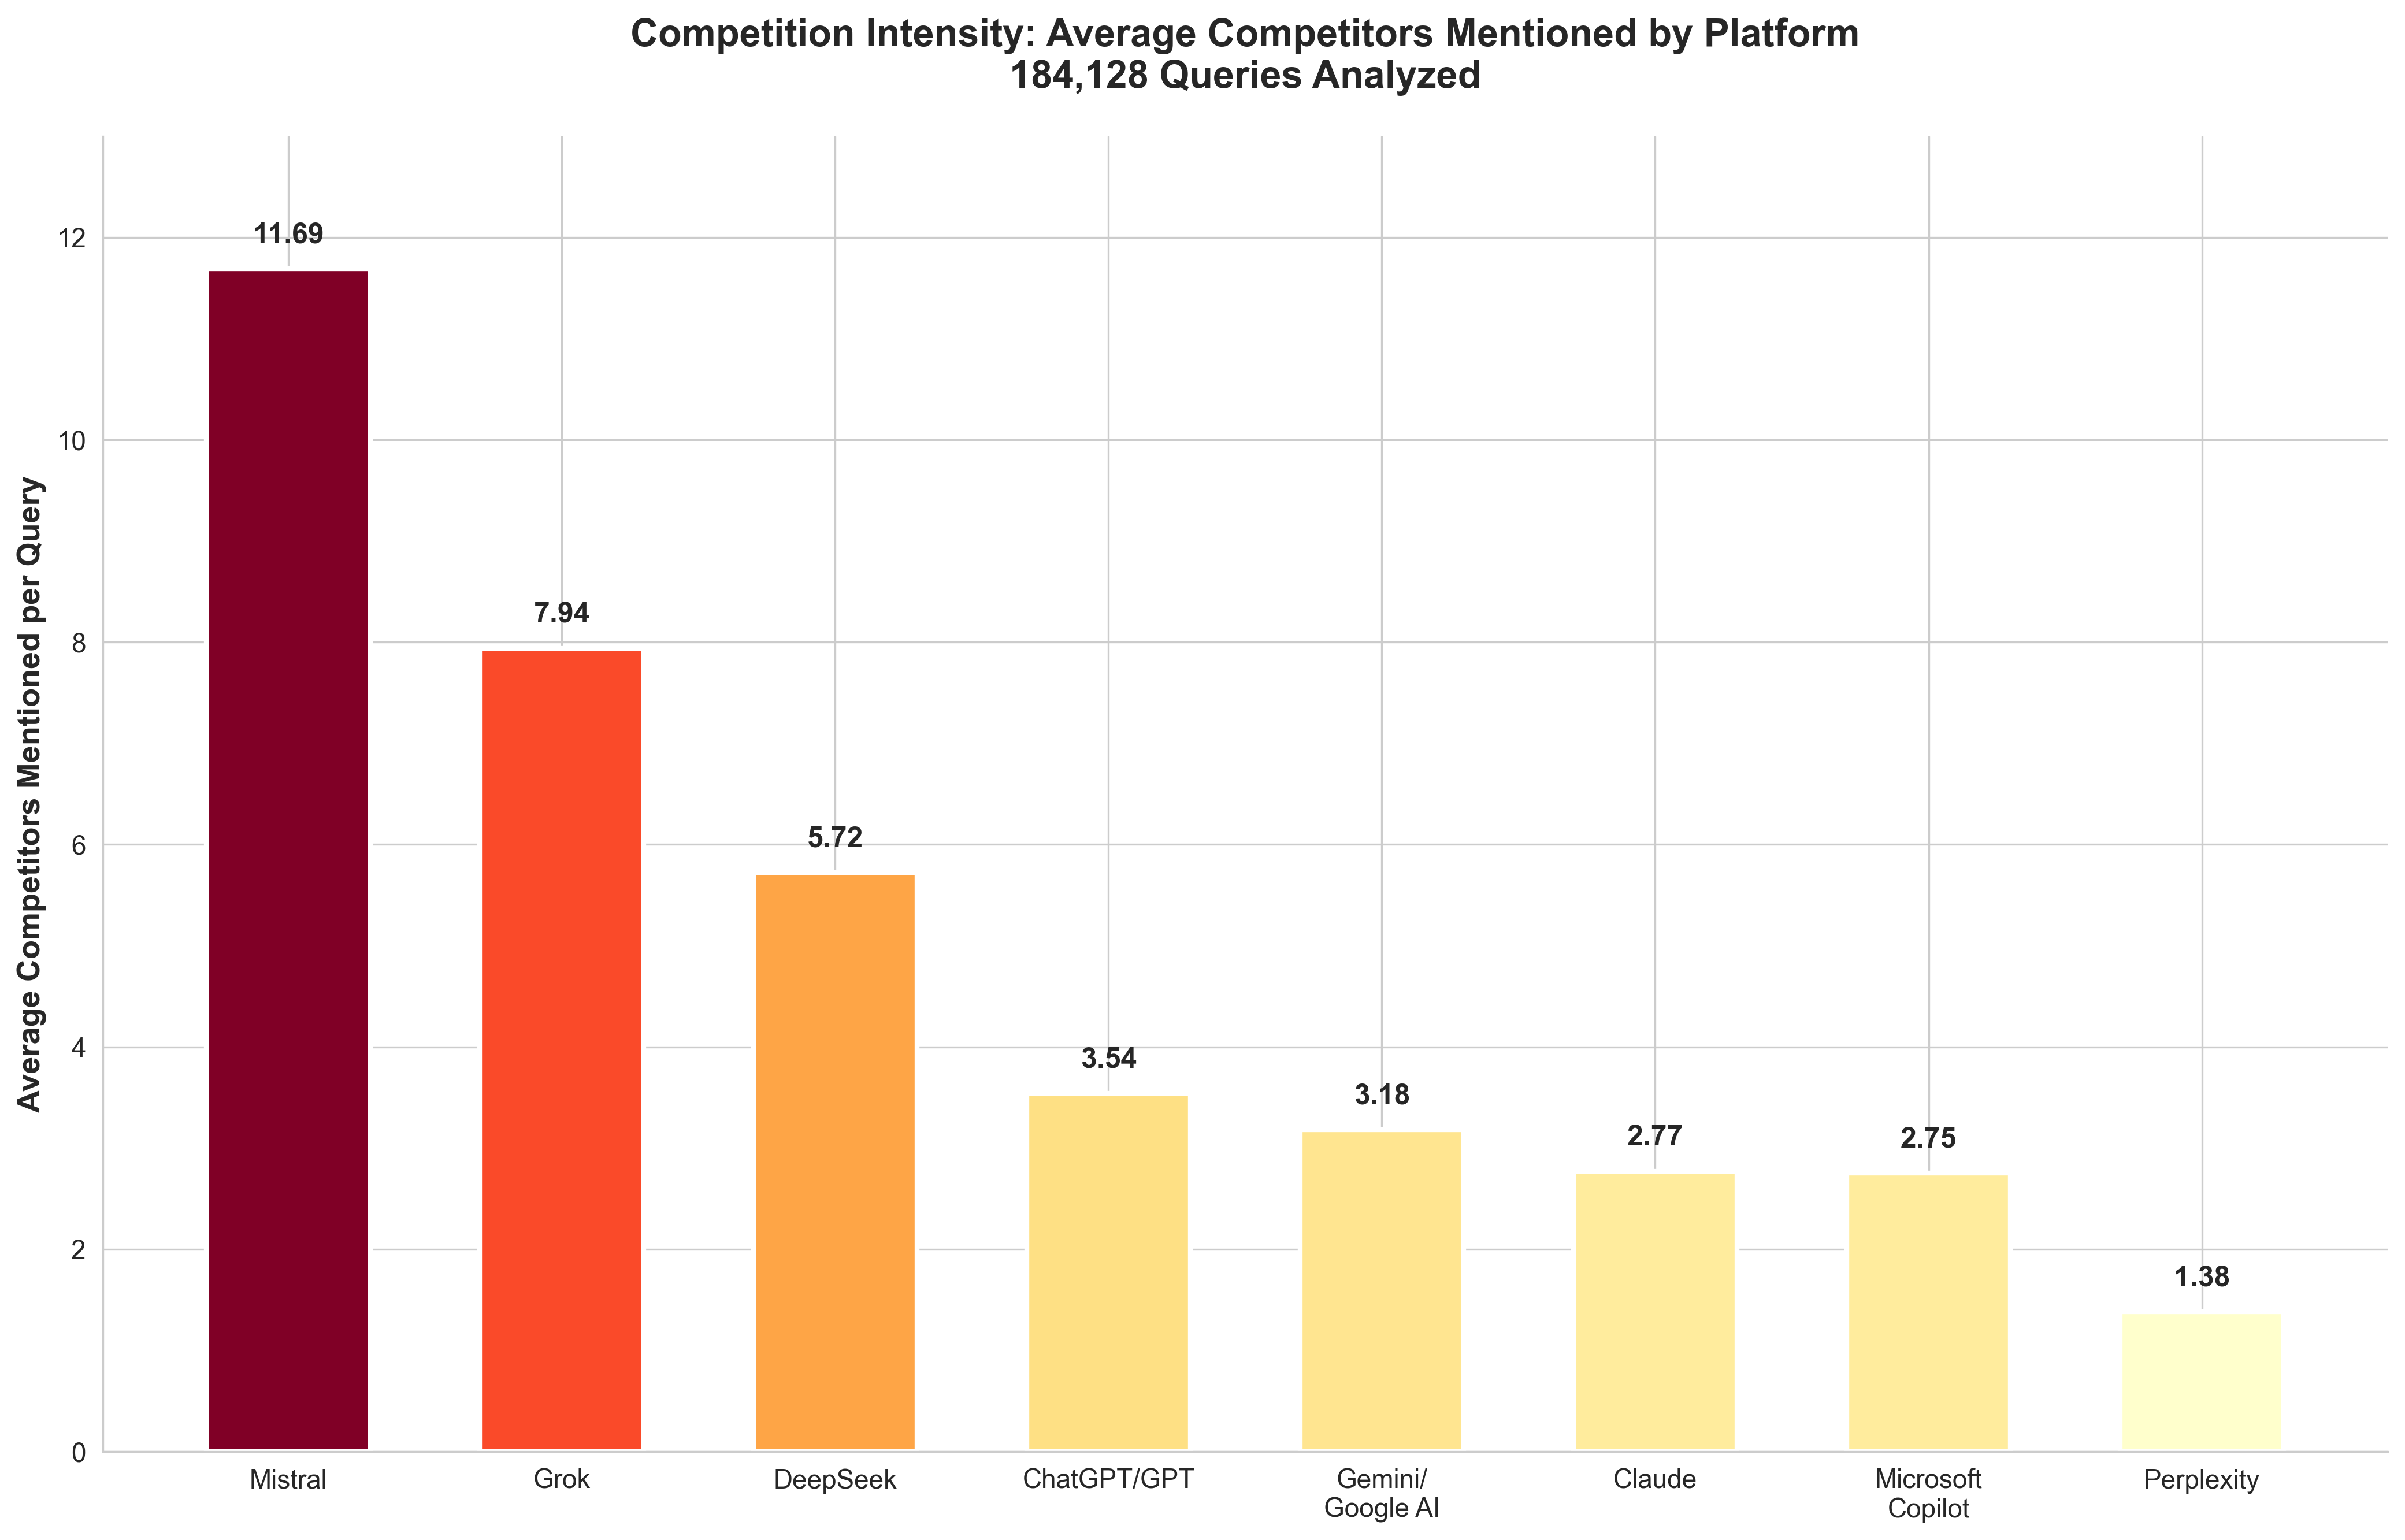
💡 Mesure du T3 : la plateforme ChatGPT/GPT mentionnait en moyenne 3,54 concurrents par requête; ChatGPT Core, 4,78. La valeur de 0,81 publiée au T2 portait sur les sources, avec une collecte alors incomplète. Elle ne permet pas de calculer une évolution du nombre de concurrents ni d’en déduire un changement de stratégie d’OpenAI. 💡 NOUVEAU RECORD : Mistral mentionne 11,69 concurrents par requête, le plus haut niveau que nous ayons jamais mesuré. Si vous visez Mistral, attendez-vous à une concurrence FÉROCE, avec plus de 10 alternatives citées. 💡 Enseignement stratégique : le paysage concurrentiel s’est intensifié sur toutes les plateformes. Seul Perplexity reste très sélectif (1,38 en moyenne). Sur des plateformes comme Mistral, Grok et ChatGPT, la position est CRITIQUE : 3 à 12 autres concurrents sont mentionnés.
Les tournures de langage révèlent la façon dont les LLM « pensent ». En analysant les expressions les plus employées, nous pouvons optimiser nos contenus pour qu’ils reproduisent ces schémas.
GPT-4o-mini (français) :
Gemini 2.0 Flash (français) :
Perplexity Sonar (français) :
Claude 3.7 Sonnet (français) :
Google AI Overview :
ChatGPT Core :
Grok :
💡 Enseignement clé : les LLM privilégient un langage prudent, de conseil. Des mots comme « recommandé », « should », « could » et « try » installent un ton consultatif plutôt que des affirmations définitives. 💡 Stratégie de contenu : intégrez ces expressions naturellement dans vos contenus. Employez des formulations au conditionnel (« vous pourriez envisager ») plutôt que des affirmations absolues (« vous devez faire »).
Nous avons analysé quatre schémas linguistiques sur l’ensemble des modèles :
1. Forme impersonnelle (par exemple « il est recommandé »)
2. Verbes incitatifs (par exemple « découvrez », « choisissez »)
3. Formulations au conditionnel (par exemple « pourrait », « serait »)
4. Mode impératif (par exemple « essayez », « profitez »)
💡 Enseignement clé : Gemini 2.0 Flash emploie le langage le plus formel et le plus prudent. Perplexity Sonar est le plus direct. 💡 Hypothèse : écrire dans un style qui reflète celui du LLM que vous ciblez peut améliorer votre visibilité. Testez-le dans vos contenus.
99 % des réponses des LLM utilisent des puces (-) pour structurer l’information. Une réponse typique de LLM ressemble à ceci : Pour en savoir plus sur le football, vous devriez lire :
💡 Enseignement clé : les LLM adorent les contenus structurés et faciles à parcourir. Utilisez des puces, des listes numérotées et des hiérarchies claires dans vos contenus.
Principaux enseignements :
Comprendre comment les LLM communiquent est la première étape pour figurer dans leurs réponses.
Cette étude introduit cinq dimensions d’analyse révolutionnaires qui n’avaient jamais été mesurées à cette échelle. Ces enseignements changent fondamentalement la façon dont nous devons aborder l’optimisation pour la recherche IA.
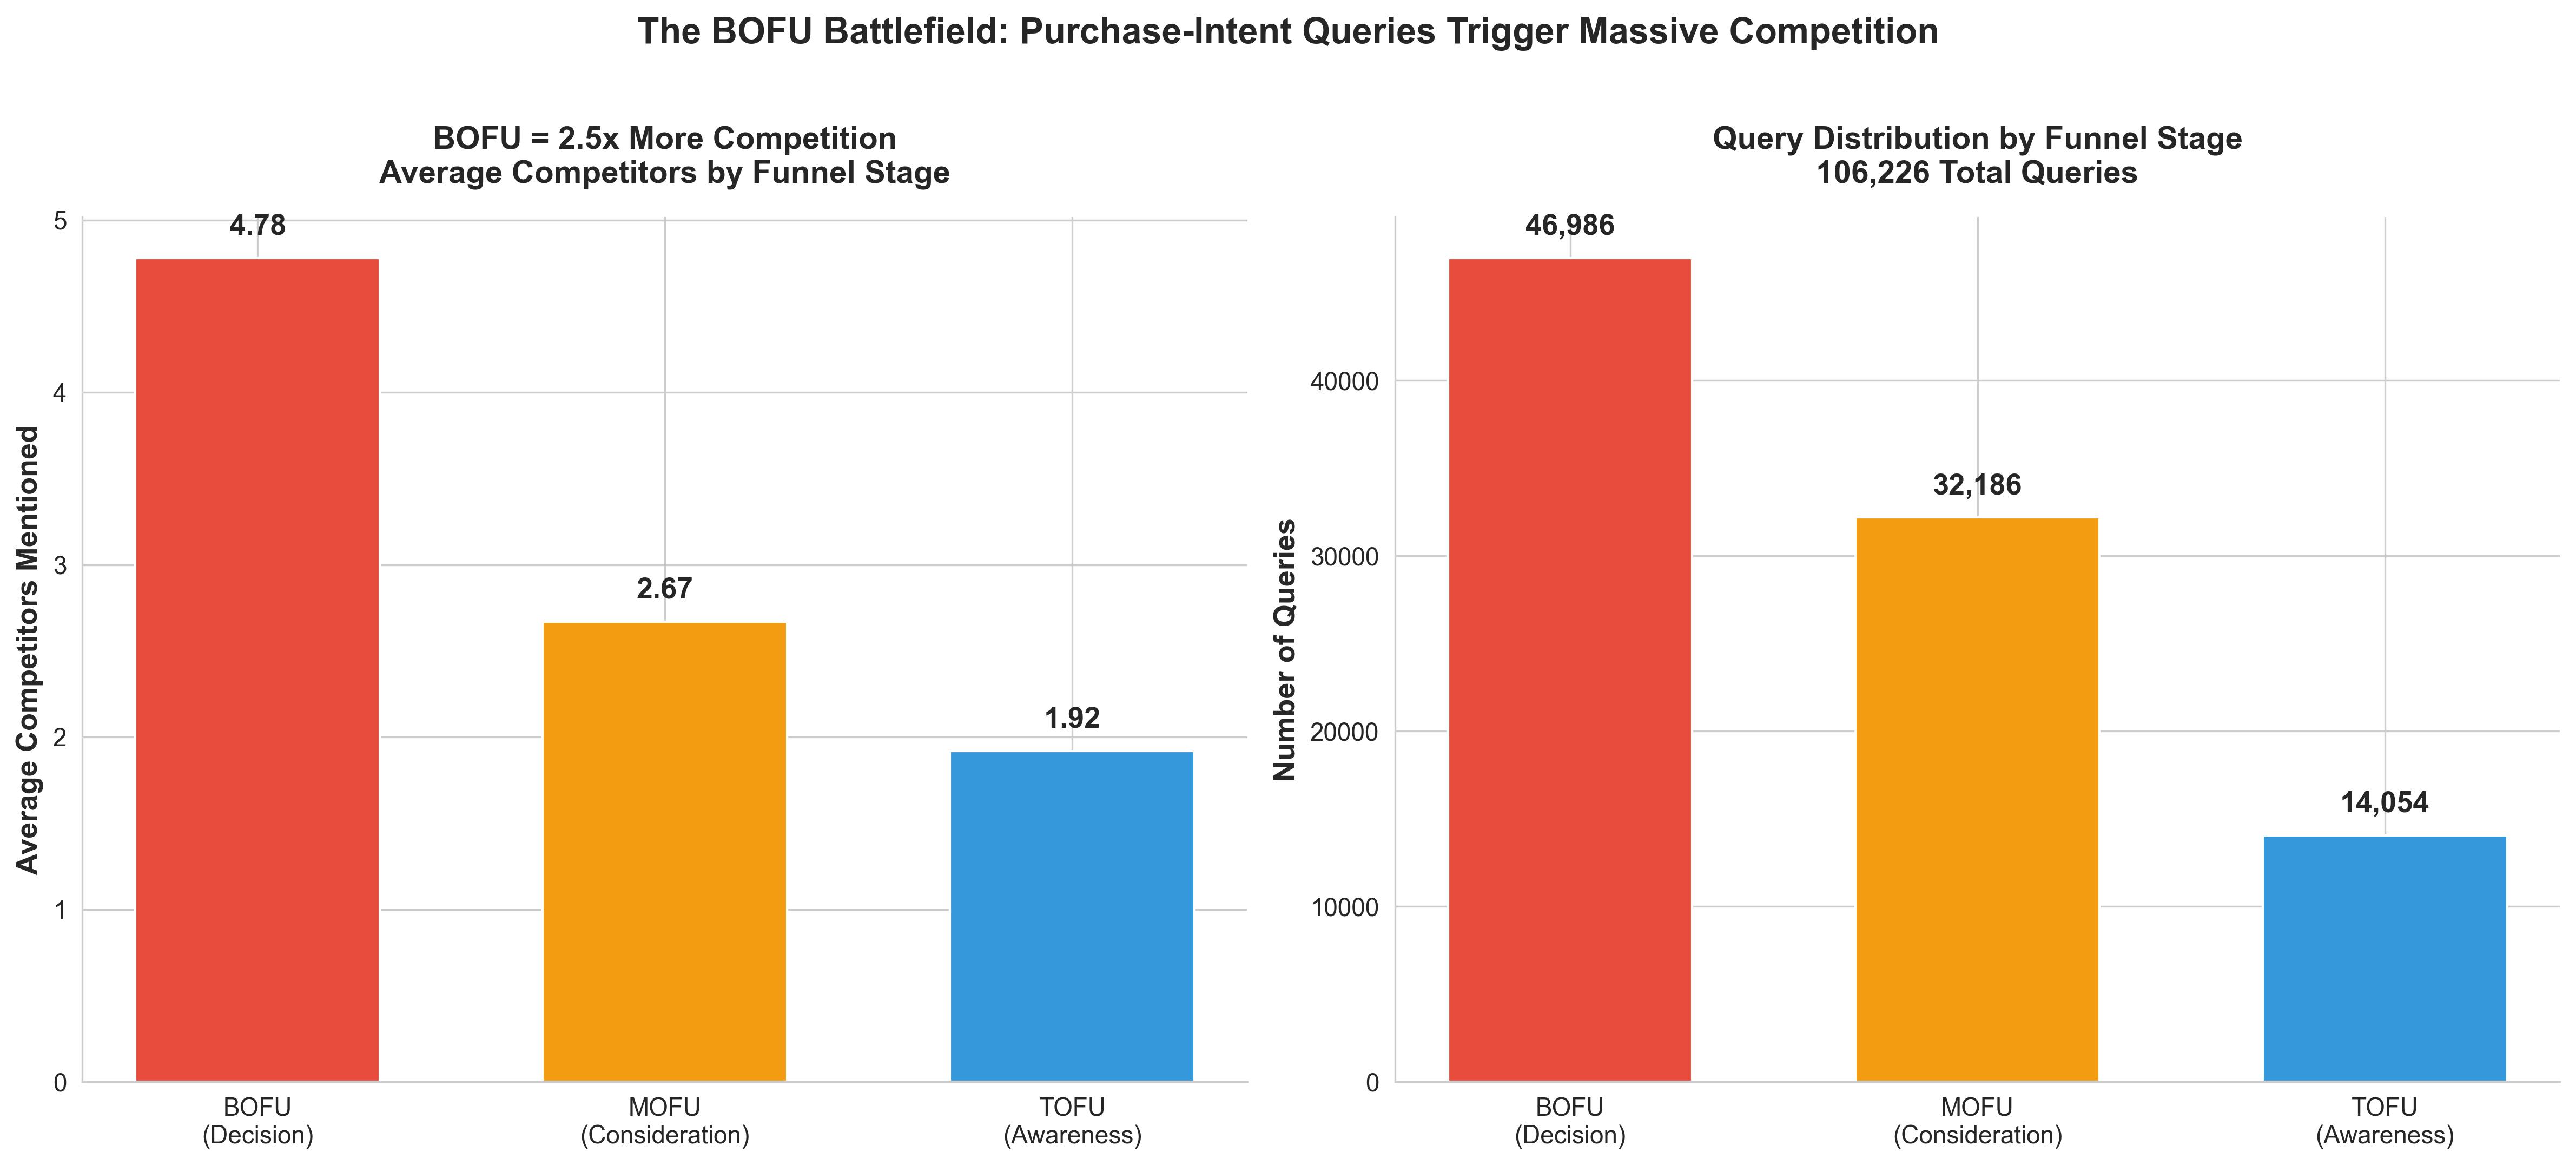
Nous avons analysé comment les mentions de concurrents évoluent selon l’intention de la requête, en classant les requêtes en trois catégories :
Les résultats sont stupéfiants :
Étape du tunnel | Requêtes | Concurrents moyens | Sources moyennes | Niveau de concurrence |
BOFU | 46 986 | 4,78 | 2,47 | CHAMP DE BATAILLE |
MOFU | 32 186 | 2,67 | 2,43 | Modéré |
TOFU | 14 054 | 1,92 | 2,86 | Faible |
INCONNU | 12 778 | 3,57 | 3,48 | Variable |
💡 DÉCOUVERTE RÉVOLUTIONNAIRE : plus un utilisateur est proche d’une décision d’achat, PLUS les LLM mentionnent de concurrents. Les requêtes BOFU déclenchent 2,5 fois plus de mentions de concurrents que les requêtes TOFU. 💡 Le paradoxe : les requêtes TOFU citent PLUS de sources (2,86 contre 2,47) mais MOINS de concurrents. Pourquoi ? Parce que les requêtes informatives ont besoin de sources variées pour être crédibles, alors que les requêtes commerciales sont un terrain de bataille concurrentiel où les LLM présentent plusieurs alternatives. 💡 Implication stratégique : si vous ne vous positionnez pas sur les requêtes BOFU, vous êtes invisible au moment qui compte le plus. Les utilisateurs qui recherchent « [catégorie] : les meilleurs » ou des comparatifs « [marque] vs [marque] » ne vous découvriront jamais.
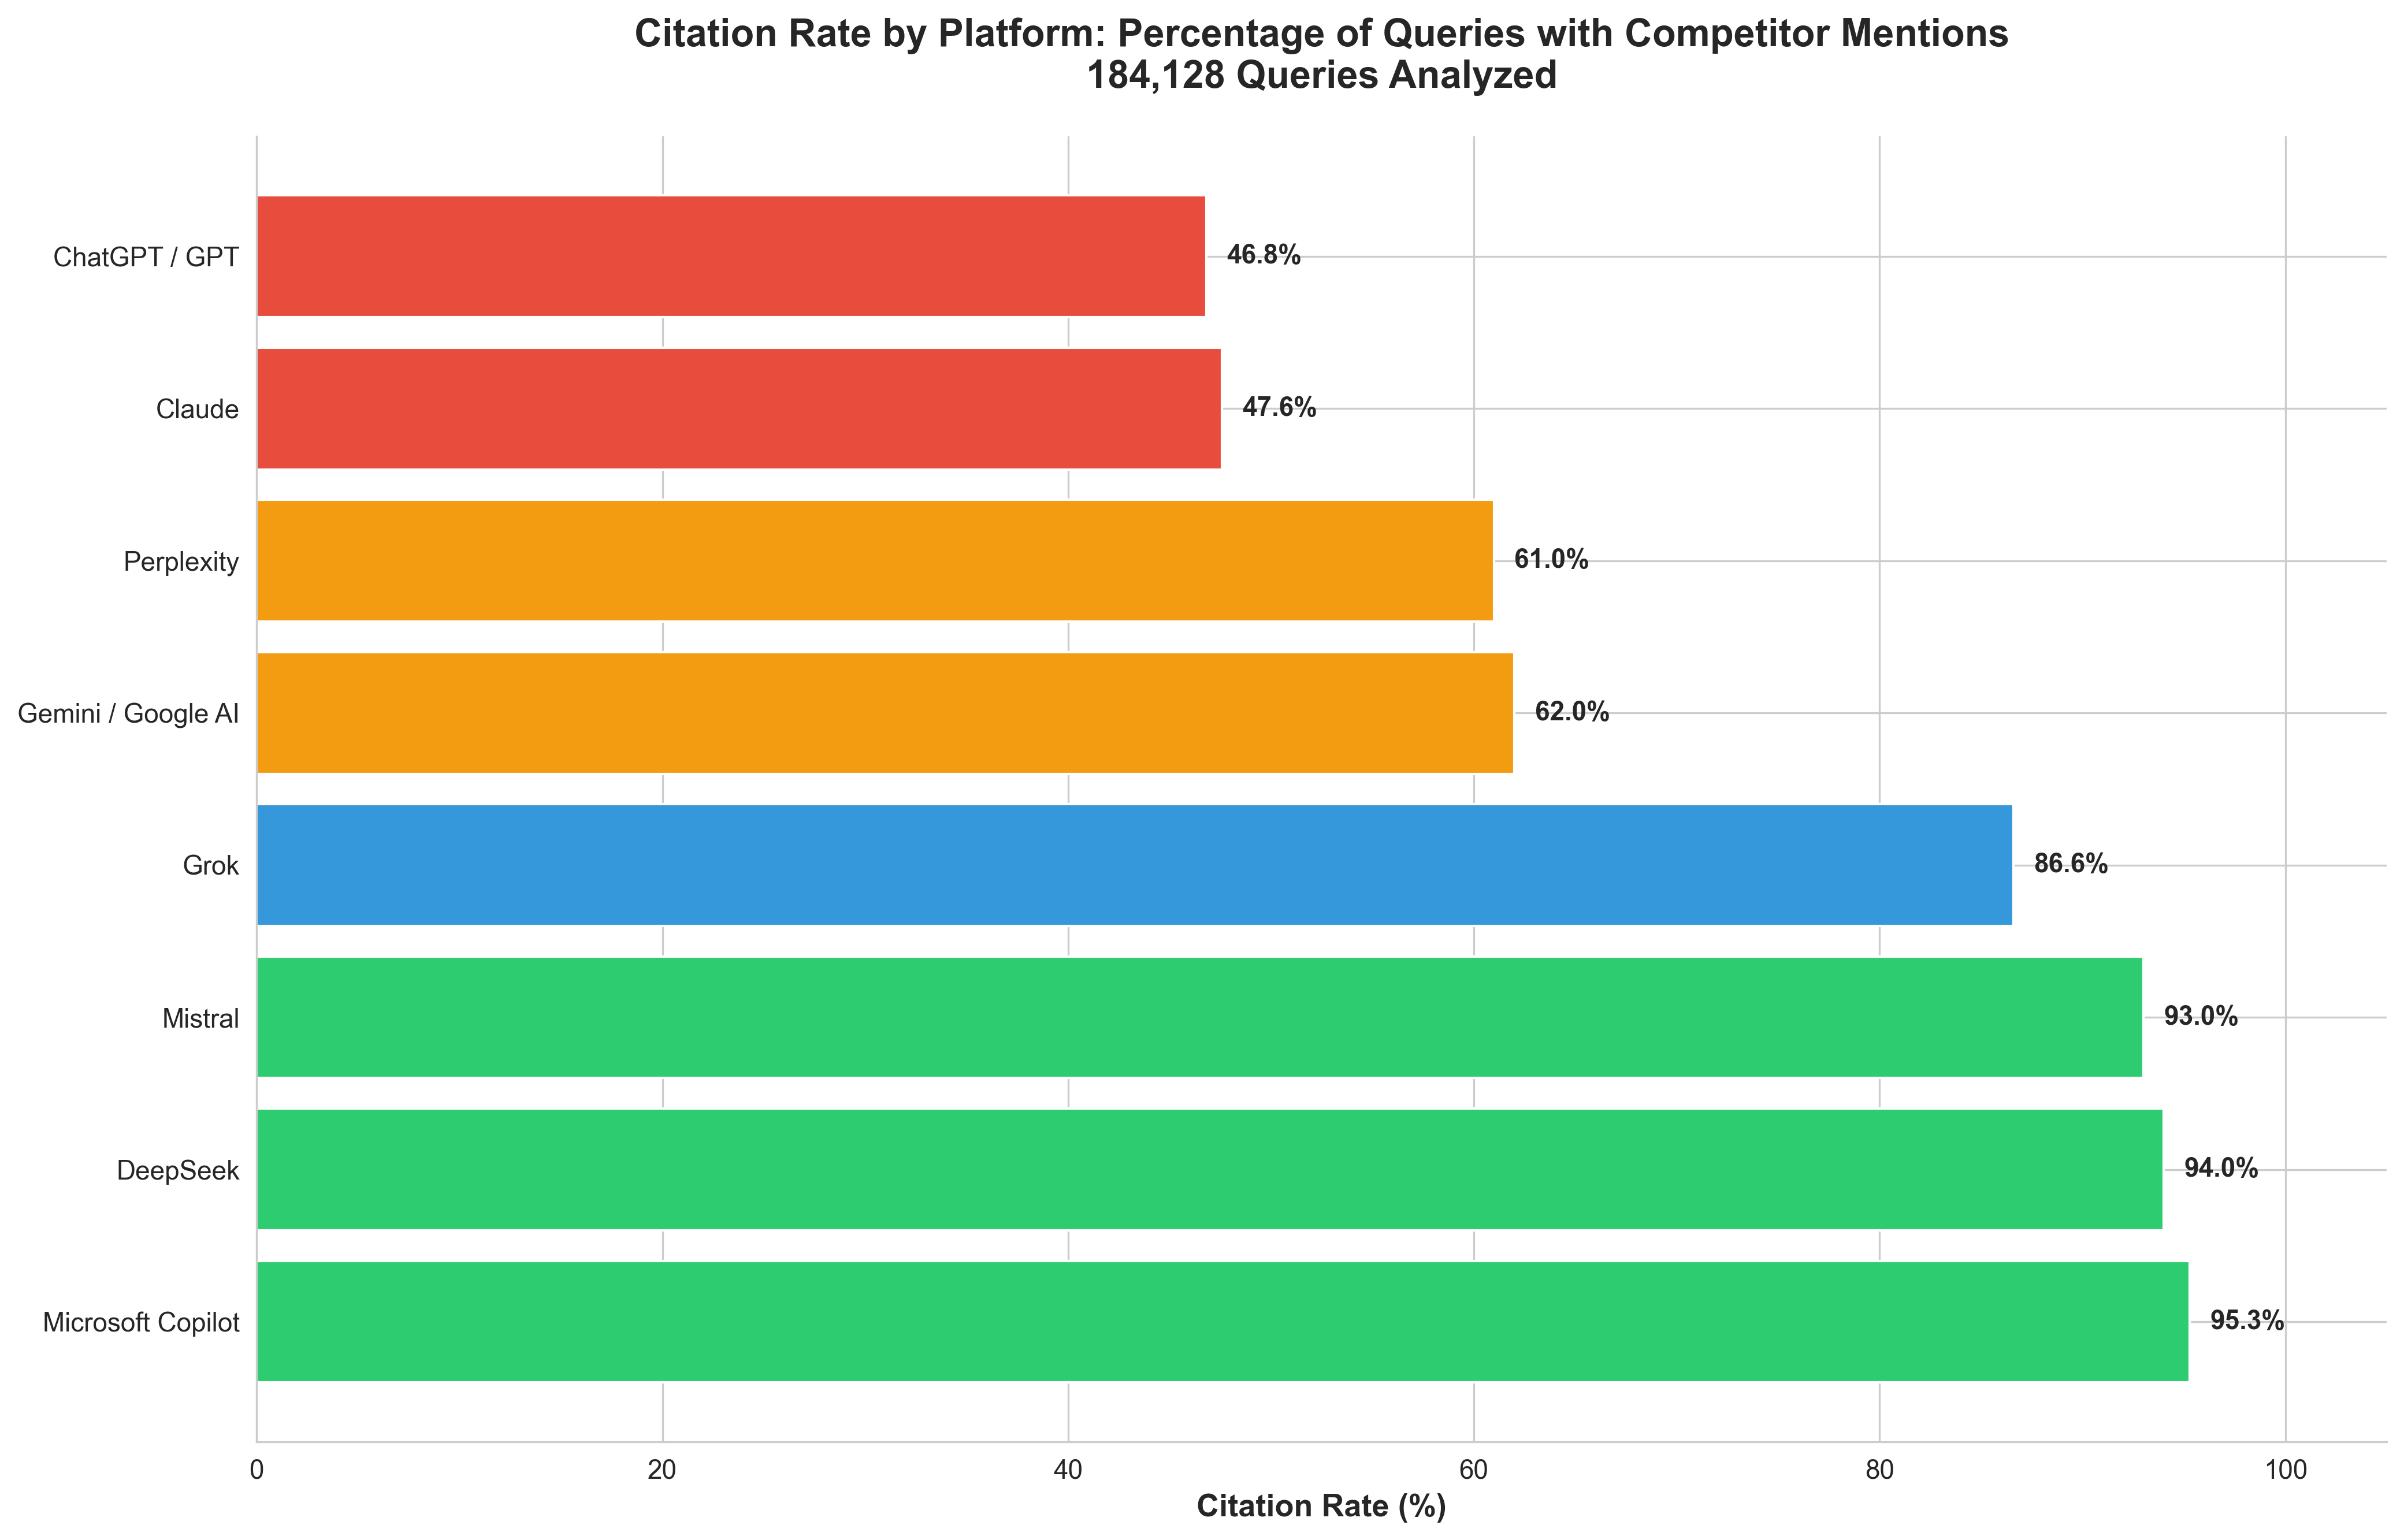
Toutes les plateformes ne mentionnent pas les concurrents avec la même fréquence. Nous avons mesuré le taux de mention des concurrents, c’est-à-dire le pourcentage de requêtes dans lesquelles au moins un concurrent est mentionné :
Taux de mention des concurrents | Plateformes | Implication stratégique |
90-100 % | DeepSeek (88-100 %), Microsoft Copilot (95,29 %), Mistral (91-95 %) | Au moins un concurrent est souvent mentionné dans cet échantillon; aucune citation de votre marque n’est garantie. |
70-89 % | Grok (86,59 %) | Au moins un concurrent est mentionné dans une forte part des réponses analysées; cela ne mesure pas le retour sur investissement. |
50-69 % | Perplexity (58-64 %), Gemini/Google AI (53-71 %) | Sélectif : les signaux d’autorité sont déterminants |
19-74 % | ChatGPT/GPT (grand écart !) | Variable selon le modèle : GPT-5 ultra-sélectif (19 %), GPT-4o-mini fréquent (74 %) |
\< 50 % | Claude (47,57 %) | Ultra-sélectif : être mentionné = signal premium |
Détail par plateforme :
💡 Observation : dans cet échantillon, Microsoft Copilot mentionnait au moins un concurrent dans 95,29 % des réponses. Cette mesure ne donne ni la probabilité de citer votre marque ou votre site, ni le retour sur investissement d’une optimisation. 💡 L’écart de ChatGPT/GPT : la fréquence de mention d’au moins un concurrent variait de 19 à 74 % selon le modèle dans cet échantillon. Cette différence décrit les réponses collectées; elle ne mesure pas le rendement d’une action GEO. 💡 Le score parfait de DeepSeek : 100 % de taux de mention des concurrents pour DeepSeek Reasoner. Chaque requête a abouti à des mentions de concurrents. Hyper-complet, mais l’échantillon est minuscule.
Lancez un audit gratuit : en quelques minutes, ChatGPT, Gemini et Perplexity répondent en direct à 8 questions d’achat sur votre marché, et vous voyez qui ils recommandent.
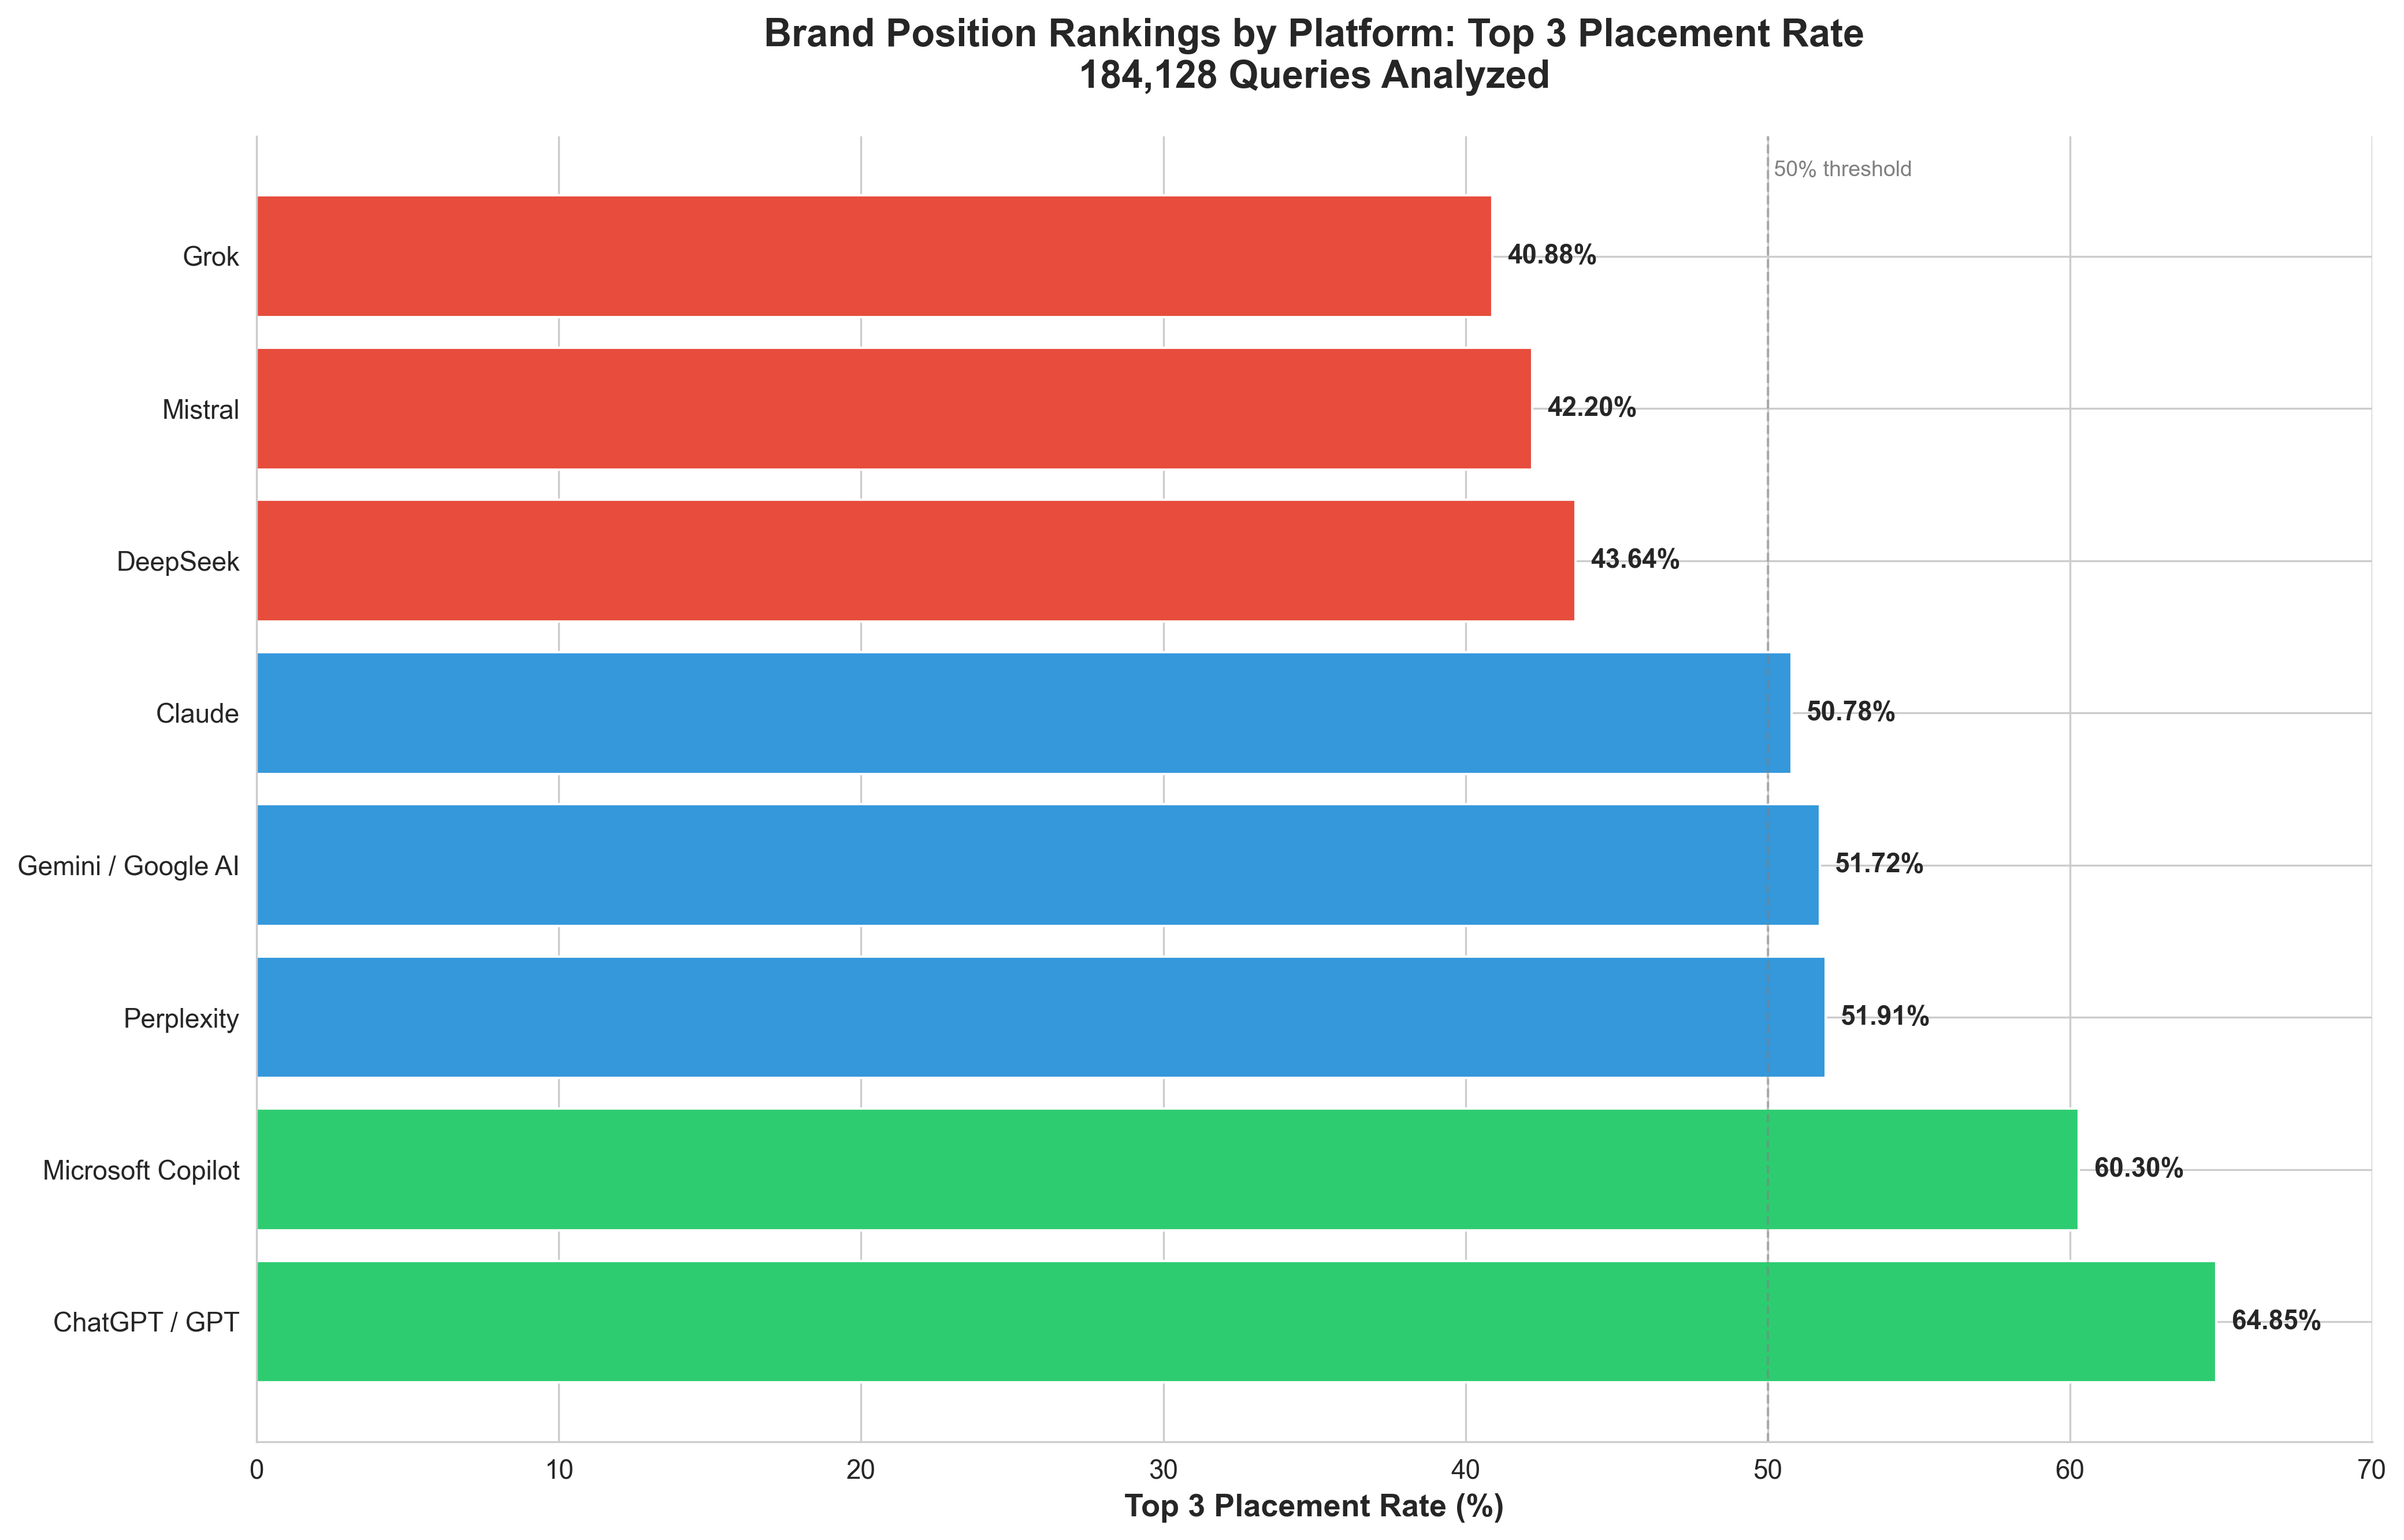
Pour la première fois, nous avons suivi le rang des marques lorsqu’elles sont mentionnées par les LLM. Voici le taux de placement dans le top 3 par plateforme, c’est-à-dire le pourcentage de mentions qui arrivent dans les 3 premières positions :
Rang | Plateforme | Plage de position moyenne | Meilleur % dans le top 3 | Visibilité des marques |
🥇 | ChatGPT / GPT | 3,55 à 5,11 | 64,85 % | EXCELLENTE (GPT-4o-mini en tête) |
🥈 | Microsoft Copilot | 3,47 | 60,30 % | EXCELLENTE |
🥉 | Perplexity | 4,89 à 5,64 | 51,91 % | BONNE (Sonar meilleur que Core) |
4 | Claude | 4,42 | 50,78 % | MOYENNE |
5 | Gemini / Google AI | 4,31 à 7,74 | 51,72 % | MITIGÉE (AI Overview bon, 2.0 Flash catastrophique) |
6 | DeepSeek | 4,74 à 5,72 | 43,64 % | MOYENNE (petit échantillon) |
7 | Mistral | 4,79 à 5,47 | 42,20 % | SOUS LA MOYENNE |
8 | Grok | 5,11 | 40,88 % | SOUS LA MOYENNE |
Détail par plateforme :
ChatGPT/GPT (LE MEILLEUR) :
Gemini/Google AI (MITIGÉ : du PIRE au BON) :
Perplexity :
💡 DÉCOUVERTE CHOQUANTE : la plateforme ChatGPT/GPT classe les marques près de 2 fois MIEUX que Gemini (64,85 % contre 37,18 % dans le top 3). GPT-4o-mini offre à lui seul une visibilité des marques nettement supérieure à celle de n’importe quel modèle Gemini. 💡 Le problème Gemini : Gemini 2.0 Flash (9,9 % de part des requêtes de notre échantillon) affiche une position moyenne de 7,74, ce qui signifie que la plupart des marques sont classées 7e ou 8e. C’est un positionnement catastrophique. Exception : Google AI Overview est bien meilleur (51,72 %). 💡 Deux indicateurs distincts pour Copilot : 95,29 % des réponses analysées mentionnaient au moins un concurrent; le placement dans le top 3 était de 60,3 % selon le périmètre de l’étude. Ils ne constituent pas une garantie de citation ou de résultat pour une marque donnée. 💡 Le poids de ChatGPT/GPT dans le panel : ces modèles représentaient 44,7 % des requêtes analysées. Le taux de placement dans le top 3 de GPT-4o-mini était de 64,85 % dans l’étude. La répartition du panel ne mesure pas la taille du marché ni les résultats commerciaux d’une optimisation.
Nous avons utilisé le coefficient de Gini (une mesure des inégalités employée en économie) pour comprendre la diversité des sources :
Niveau de concentration | Plateformes | Plage du top 10 % | Plage de Gini | Implication stratégique |
TRÈS CONCENTRÉ | ChatGPT/GPT (certains modèles) | 84-100 % | 0,54-1,0 | Sourcing étroit : GPT-5 réutilise sans cesse des domaines d’élite |
CONCENTRÉ | Gemini/Google AI (la plupart) | 15-68 % | 0,72-0,76 | Diversité modérée : Gemini 2.0/2.5 privilégient certains domaines |
ÉQUILIBRÉ | ChatGPT/GPT (principal), Perplexity | 10-13 % | 0,60-0,83 | Varié mais ciblé : bon équilibre |
TRÈS DIVERSIFIÉ | Microsoft Copilot, Grok, Google AI Overview | 4-5 % | 0,46-0,65 | Diversité massive : plus de 100 domaines comptent |
Détail par plateforme :
Les plus diversifiées (top 10 de 4 à 5 %) :
Équilibrées (top 10 de 10 à 13 %) :
Concentrées (top 10 de 15 à 100 %) :
💡 Les championnes de la diversité : Google AI Overview, Microsoft Copilot et Grok citent des sources 20 fois plus variées (seulement 4-5 % viennent du top 10). Il vous faut une très grande diversité de sources (plus de 100 domaines) pour y figurer. 💡 Le problème d’inégalité de Perplexity : un Gini de 0,833 (le plus élevé !) signifie qu’un petit nombre de domaines d’élite (legalplace.fr, legalstart.fr) dominent le volume de citations. Construisez votre autorité de domaine, ou vous serez invisible. 💡 L’écart de ChatGPT/GPT : GPT-4o-mini est équilibré (11,65 %), mais GPT-5 est ultra-concentré (84,48 %) et réutilise sans cesse les mêmes sources d’élite. Deux stratégies complètement différentes au sein d’une même plateforme.
Nous avons classé toutes les sources par type et découvert un schéma universel. Voici ce que recouvre chaque type de source :
Les types de sources expliqués :
Voici comment les LLM répartissent leurs citations entre ces types de sources :
Plateforme | Commerciales % | Institutionnelles % | Médias % | Préférence |
Perplexity | 66,8 % | 6,2 % | 5,3 % | Fortement commerciales |
Microsoft Copilot | 68,2 % | 3,1 % | 15,2 % | Fortement commerciales |
ChatGPT/GPT | 54,3 % | 5,1 % | 7,4 % | Commerciales (variable selon le modèle) |
Gemini/Google AI | 51,7 % | 3,8 % | 6,2 % | Commerciales |
Claude | N/D | N/D | N/D | ZÉRO source |
Mistral | N/D | N/D | N/D | ZÉRO source |
DeepSeek | N/D | N/D | N/D | ZÉRO source |
Grok | 64,0 % | 4,7 % | 16,6 % | Fortement commerciales |
Détail par plateforme (modèles avec sources) :
Fortement commerciales (65-78 %) :
Modérément commerciales (45-55 %) :
💡 Une préférence commerciale universelle : TOUTES les plateformes (sauf GPT-5) favorisent les sources commerciales (sites d’entreprises, plateformes SaaS, services). Si vous êtes une entreprise, c’est une excellente nouvelle : les LLM préfèrent les sites d’entreprises aux médias. 💡 Perplexity = roi du commercial : 250 018 citations commerciales (77,6 % de Core). Si vous êtes dans le B2B ou le SaaS, Perplexity est votre meilleur allié. 💡 L’écart de ChatGPT/GPT : très variable au sein de la plateforme. GPT-5 préfère à 72,4 % les sources institutionnelles (.gov/.edu), tandis que ChatGPT Core favorise à 73,7 % les sources commerciales. Des modèles de confiance complètement différents. 💡 Enseignement stratégique : pour 7 plateformes sur 8, construire une autorité commerciale (un E-E-A-T solide, une crédibilité d’entreprise) vaut plus que la couverture médiatique. Exception : si vous ciblez spécifiquement GPT-5, recherchez des partenariats .gov/.edu.
Ces cinq dimensions révèlent des vérités fondamentales sur la recherche IA :
L’ère de la recherche IA n’est pas l’avenir. C’est maintenant.
Si la partie 1 portait sur la façon dont les LLM répondent et si la partie 2 a révélé des schémas qui changent la donne, la partie 3 porte sur les sources que les LLM citent. Plus de 1 479 145 sources ont été analysées sur l’ensemble des requêtes, soit une hausse de 2 365 % par rapport à notre jeu de données du T2 2025 (59 992 sources). Les schémas observés sont fascinants.
Tous les modèles ne citent pas leurs sources de la même façon. Certains fournissent un sourcing abondant, tandis que d’autres (comme Claude, Mistral et DeepSeek) ne fournissent AUCUNE citation de source.
Modèle | Sources au total | Domaines uniques | Sources moyennes par requête | Approche du sourcing |
Perplexity Core | 323 130 | ~15 000 | 9,8 | Très gros volume |
Perplexity Sonar | 384 149 | ~40 000 | 16,4 | Diversité maximale |
GPT-4o-mini | 245 987 | 43 824 | 6,4 | La plus variée (plus de 43 000 domaines !) |
Gemini 2.0 Flash | 232 848 | ~30 000 | 12,8 | Gros volume |
Google AI Overview | 133 427 | ~40 000 | 35,2 | Moyenne par requête la plus élevée |
ChatGPT Core | 57 793 | ~10 000 | 1,3 | Très sélectif |
Microsoft Copilot | 19 005 | ~5 000 | 3,4 | Sélectif |
Grok | 70 669 | ~15 000 | 17,2 | Gros volume |
Claude 3.7 Sonnet | 0 | 0 | 0 | Aucune source |
Mistral (tous) | 0 | 0 | 0 | Aucune source |
DeepSeek (tous) | 0 | 0 | 0 | Aucune source |
💡 Constat majeur : sept modèles ne fournissent AUCUNE citation de source : Claude 3.7, Mistral Medium/Small/Large et DeepSeek Chat/Reasoner. C’est une rupture radicale avec les modèles fondés sur la citation, et elle change fondamentalement la façon dont les utilisateurs perçoivent et vérifient les réponses. 💡 GPT-4o-mini, champion de la diversité : sans avoir le plus gros volume de sources, GPT-4o-mini cite le plus grand nombre de domaines uniques (43 824), ce qui suggère un réservoir de sources incroyablement varié. Cela concorde avec son excellent positionnement des marques (64,85 % de placement dans le top 3). 💡 La profondeur de Google AI Overview : 35,2 sources par requête en moyenne, soit près de 6 fois plus que GPT-4o-mini. Cela explique sa concentration de 4,7 % (le modèle le plus diversifié de notre étude).
Les sources auxquelles les LLM font confiance révèlent leurs priorités sous-jacentes. Voici les 5 domaines non commerciaux les plus cités pour chaque grande plateforme d’IA (hors sites d’entreprises et de marketing) :
Top 5 des domaines :
💡 Enseignement : ChatGPT montre une forte préférence pour les plateformes communautaires (Reddit en tête) et les sources gouvernementales faisant autorité : 4 des 5 premiers sont des domaines officiels .gov/.gouv.fr, ce qui traduit une confiance dans l’autorité institutionnelle.
Top 4 des domaines :
💡 Enseignement : Perplexity privilégie fortement les contenus vidéo et les plateformes communautaires. YouTube en première place et Reddit en deuxième dominent, suivis par les ressources de l’administration française pour la création d’entreprise.
Top 5 des domaines :
💡 Enseignement : Gemini montre la domination des propriétés de Google (YouTube en tête), combinée à l’autorité de l’administration et aux réseaux professionnels (LinkedIn), ce qui reflète l’attention portée aux sources crédibles et faisant autorité.
Top 4 des domaines :
💡 Enseignement : Microsoft Copilot affiche de la diversité avec des plateformes de contenu scientifique, de voyage et d’e-commerce, ce qui suggère une approche tournée vers le grand public, avec des informations pratiques et actionnables.
Top 5 des domaines :
💡 Enseignement : Grok privilégie fortement les plateformes communautaires et les médias établis. Reddit domine (n° 1) avec près de 5 fois plus de citations que Forbes (n° 2), ce qui montre une forte préférence pour le contenu généré par les utilisateurs, aux côtés de l’actualité business faisant autorité.
Détaillez votre visibilité modèle par modèle pour voir où chaque IA vous mentionne, et où elle ne le fait pas.
Modèle | Domaines uniques |
GPT-4o-mini | 43 824 |
Perplexity Sonar | 38 738 |
Google AI Overview | 38 235 |
Gemini 2.0 Flash | 29 274 |
Perplexity Core | 11 923 |
ChatGPT Core | 5 173 |
💡 Enseignement clé : GPT-4o-mini dispose du réservoir de sources le plus varié (43 824 domaines), tandis que ChatGPT Core est le plus sélectif (5 173). 💡 Implication stratégique : pour GPT-4o-mini, l’autorité de domaine de longue traîne compte. Pour ChatGPT Core, concentrez-vous sur les sources de premier rang faisant autorité.
Nous avons analysé les mots les plus fréquents dans les URL citées afin d’identifier les thèmes de contenu que les LLM privilégient.
💡 Enseignement clé : les contenus « blog », « guide » et « comment » (le « how-to » anglais) dominent sur tous les modèles. 💡 Enseignement sur les dates : contrairement à notre étude précédente, 2025 ne devance pas nettement 2024. La fraîcheur du contenu semble moins déterminante que nous le pensions au départ. L’autorité et la pertinence comptent davantage. 💡 Format de contenu : les guides, les comparatifs et les contenus pédagogiques sont fortement favorisés.
Principaux enseignements :
Maintenant que nous avons analysé la façon dont les LLM répondent (partie 1), découvert des schémas majeurs (partie 2) et identifié les sources auxquelles ils font confiance (partie 3), transformons tout cela en stratégies actionnables.
D’après notre analyse des taux de citation et du positionnement des marques, voici l’ordre de priorité d’optimisation recommandé :
Premier groupe présenté dans cet échantillon :
Autres moteurs à comparer sur vos propres questions :
Niveau 3 : sélectif (optimisation avancée) :
Stratégie à reconsidérer :
💡 Stratégie clé : commencez par les modèles du niveau 1, où vous obtenez la meilleure probabilité de citation ET le meilleur positionnement. Ne passez aux niveaux 2 et 3 qu’après avoir dominé le niveau 1.
Notre analyse BOFU a montré que les requêtes d’intention d’achat déclenchent 2,5 fois plus de mentions de concurrents. Cela change tout :
Ancienne stratégie (erronée) :
Nouvelle stratégie (la bonne) :
Plan d’action :
💡 Pourquoi c’est important : si vous n’êtes pas visible à l’étape BOFU, les utilisateurs ne vous découvriront jamais, même si vous avez le meilleur produit.
Il n’existe pas de stratégie GEO « taille unique ». Chaque plateforme a ses propres préférences :
Plateforme | Part des requêtes du panel | Réponses mentionnant au moins un concurrent | % moyen dans le top 3 | Stratégie de contenu |
Microsoft Copilot | 3,0 % | 95,29 % | 60,3 % | Contenu commercial + E-E-A-T. Sources variées (4,44 % de concentration). Fréquence de mention de concurrents élevée dans ce panel; le retour sur investissement n’est pas mesuré. |
ChatGPT / GPT | 44,7 % | 19-74 % | 64,85 % | Contenu complet et de forte autorité. Le plus varié (43 k domaines). Écart : de GPT-5 ultra-sélectif (19 %) à GPT-4o-mini fréquent (74 %). |
Perplexity | 30,6 % | 58-64 % | 45 % | Fortement commercial (Core : 77,6 %, Sonar : 56,2 %). Contenu business pratique. Construisez votre autorité de domaine. 707 k sources. |
Gemini / Google AI | 13,2 % | 53-71 % | 37-52 % | YouTube essentiel (n° 1 pour Google AI Overview). MAIS Gemini 2.0 Flash a le PIRE positionnement (7,74). Résultats contrastés. |
Grok | 2,2 % | 86,59 % | 40,88 % | Très complet (7,94 concurrents). Comparatifs détaillés indispensables. |
Claude | 6,0 % | 47,57 % | 50,78 % | Ultra-concis (1 059 caractères). ZÉRO source. Miser uniquement sur les données d’entraînement. |
Mistral | 0,2 % | 91-95 % | 33-42 % | 11,69 concurrents (le plus concurrentiel !). ZÉRO source. Miser sur les données d’entraînement. |
DeepSeek | 0,1 % | 88-100 % | 44 % | Au moins un concurrent mentionné dans 100 % des réponses de Reasoner. ZÉRO source. Volume minuscule, mais intéressant. |
Enseignements clés :
Le poids de YouTube, en particulier sur Google AI Overview (n° 1), Gemini (n° 9) et Perplexity (n° 6), ne peut plus être ignoré.
Action : si vous ne produisez pas de contenu vidéo, vous êtes invisible pour une part importante du trafic de la recherche IA.
99 % des réponses utilisent des puces. Les LLM privilégient :
Action : restructurez vos contenus existants pour privilégier la lisibilité en un coup d’œil.
Reprendre les schémas de discours des LLM (formulations prudentes, langage de conseil, énoncés au conditionnel) peut améliorer les taux de citation.
Test :
Nos données montrent que les contenus de 2024 se classent presque aussi bien que ceux de 2025, ce qui contredit l’idée reçue selon laquelle la fraîcheur prime.
Implication : concentrez-vous sur la création de contenus pérennes et faisant autorité plutôt que sur des mises à jour constantes pour changer de date.
Tous les grands modèles favorisent les sources commerciales, sauf GPT-5 :
Action : construisez une autorité commerciale (un E-E-A-T solide, une crédibilité d’entreprise) plutôt que de viser la couverture médiatique. Pour GPT-5, recherchez des partenariats .gov/.edu.
Dans notre échantillon de 2025, Reddit, Quora et Medium apparaissaient parmi les sources citées. Une étude Qwairy d’août 2026 observe ensuite une forte baisse de la part de Reddit dans les citations de ChatGPT Search ; les deux études portent sur des périodes et des échantillons différents.
Action : participez de façon authentique aux discussions des communautés. Des fils Reddit et des réponses Quora de qualité peuvent devenir des sources faisant autorité.
7 modèles fournissent ZÉRO source : Claude 3.7, tous les modèles Mistral et les modèles DeepSeek. Pourtant, leurs taux de citation restent ÉLEVÉS (47-100 %).
Implication : la logique traditionnelle des « backlinks » ne s’applique pas. Concentrez-vous sur le fait de faire partie des données d’entraînement : publiez des contenus faisant autorité et largement cités que les futurs modèles ingéreront.
Indicateur | Étude du T2 2025 | Étude du T3 2025 | Évolution |
Total des requêtes | 32 961 | 184 128 | +459 % |
Total des sources | 59 992 | 1 479 145 | +2 365 % |
Modèles suivis | 3 | 20 | +567 % |
Caractères moyens de ChatGPT | 1 687 | 5 650 | +235 % |
Caractères moyens de Gemini | 2 955 | 6 174 | +109 % |
Caractères moyens de Perplexity | 2 029 | 2 233 | +10 % |
Concurrents de ChatGPT/GPT | Mesure T2 non comparable | 3,54 (plateforme); 4,78 pour ChatGPT Core | Évolution non calculable à partir des valeurs publiées |
Concurrents de Gemini | n/d | 3,18 | Nouveau |
Dimensions d’analyse | 3 | 5 | Nouveau : BOFU, taux de mention des concurrents, positionnement des marques, Gini, contenu commercial |
Principales évolutions :
Comparez les moteurs sur vos questions : Copilot mentionnait au moins un concurrent dans 95,29 % des réponses de cet échantillon. ChatGPT/GPT représentait 44,7 % des requêtes analysées et Perplexity 30,6 %. Ces proportions décrivent le panel, pas des parts de marché ou un retour sur investissement.
Cela dépend du modèle. Claude 3.7 Sonnet ne produit que 1 059 caractères en moyenne (ultra-concis), alors que Google AI Overview en produit 6 174 (très détaillé). Il n’existe pas de longueur universelle : optimisez en fonction de la plateforme que vous ciblez.
Oui ! Nos données montrent que l’autorité l’emporte sur la fraîcheur. Les contenus de 2024 se classent presque aussi bien que ceux de 2025. Concentrez-vous sur la création de contenus pérennes et faisant autorité plutôt que sur des mises à jour constantes pour la fraîcheur.
Le contenu BOFU est déterminant. Les requêtes d’intention d’achat déclenchent 2,5 fois plus de mentions de concurrents (4,78 en moyenne contre 1,92 pour le TOFU). Si vous n’êtes pas visible quand les utilisateurs demandent « [catégorie] : les meilleurs » ou « [marque A] vs [marque B] », vous êtes invisible au moment qui compte le plus.
Ces modèles reposent sur un modèle de confiance fondamentalement différent : ils s’appuient entièrement sur leurs données d’entraînement plutôt que sur des sources en temps réel. Leurs taux de citation restent élevés (47-100 % mentionnent des concurrents), mais ils n’indiquent aucune attribution. Pour y figurer, concentrez-vous sur le fait de faire partie des futures données d’entraînement grâce à des contenus faisant autorité et largement cités.
Cela varie considérablement selon la plateforme :
La position compte plus que jamais quand 3 à 12 alternatives sont mentionnées.
Oui, c’est même crucial. YouTube est la source n° 1 de Google AI Overview, la n° 6 pour Perplexity Sonar et la n° 9 pour Gemini 2.0 Flash. Si vous ne produisez pas de contenu vidéo, vous êtes invisible pour une part importante du trafic de la recherche IA.
Les mesures ChatGPT/GPT du T3 sont de 3,54 concurrents par requête en moyenne et 4,78 pour ChatGPT Core. Elles ne sont pas comparables aux 0,81 sources du T2. La croissance mensuelle du volume de requêtes analysées décrit le développement de notre panel, pas l’adoption de la recherche IA par le marché.
La recherche IA n’est pas l’avenir. Elle est déjà là. Les données sont claires : les réponses générées par l’IA remplacent les résultats de recherche traditionnels. Avec 184 128 requêtes, 1 479 145 sources et 20 modèles analysés, des schémas révolutionnaires émergent :
Chez Qwairy, nous nous engageons à publier des mises à jour trimestrielles à mesure que le paysage de la recherche IA évolue. Nous avons déjà dépassé les 184 000 requêtes et nous continuerons de suivre :
Les marques qui gagneront dans la recherche IA seront celles qui :
La fenêtre d’opportunité, c’est MAINTENANT. N’attendez pas que tous les autres aient optimisé. Êtes-vous prêt ?
Vous voulez voir où se classe votre marque sur les 20 LLM ? Commencez dès aujourd’hui à optimiser votre présence dans les moteurs de recherche IA.
Ce que Qwairy vous aide à faire :
Pour aller plus loin, découvrez l’optimisation pour les moteurs génératifs (GEO) et comment suivre si votre marque est mentionnée dans les LLM.
Note méthodologique : cette étude a analysé 184 128 requêtes générées entre le 27 juillet et le 27 octobre 2025, sur 20 modèles de LLM via API. Toutes les données ont été collectées avec la plateforme GEO de Qwairy.
Suivez les questions qui comptent pour votre activité, voyez quelles marques chaque réponse mentionne et quelles sources elle cite, puis travaillez sur les manques.
Offre gratuite avec 120 crédits initiaux • Sans carte bancaire
Autres articles
AI Overviews en France : ce que Google cite vraiment, face aux États-Unis
Qwairy et Converteo ont analysé 12 120 réponses AI Overviews en France et aux États-Unis : requêtes déclenchantes, sources citées, autorité et volatilité.
Questions de suivi IA : la première réponse n’est pas la décision
72 % des réponses IA invitent à poser une autre question, et la présélection se rebat quand l’acheteur répond. Le benchmark Qwairy montre ce que décide ce tour.