Loading page

Suggestions de suivi IA : nous avons mesuré comment les moteurs terminent leurs réponses commerciales et à quelle fréquence ils proposent de continuer.
Cette étude décrit les réponses collectées entre mars et juin 2026. Les taux ci-dessous caractérisent ce corpus et sa méthode de détection ; ils ne sont pas des taux permanents propres aux produits. Pendant la majeure partie de l’ère de la recherche, une réponse était une destination.
Vous posiez une question, vous obteniez un résultat, l’interaction prenait fin.
Les assistants IA ont discrètement changé la donne. De plus en plus, la réponse n’est plus l’endroit où la conversation s’arrête : c’est l’endroit où le moteur tente d’amorcer la suivante.
Vous avez déjà vu cette manœuvre, même sans lui donner de nom.
ChatGPT termine une recommandation et ajoute : « Si vous le souhaitez, je peux affiner selon votre budget, votre région et l’usage que vous en ferez. »
Souvent, ce n’est même pas une phrase, mais un petit menu d’étapes suivantes. Cette ligne de clôture est délibérée : elle rouvre une question que vous pouviez croire close.
Nous pouvons mesurer à quel point cette pratique s’est répandue, car la fin d’une réponse est observable. Nous avons donc posé la question dans sa version la plus simple : sur les questions que l’on pose réellement aux marques, à quelle fréquence un moteur IA termine-t-il sa réponse en proposant de continuer, et tous les moteurs le font-ils ?
La réponse : bien plus souvent qu’on ne l’imagine, et les moteurs diffèrent énormément.
Constat n° 1 : sur les questions commerciales, l’invitation à poursuivre est désormais la norme, et non l’exception.
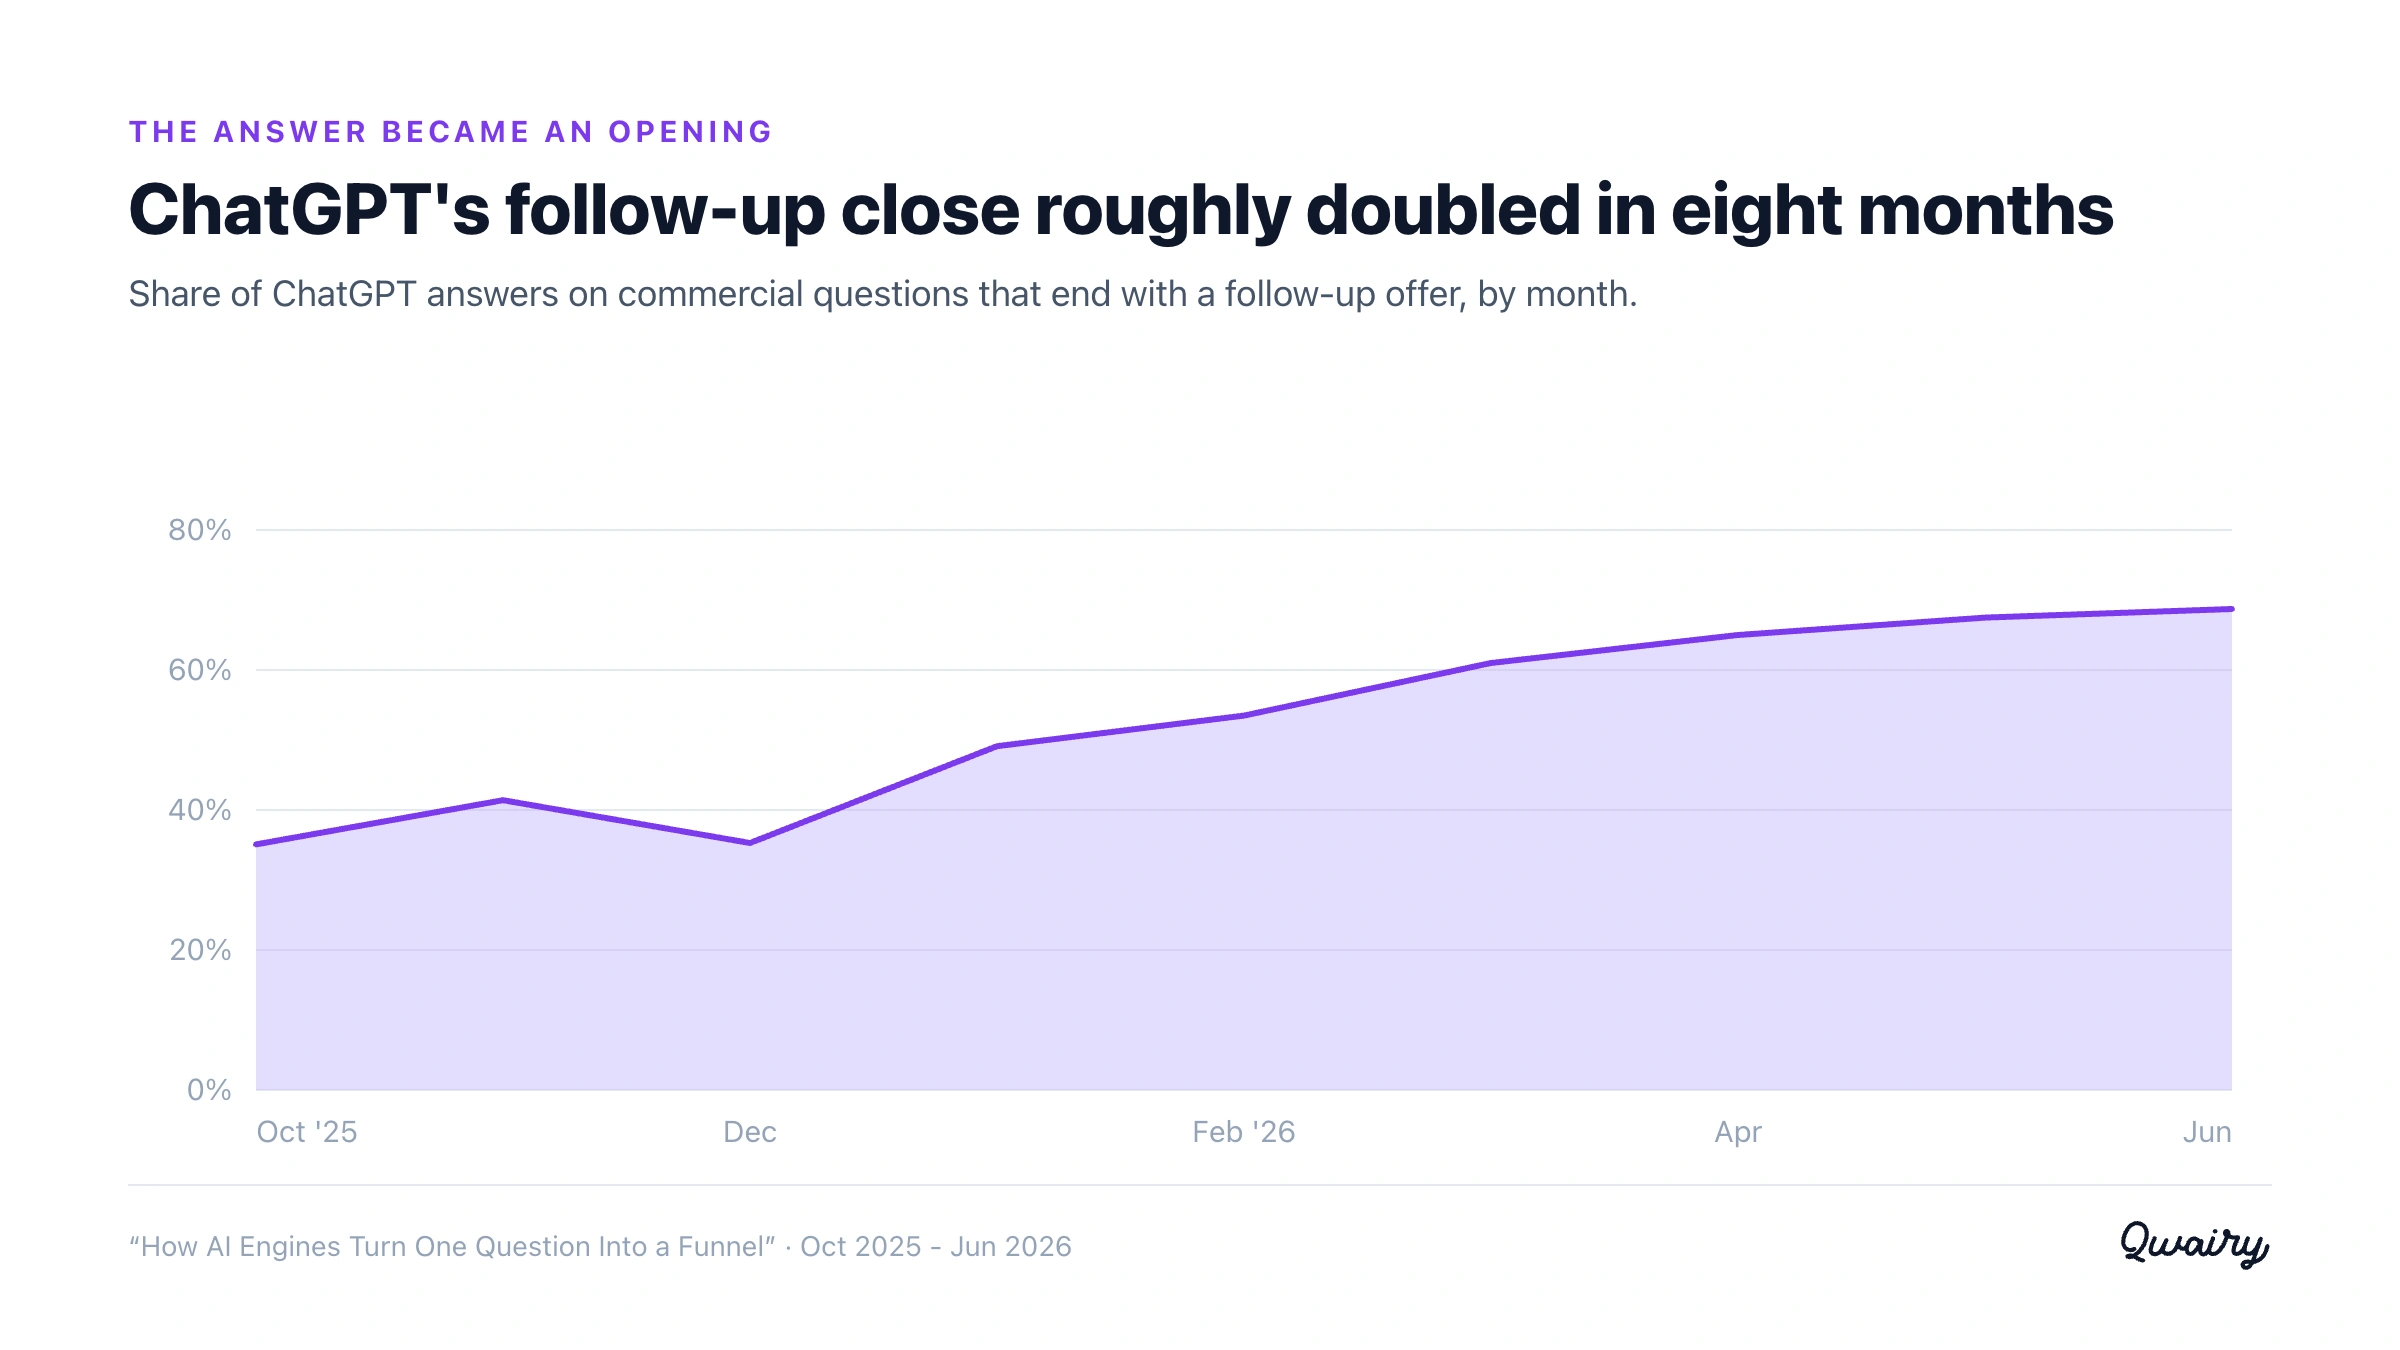
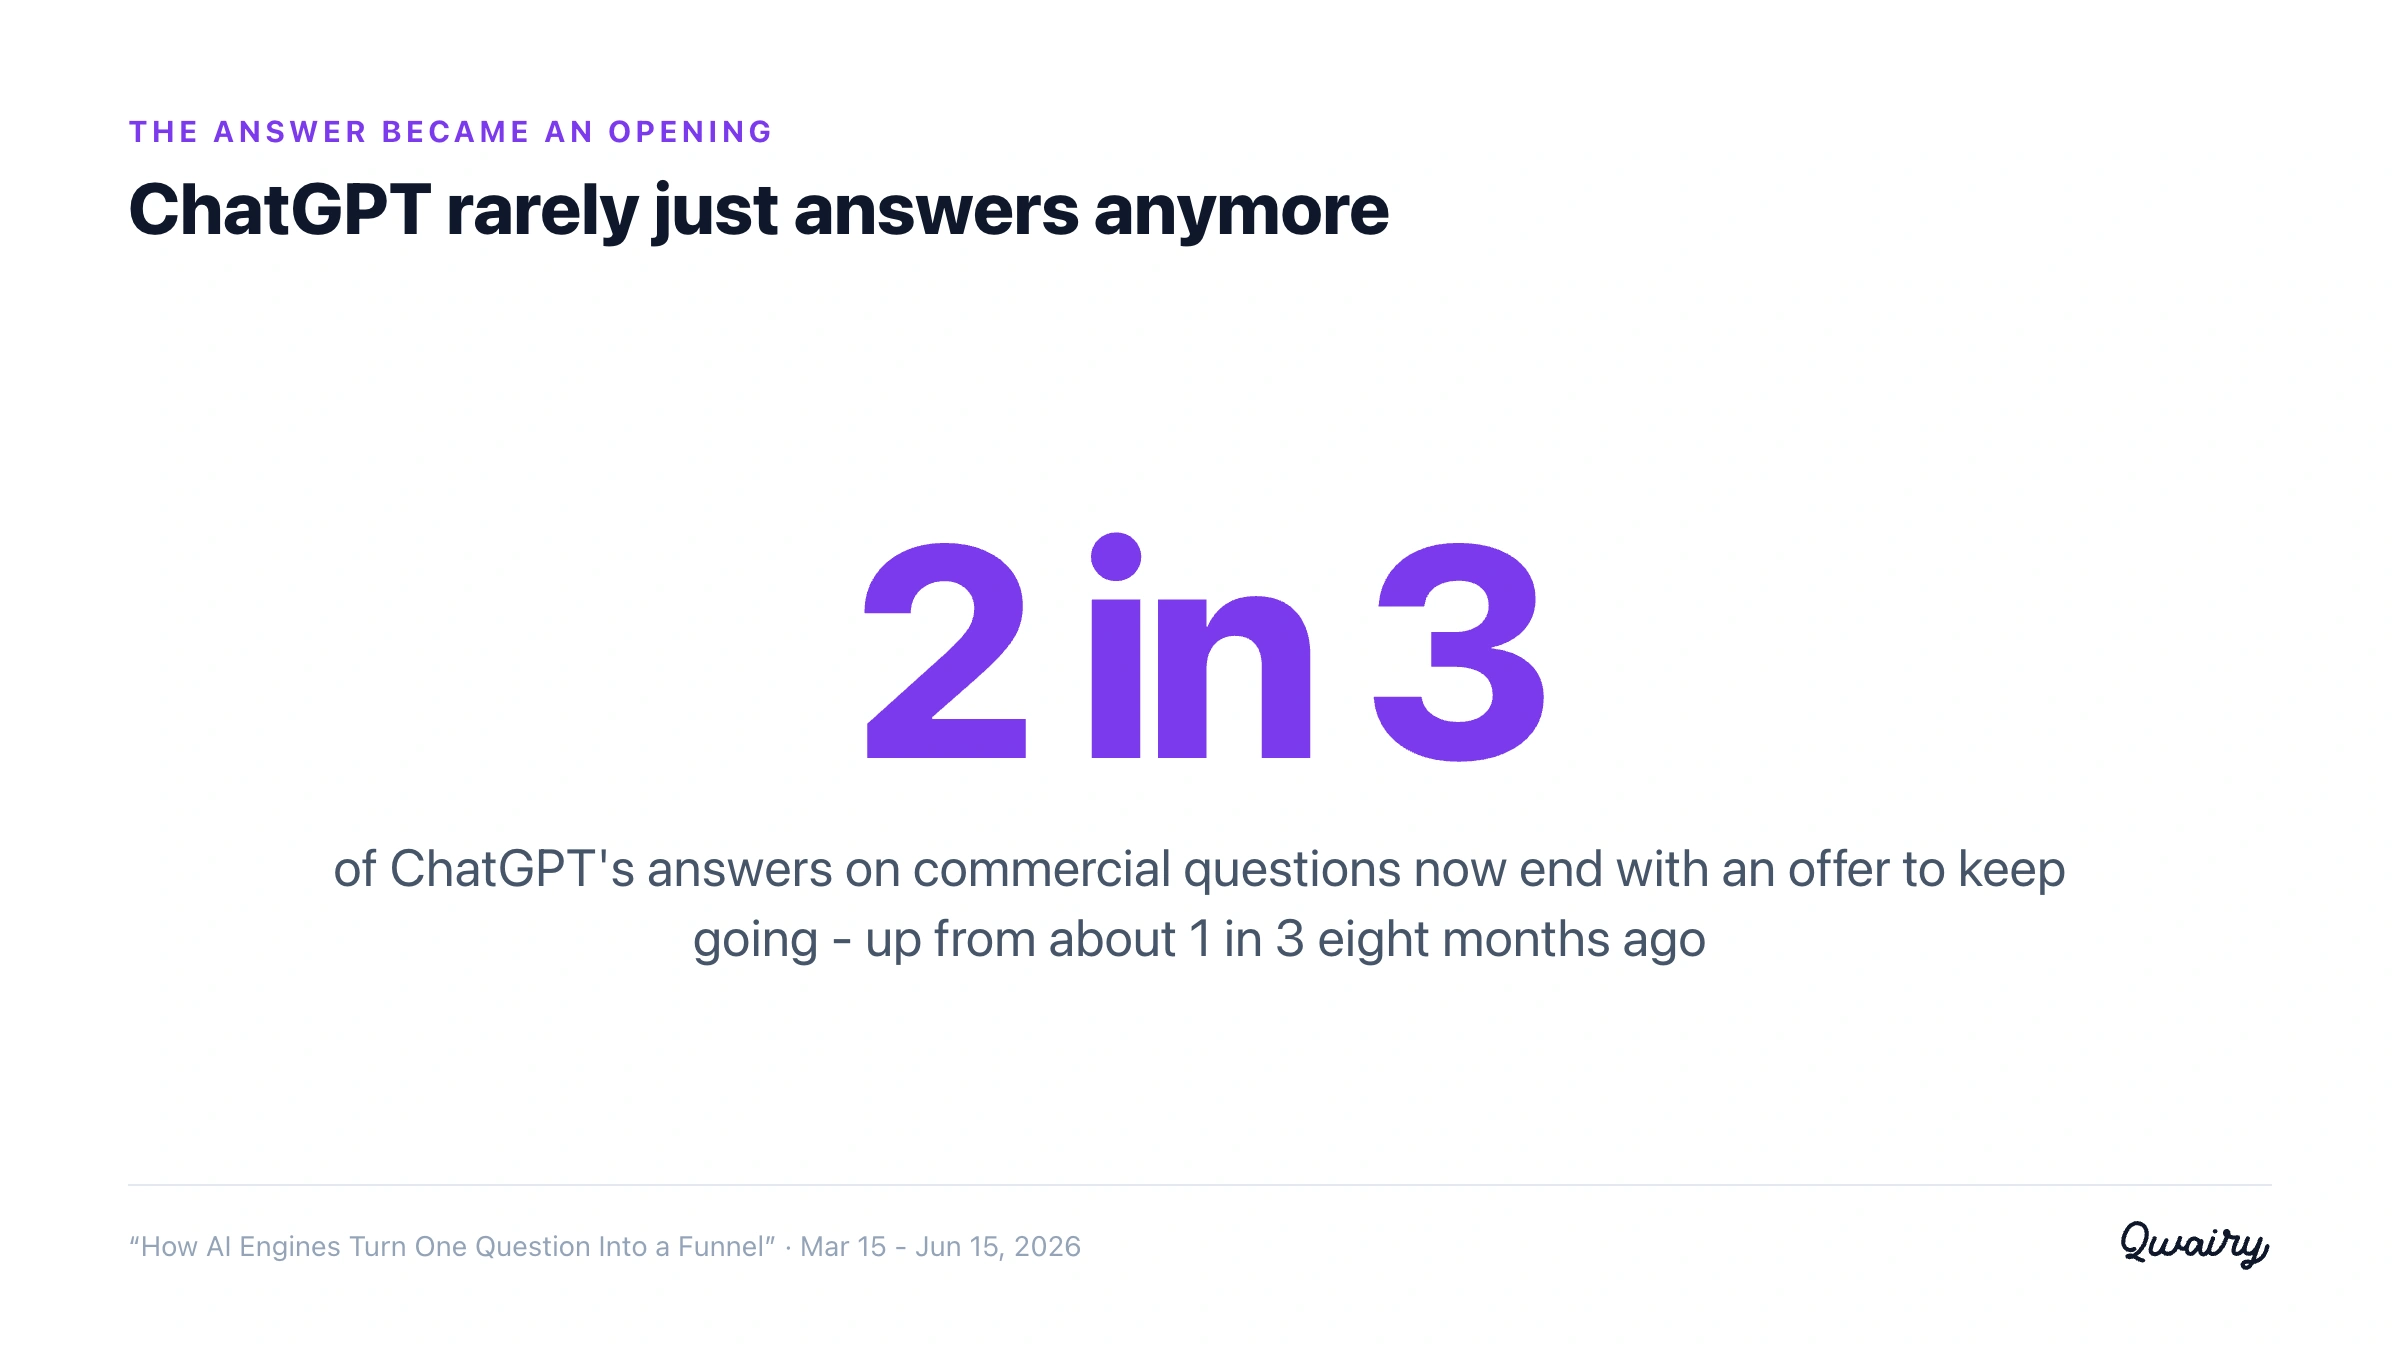
Sur les questions de recommandation, de comparaison et de guide pratique qui déterminent si une marque est mise en avant, ChatGPT termine environ deux réponses sur trois par une proposition de continuer. Il y a huit mois, c’était environ une sur trois. Le comportement a à peu près doublé.
Constat n° 2 : c’est un spectre, et non une caractéristique de « l’IA ».
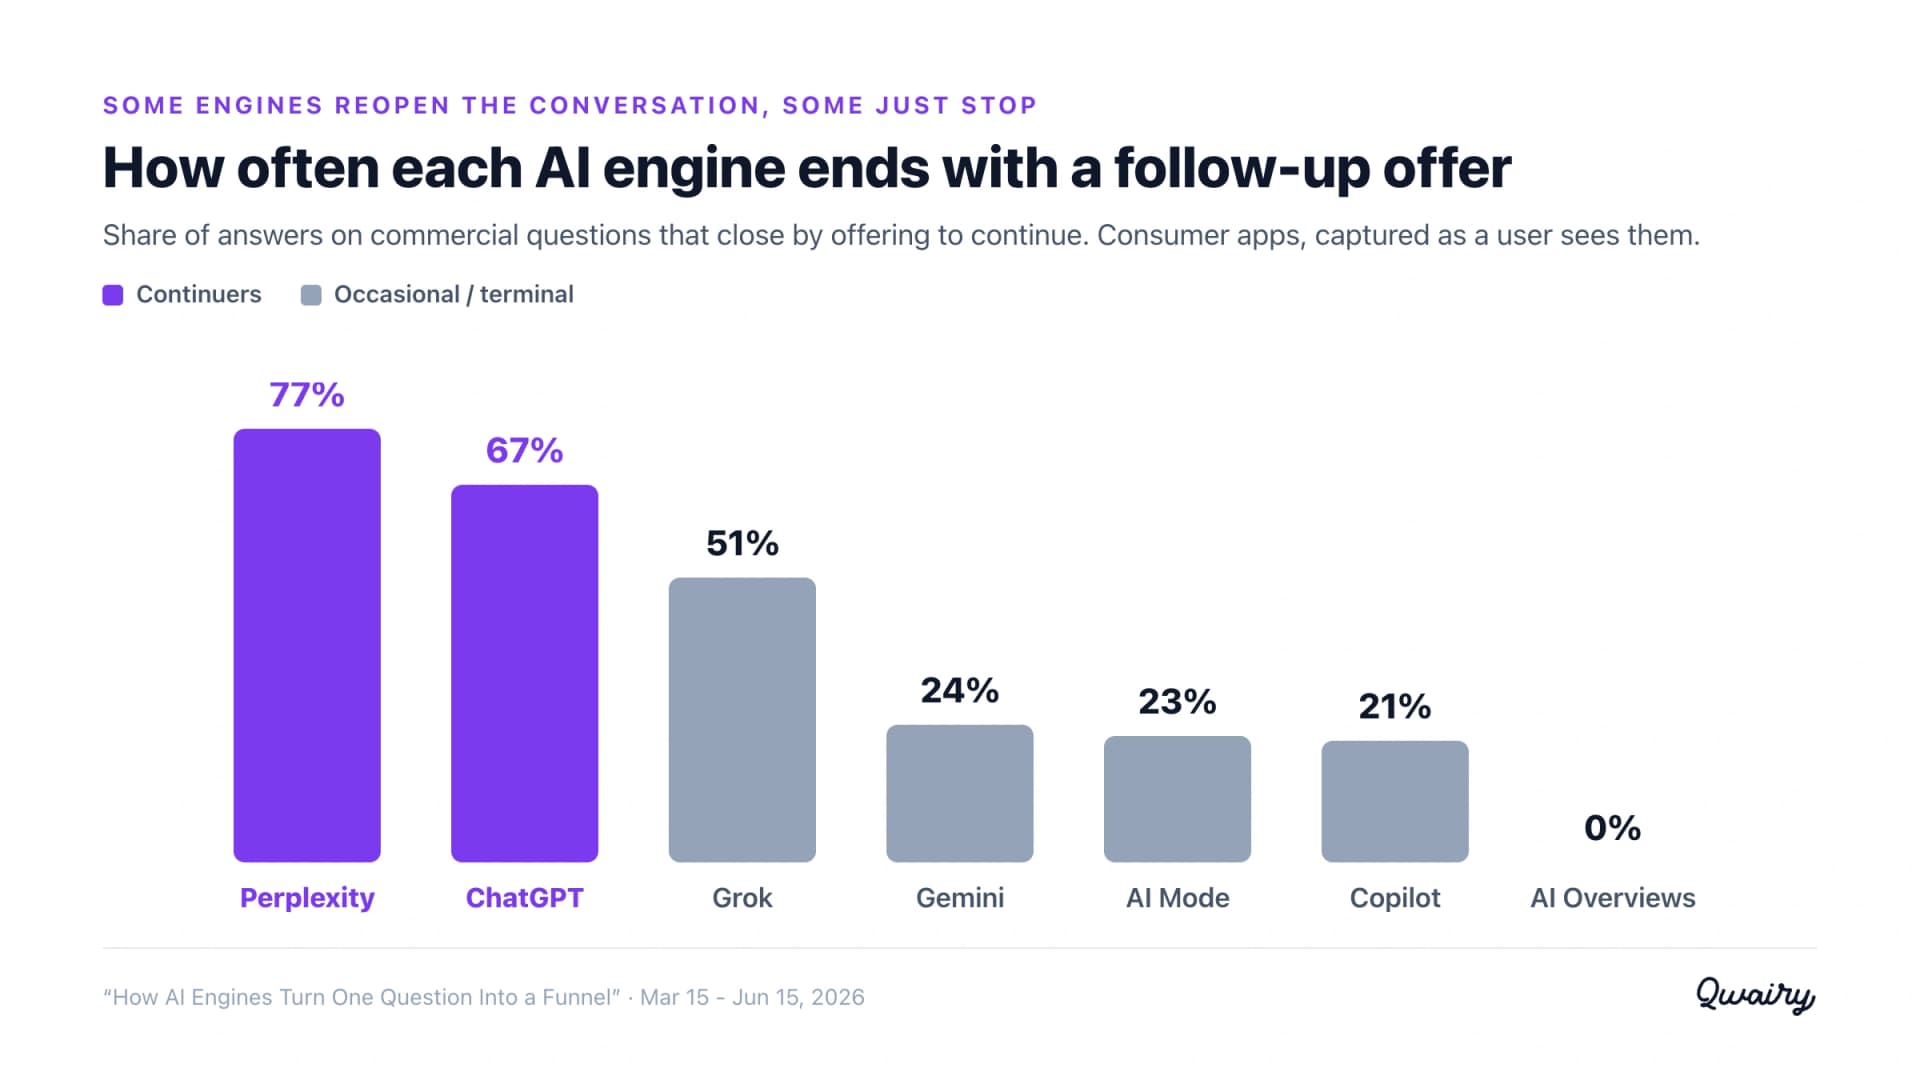
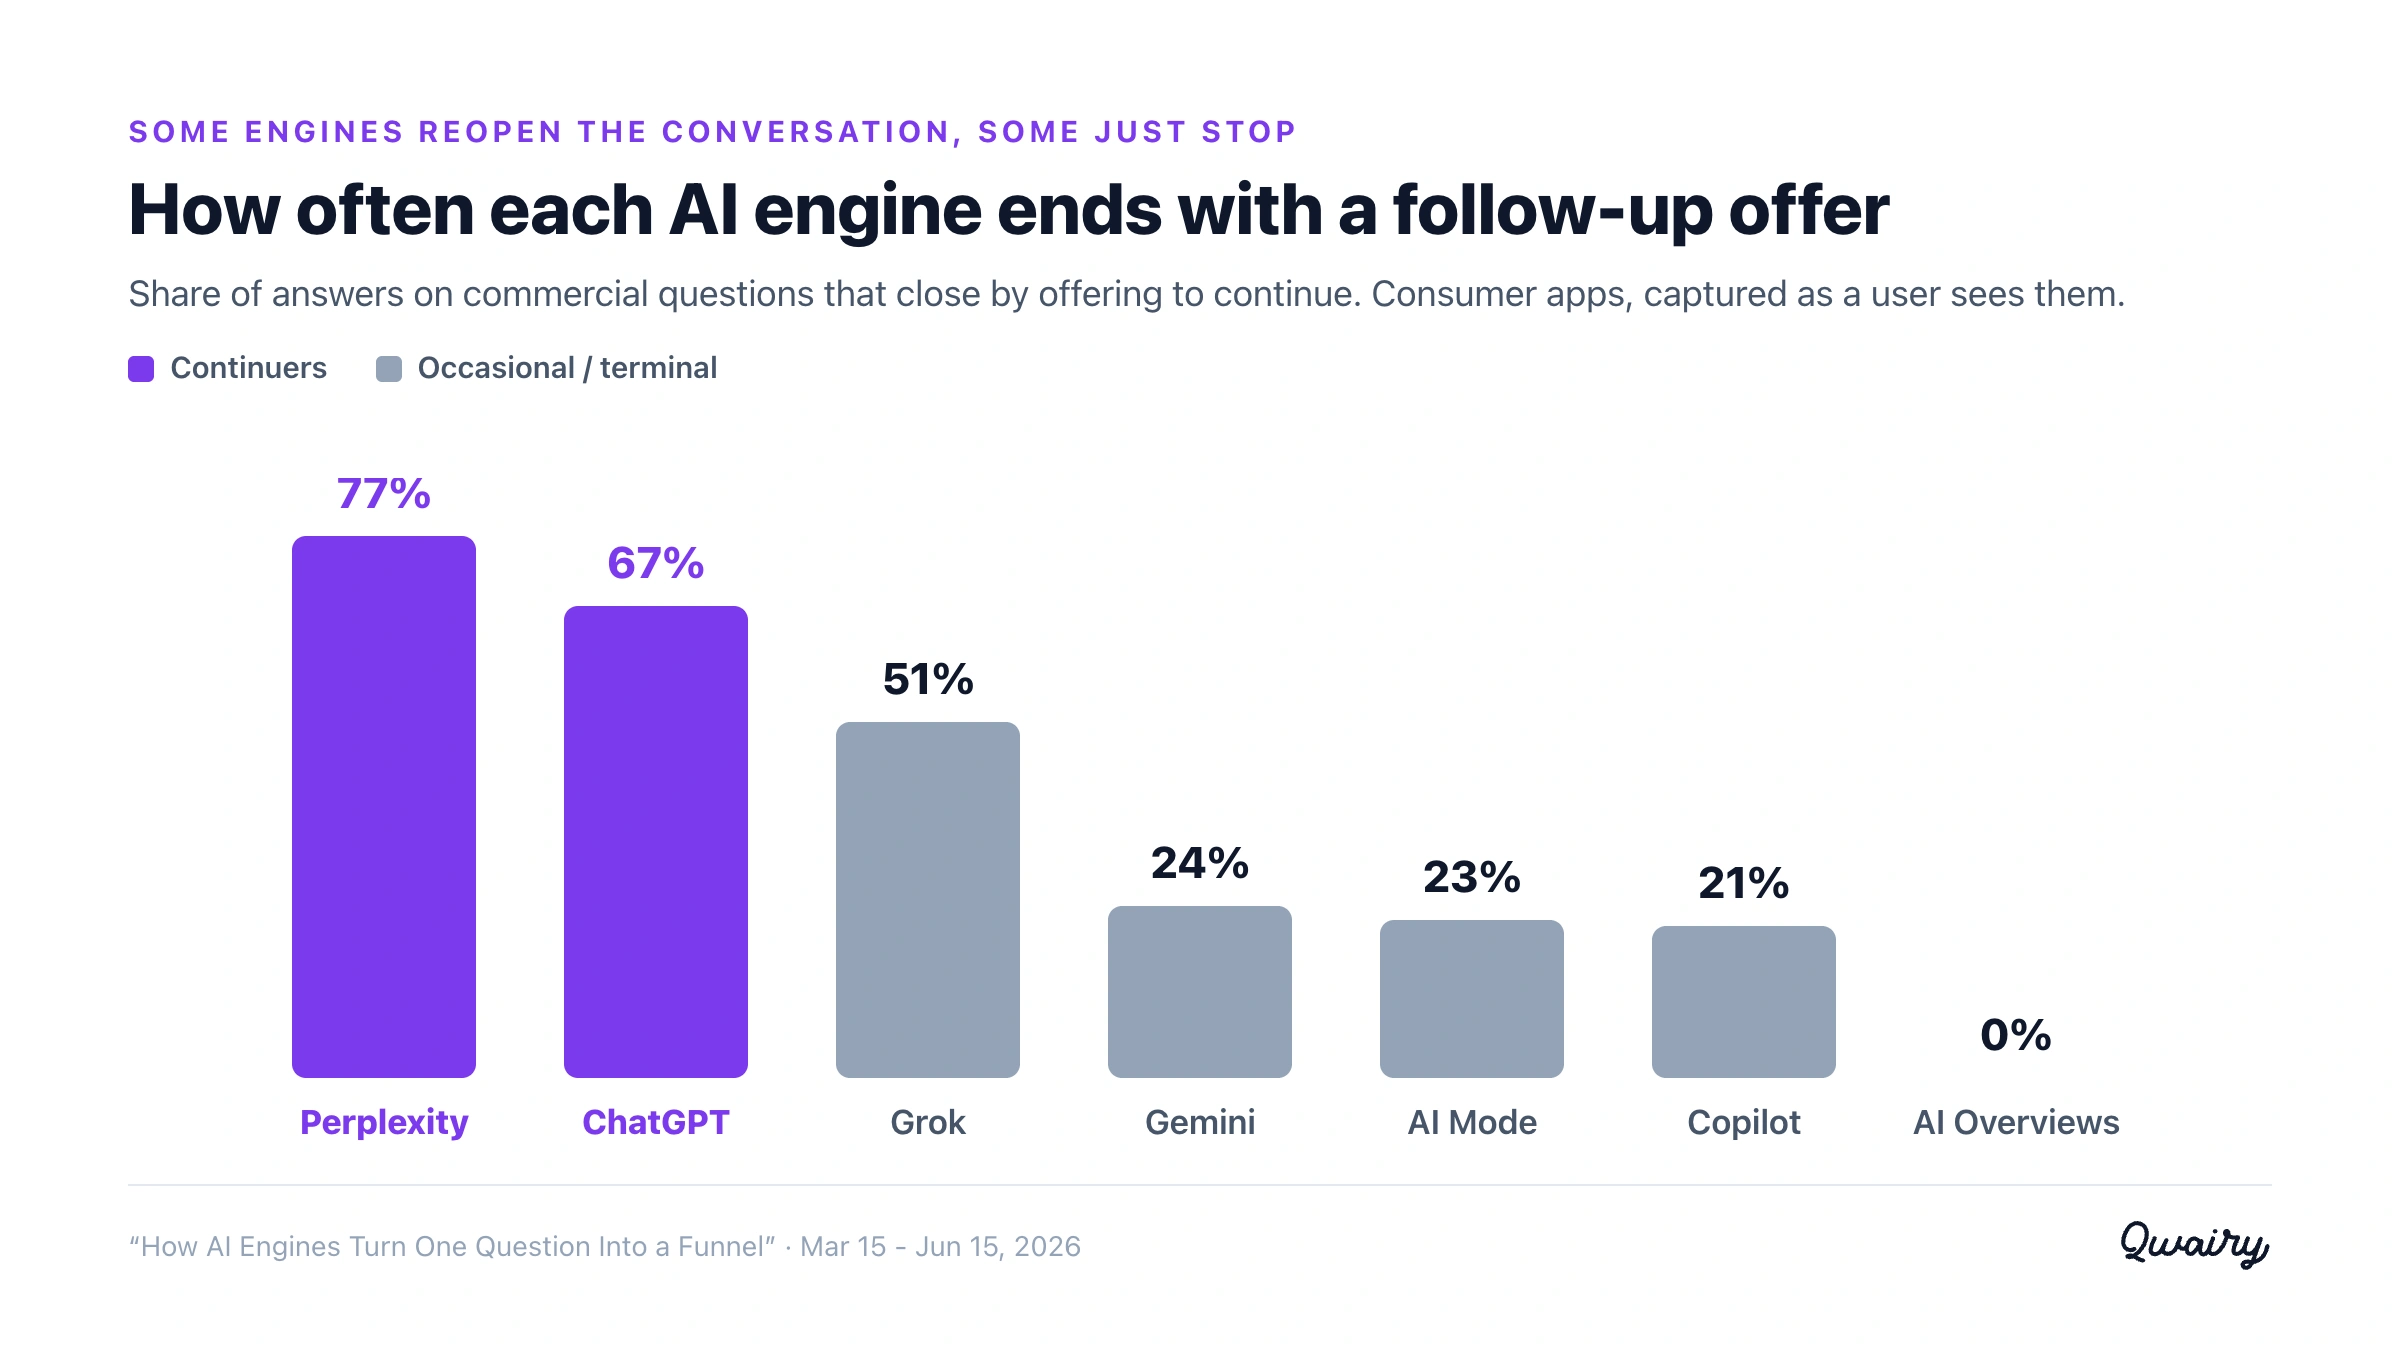
Parmi les assistants grand public, Perplexity (~77 %) et ChatGPT (~67 %) transforment la plupart des réponses en ouverture, tandis que Google AI Overviews (~0 %) et Gemini (~24 %) répondent le plus souvent puis s’arrêtent. Les moteurs que l’on utilise pour la découverte ouverte sont ceux qui rouvrent la conversation avec le plus d’insistance.
L’enjeu stratégique qui sous-tend ces deux constats est celui qui compte pour la visibilité : la première réponse n’est plus toute la partie. C’est de plus en plus le haut d’un tunnel que le moteur ouvre lui-même. Et comme les modèles de conversation s’appuient sur le tour précédent, les marques nommées dans cette première réponse sont en grande partie celles qui s’y retrouvent ensuite, ce que nous mesurons directement plus bas.
Une invitation finale n’est comptée que si elle apparaît dans la dernière portion de la réponse (les ~15 % de fin), de sorte que nous mesurons la façon dont un moteur termine, et non des formulations en « je peux » éparpillées dans le texte. Tout ce qui suit repose sur des taux calculés sur de nombreuses réponses, jamais sur des volumes bruts.
Périmètre. Les principaux moteurs IA que nous suivons : ChatGPT, Perplexity, Google Gemini, Microsoft Copilot, xAI Grok, Google AI Overviews, Google AI Mode, Anthropic Claude, Mistral et DeepSeek.
Une fenêtre de 90 jours (de la mi-mars à la mi-juin 2026), réponses terminées uniquement, marques suivies sur la plateforme.
L’unité d’analyse est la réponse individuelle, et nous regardons comment elle se termine.
Comment nous captons chaque moteur (cela compte). Nous captons la plupart des moteurs via leur produit grand public : ChatGPT, Perplexity, Gemini, Copilot, Grok ainsi que Google AI Overviews et AI Mode sont collectés tels qu’un utilisateur les voit. Quelques-uns (Claude, GPT via API, Mistral, DeepSeek) sont interrogés par API.
L’invitation à poursuivre relève largement d’un comportement de la couche produit : un choix inscrit dans les instructions et le réglage de l’application grand public, et non dans le modèle brut. Un moteur interrogé par API en montre donc bien moins que son application grand public.
Les ~7 % de Claude constituent donc un plancher, et non un verdict sur l’application grand public de Claude ; la comparaison à armes égales se fait entre les produits grand public, c’est là que nous ancrons le spectre.
Ce que nous mesurons, et ce que nous choisissons délibérément de ne pas mesurer. Nous classons si la fin d’une réponse (les ~15 % finaux du texte) contient une invitation à poursuivre : une formulation qui propose une étape suivante (affiner, développer, comparer ou faire davantage), en anglais ou en français, les deux langues qui dominent l’échantillon.
Nous classons chaque invitation dans une famille : affinage conditionnel (« si vous me dites X, je peux… »), proposition directe (« je peux aussi… »), proposition sous forme de question (« souhaitez-vous que je… »), passive (« dites-moi si… »), et nous signalons si la clôture prend la forme d’un menu à puces.
Nous ne prenons pas une réponse isolée pour la vérité sur un moteur (nous mesurons sur de nombreuses réponses et rapportons des taux), nous ne publions pas de volumes bruts, et nous limitons le détecteur à la fin de la réponse.
Commençons par ChatGPT, le moteur auquel la plupart des gens pensent quand ils parlent de « recherche IA ».
Sur la fenêtre, environ 67 % de ses réponses se terminent par une invitation à poursuivre, et ce taux n’est pas figé.
Suivi mois par mois, il est passé d’environ un tiers des réponses fin 2025 à environ deux tiers à la mi-2026. Il a à peu près doublé en huit mois.
Le chiffre global sous-estime l’expérience, car le taux n’est pas uniforme : il se concentre exactement là où les marques se font concurrence.
L’invitation à poursuivre n’est pas distribuée uniformément entre les questions. Elle suit à quel point la question ressemble à une décision.
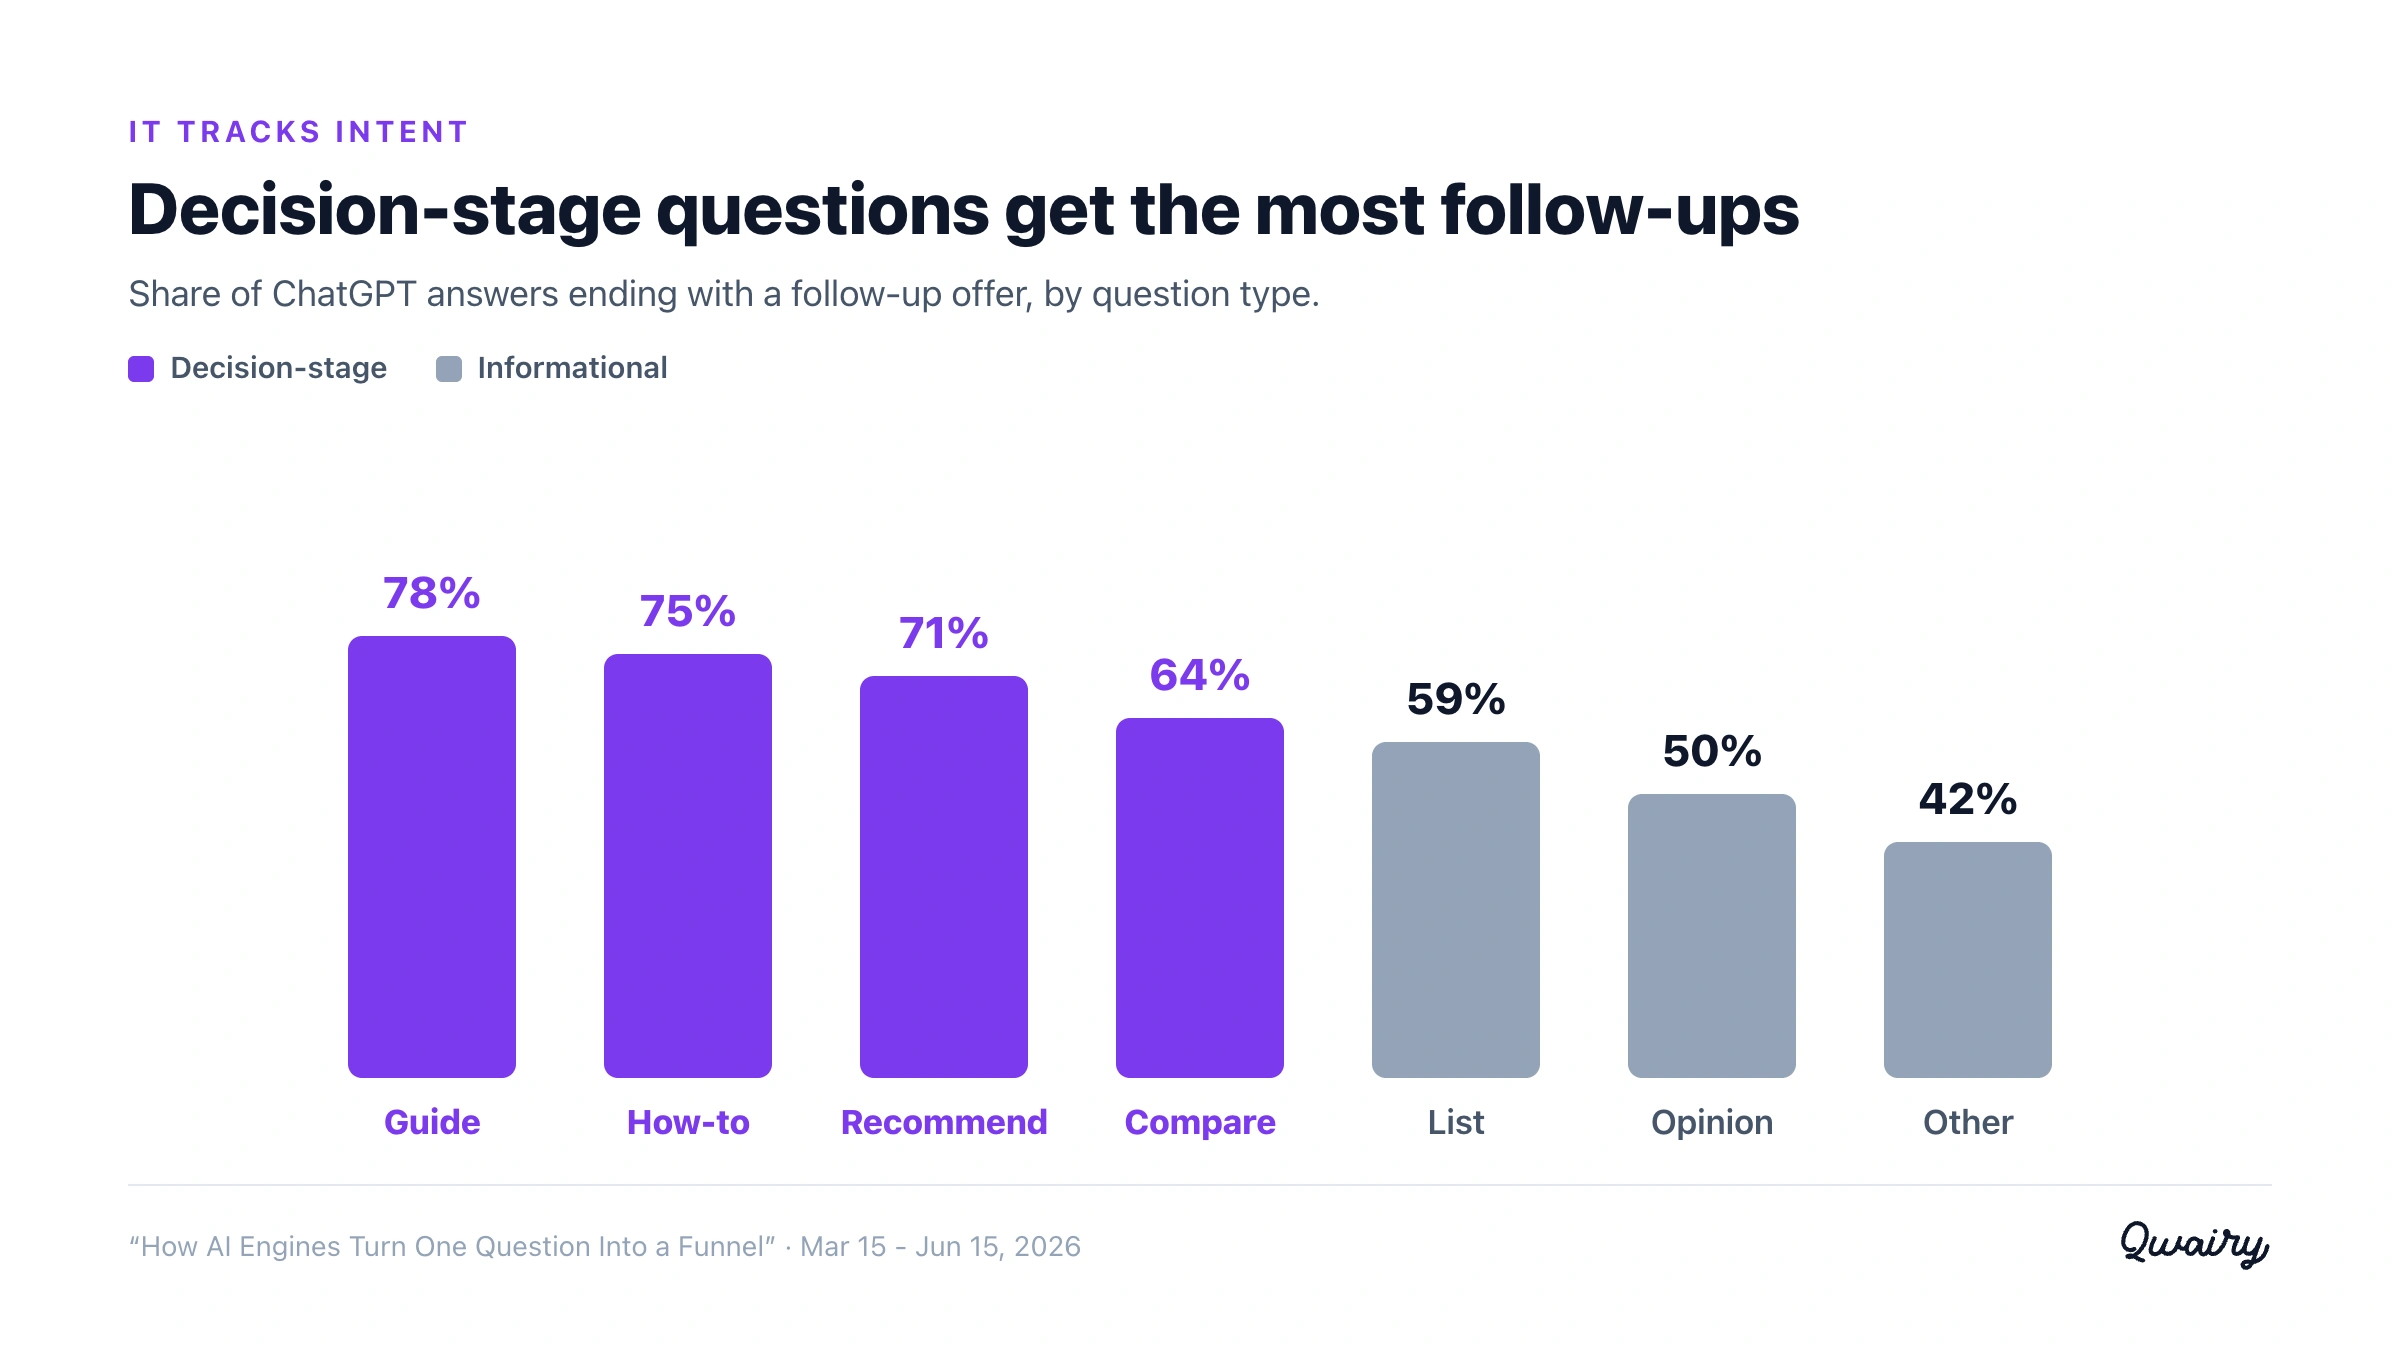
Type de question | Réponses de ChatGPT se terminant par une invitation à poursuivre |
Guide | ~78 % |
Guide pratique | ~75 % |
Recommandation | ~71 % |
Comparaison | ~64 % |
Liste | ~59 % |
Opinion | ~50 % |
Autre | ~42 % |
Demandez « qu’est-ce que X » et vous avez moins de chances de recevoir une proposition de continuer.
Demandez « quel X choisir » ou « comment faire X » (les questions où une marque peut être recommandée) et le moteur propose presque toujours de vous emmener plus loin. L’invitation est la plus dense précisément sur les requêtes commerciales, de l’étape de considération, qui sont l’objet du GEO.
Lancez un audit gratuit : en quelques minutes, ChatGPT, Gemini et Perplexity répondent en direct à 8 questions d’achat sur votre marché, et vous voyez qui ils recommandent.
Neuf invitations de ChatGPT sur dix relèvent du même mouvement : un affinage conditionnel.
Le moteur propose de personnaliser sa réponse si vous lui donnez quelques détails de plus, et il présente généralement ces détails sous forme de menu. Une clôture représentative :
Si vous me dites :
… alors je peux vous donner la procédure exacte et les frais éventuels.
Environ 73 % des invitations de ChatGPT prennent la forme d’un menu à puces de ce type, et non d’une phrase. Ce choix de format est discrètement important pour la visibilité : le menu est une carte des dimensions que le moteur juge déterminantes pour la décision (budget, région, usage, taille).
Ce sont les sous-requêtes sur lesquelles le tour affiné sera construit.
C’est ici que « l’IA fait X » s’effondre. Parmi les assistants grand public, captés exactement comme un utilisateur les voit, le comportement forme un spectre, et les moteurs se situent à des points très différents.
Moteur (tel que capté) | Invitation finale détectée, mars à juin 2026 | Mouvement type | Menu à puces |
Perplexity (grand public) | ~77 % | affinage conditionnel | 28 % |
ChatGPT (grand public) | ~67 % | affinage conditionnel | 73 % |
Mistral (API) | ~55 % | proposition directe | 86 % |
Grok (grand public) | ~51 % | proposition directe | 52 % |
Gemini (grand public) | ~24 % | question oui/non | 15 % |
Google AI Mode (grand public) | ~23 % | mixte | 55 % |
Copilot (grand public) | ~21 % | mixte / pastilles de choix | 56 % |
DeepSeek (API) | ~12 % | mixte | 52 % |
Claude (API) | ~7 % | s’engage rarement | 27 % |
Google AI Overviews (grand public) | ~0 % | jamais | - |
Des groupes nets se dégagent.
Ceux qui prolongent : Perplexity et ChatGPT.
Dans notre corpus de mars à juin 2026, Perplexity présente davantage d’invitations finales détectées que ChatGPT, généralement sous la forme d’une proposition intégrée au texte plutôt que d’un menu à puces : « Si vous me dites votre objectif et votre niveau d’entraînement actuel, je peux vous construire un plan simple et adapté et estimer un apport calorique cible. » ChatGPT préfère le menu à puces dans cet échantillon. Un benchmark Qwairy réalisé en octobre 2026 relève des invitations finales dans 15 % des réponses de Perplexity, contre environ 77 % ici. Les deux études visent les invitations écrites dans la réponse, mais leurs périodes, leurs questions et leurs méthodes de détection diffèrent. Ces taux ne permettent donc pas, à eux seuls, de mesurer une évolution de Perplexity.
Ceux qui proposent directement : Grok et Mistral. Ils proposent de faire davantage plutôt que de vous demander de préciser, souvent avec un point d’exclamation : « Si vous me dites votre région et votre secteur, je peux affiner ces recommandations avec des contacts plus ciblés ! »
Gemini, celui qui pose des questions. Gemini ne s’engage que sur environ un quart des réponses, et quand il le fait, c’est dans ~79 % des cas par une question fermée plutôt que par un menu d’affinage : « Souhaitez-vous que je compare les options de garantie pour un assureur en particulier ? » Le reste du temps, il s’arrête simplement.
Copilot, celui qui propose des pastilles. Quand Copilot poursuit, il présente souvent des choix explicites : « Souhaitez-vous que je compare directement les deux modèles, ou que j’affiche les annonces disponibles près de chez vous ? Comparer les modèles / Afficher les annonces locales. »
Ceux qui s’arrêtent : AI Overviews (et, tel que nous le captons, Claude).
Google AI Overviews ne propose en pratique jamais de suite (~0 %) : c’est un extrait statique, pas une conversation, donc il n’y a pas de tour suivant à ouvrir.
Claude, interrogé par API, ne termine par une invitation que dans ~7 % des cas : il tend à livrer une réponse complète et à s’arrêter sur une ligne déclarative. (Comme il s’agit de l’API et non de l’application grand public de Claude, considérez ~7 % comme un plancher.)
Le schéma qui mérite qu’on s’y arrête : les moteurs qui le font le plus sont ceux que les gens utilisent réellement pour la découverte ouverte.
Les portes d’entrée conversationnelles de l’IA, ChatGPT et Perplexity, sont précisément celles qui transforment une seule question en tunnel à plusieurs étapes.
Détaillez votre visibilité modèle par modèle pour voir où chaque IA vous mentionne, et où elle ne le fait pas.
Tout ce qui précède mesure la façon dont les réponses se terminent.
L’affirmation stratégique, selon laquelle les marques nommées dans la première réponse se retrouvent dans le tour affiné, est une question distincte, à laquelle notre corpus de suivi ne peut pas répondre, car il est à tour unique. Nous avons donc construit le tour manquant.
Nous avons soumis 80 questions commerciales à un modèle de conversation (gpt-5) sous forme de vraies conversations en deux tours.
Tour 1 : la question. Tour 2 : accepter l’invitation à poursuivre et lui demander de resserrer sur un top trois.
En face, un témoin à froid : la même demande affinée, sans historique, avec un modèle neuf et sans première réponse sur laquelle s’appuyer.
Le test : la présélection de la conversation prolongée s’appuie-t-elle davantage sur les marques de la première réponse que celle du témoin à froid ?
Oui, avec une limite claire.
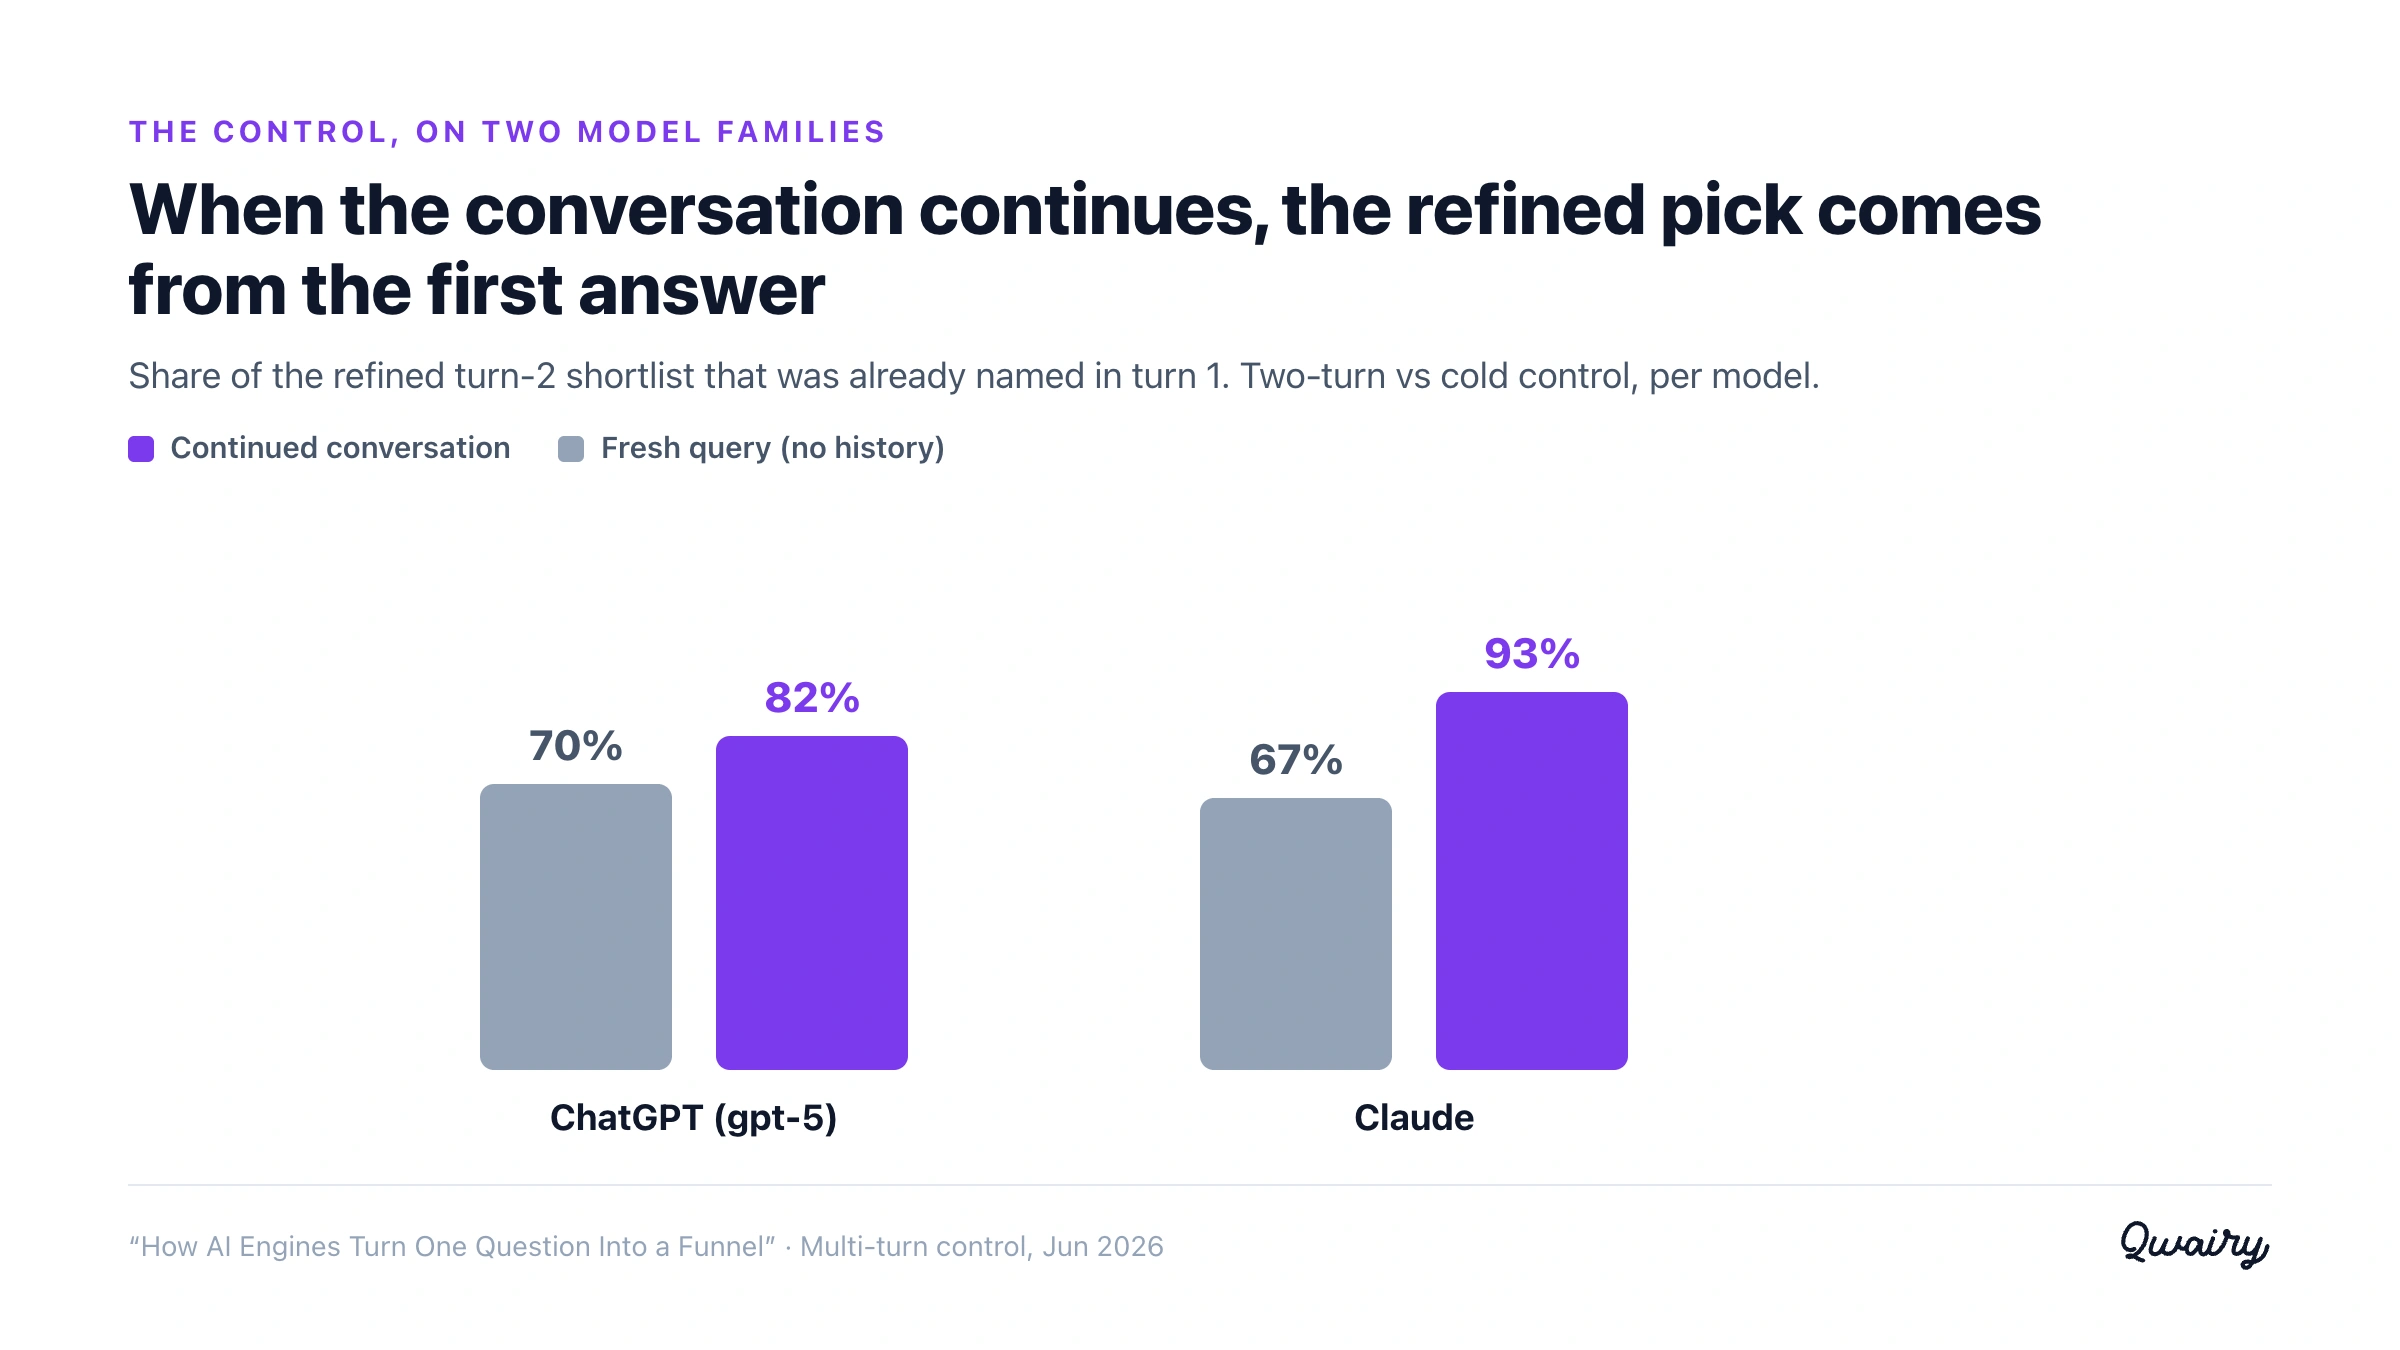
Le tunnel est donc réel, et borné.
Dans les catégories de consensus, avec un seul groupe de leaders dominants, cela change à peine les choses : vous seriez nommé dans les deux cas.
Dans les catégories fragmentées et concurrentielles, précisément là où un challenger a quelque chose à gagner ou à perdre, la première réponse est en grande partie la réponse affinée, et l’affinage laisse rarement un nouvel entrant revenir.
Cela se vérifie d’une famille de modèles à l’autre. Nous avons relancé le témoin sur un second modèle (Claude), et le report était plutôt plus fort : la présélection de la conversation prolongée était tirée à ~93 % de la première réponse contre ~67 % à froid, soit un effet de +26 points qui a favorisé la première réponse 11 contre 1 sur les questions où les deux tours divergeaient.
Fait révélateur, ce même modèle ne propose de suite de lui-même que dans ~13 % des cas, ce qui est cohérent avec son profil de moteur qui s’arrête, évoqué plus haut.
Cela sépare nettement les deux phénomènes : qu’un moteur rouvre ou non la conversation est un choix de produit, mais une fois qu’elle est rouverte, les marques du tour précédent se retrouvent dans les deux cas.
Deux limites, en toute transparence. Nous avons testé le mécanisme via les API des modèles, et non les applications grand public : il s’agit donc de la façon dont un modèle de conversation s’appuie sur son propre tour précédent, un comportement fondamental plutôt que propre à un produit.
Et l’effet (+12 à +26 points selon les deux modèles) est prudent : il est tiré vers zéro par les catégories de consensus qui font égalité en tête. (En contrôle supplémentaire, gpt-5 a lui-même terminé 63 % de ces réponses du premier tour par une invitation à poursuivre, en phase avec les ~67 % que nous mesurons en conditions réelles.)
Gagnez la première réponse, car elle amorce la seconde. Quand un utilisateur accepte une invitation à poursuivre, le tour affiné tire ~82 % de ses choix des marques de la première réponse, contre ~70 % pour une requête à froid sans historique (voir la partie 5).
Figurer dans la réponse initiale n’est plus une simple impression : c’est votre billet d’entrée dans le tour affiné, et une marque qui en est absente y revient rarement. Optimisez votre présence sur la requête commerciale large, et pas seulement sur celle de longue traîne.
Lisez le menu comme une carte de mots-clés. Les dimensions selon lesquelles un moteur propose d’« affiner » (budget, région, usage, taille) sont les sous-requêtes que le tour suivant va lancer. Elles vous disent, pour chaque catégorie, sur quelles variantes qualifiées (« meilleur X à petit budget », « meilleur X pour tel usage », « X dans telle région ») vous devez aussi être présent.
Planifiez par moteur, et non pour « l’IA ». Un moteur riche en invitations (ChatGPT, Perplexity) récompense les contenus qui correspondent clairement aux dimensions d’affinage et se recombinent d’un tour à l’autre. Une surface terminale (AI Overviews) récompense une réponse unique, complète et bien sourcée, car il n’y a pas de second tour à gagner. La même stratégie de contenu ne sert pas les deux.
Suivez la clôture, pas seulement le corps de la réponse. Le fait qu’un moteur propose de continuer, et la manière dont il le fait, est en soi un signal qui évolue dans le temps : le taux de ChatGPT a doublé en huit mois. Il modifie le parcours des utilisateurs de la question au choix, et mérite d’être suivi comme une métrique à part entière, moteur par moteur.
Réalité : sur les moteurs grand public les plus utilisés, deux à trois réponses sur quatre se terminent par une proposition de continuer, et quand la conversation se poursuit, le choix affiné est tiré à ~82 % de la première réponse (contre ~70 % pour une requête à froid, voir la partie 5).
Réalité : parmi les produits grand public, le taux d’invitations à poursuivre va de ~0 % (Google AI Overviews) à ~77 % (Perplexity) sur les mêmes types de questions. Une surface répond et s’arrête ; une autre rouvre presque à chaque fois. « L’IA » n’est pas un comportement unique.
Réalité : le menu à puces est une carte des dimensions de décision que le moteur utilisera pour affiner : budget, région, usage. Il vous dit sur quelles sous-requêtes qualifiées vous devez aussi l’emporter.
Réalité : nous mesurons sur les questions commerciales, pertinentes pour les marques, et le taux varie selon l’intention de ~42 % à ~78 %. C’est le taux sur les questions qui déterminent la visibilité, et non une affirmation sur toutes les conversations de ChatGPT.
Périmètre : les principaux moteurs IA suivis sur Qwairy (ChatGPT, Perplexity, Google Gemini, Microsoft Copilot, xAI Grok, Google AI Overviews, Google AI Mode, Anthropic Claude, Mistral et DeepSeek) sur une fenêtre de 90 jours (de la mi-mars à la mi-juin 2026), réponses terminées uniquement. La tendance mensuelle de ChatGPT s’appuie sur une fenêtre plus longue, remontant à fin 2025.
Méthodologie : nous classons la fin de chaque réponse (les ~15 % finaux du texte) selon qu’elle contient ou non une invitation à poursuivre : une formulation qui propose une étape suivante (affiner, développer, comparer, faire davantage), détectée en anglais et en français, les deux langues dominantes de l’échantillon. Chaque invitation est rangée par priorité dans une seule famille (affinage conditionnel, proposition directe, proposition sous forme de question, passive) et signalée comme menu à puces lorsque la clôture contient au moins deux éléments de liste. Nous rapportons des taux sur de nombreuses réponses par moteur ; les chiffres sont arrondis. La plupart des moteurs sont captés via leur produit grand public ; Claude, GPT-API, Mistral et DeepSeek sont interrogés par API.
Vous voulez voir comment chaque moteur IA termine ses réponses sur votre marque : s’il rouvre la conversation, et avec quelles dimensions d’affinage, mesurées sur des exécutions répétées plutôt que par des vérifications ponctuelles ? Qwairy suit les mentions de marque, la position, les citations et le comportement des réponses sur ChatGPT, Perplexity, Google AI, Claude, Gemini et des fournisseurs en nombre croissant.
Suivez les questions qui comptent pour votre activité, voyez quelles marques chaque réponse mentionne et quelles sources elle cite, puis travaillez sur les manques.
Offre gratuite avec 120 crédits initiaux • Sans carte bancaire
Autres articles
AI Overviews en France : ce que Google cite vraiment, face aux États-Unis
Qwairy et Converteo ont analysé 12 120 réponses AI Overviews en France et aux États-Unis : requêtes déclenchantes, sources citées, autorité et volatilité.
Questions de suivi IA : la première réponse n’est pas la décision
72 % des réponses IA invitent à poser une autre question, et la présélection se rebat quand l’acheteur répond. Le benchmark Qwairy montre ce que décide ce tour.