Loading page

Deux angles morts rendent un suivi ponctuel trompeur : Google compte deux surfaces IA opposées, AI Overview et AI Mode, et aucune ne répond deux fois pareil.
Tout le monde parle de ChatGPT et de Perplexity. Presque personne ne parle de la plus grande surface de recherche IA.
Lors de Google I/O 2026 , Google a indiqué qu’AI Overviews touche désormais plus de 2,5 milliards d’utilisateurs mensuels , et qu’AI Mode a dépassé le milliard d’utilisateurs mensuels à peine un an après son lancement, avec des requêtes qui plus que doublent chaque trimestre.
AI Overviews seul est plus grand que ChatGPT, Claude et Perplexity réunis, et AI Mode, au-delà du milliard d’utilisateurs, est en train de le rattraper.
La conversation sur le GEO est donc focalisée sur le mauvais écran.
Mais le problème de fond n’est pas quel écran vous surveillez, c’est la manière dont vous le lisez. Deux angles morts structurels rendent un suivi ponctuel de la visibilité IA bien moins fiable que ne le pensent les équipes, et les deux se cachent dans les chiffres de Google.
Angle mort n° 1 : Google n’est pas une surface IA mais deux, et elles se comportent à l’opposé l’une de l’autre. AI Overview (l’extrait en haut des résultats) et AI Mode (l’expérience de recherche conversationnelle) nomment un nombre différent de marques, avec des longueurs différentes, à partir de sources différentes.
Angle mort n° 2 : aucune des deux surfaces ne répond deux fois de la même façon. Posez exactement la même question une seconde fois et le verdict sur la mention de votre marque change dans une large part des cas. Il en va de même sur ChatGPT et Perplexity.
Nous avons mesuré les deux sur les sept grandes surfaces IA, sur des marques en production que nous suivons en continu, chaque prompt étant exécuté à répétition plutôt que vérifié une seule fois. La conclusion pour quiconque suit la visibilité IA : une seule vérification, sur une seule surface, ne capte ni la surface que vous manquez ni le bruit de celle que vous observez.
Nous mesurons le contenu de la réponse que chaque surface renvoie pour une marque suivie : sa longueur, le nombre de marques concurrentes qu’elle nomme, les sources qu’elle cite, et si elle nomme la marque ou non, sur des exécutions répétées. Nous ne mesurons pas la fréquence d’apparition d’un AI Overview sur une recherche Google (un taux d’apparition), et nous expliquons pourquoi dans la méthodologie.
Cette étude mesure le contenu des réponses capté par notre plateforme : longueur de la réponse, mentions de concurrents, sources citées et mention de la marque par exécution, lus à partir du texte de la réponse lui-même. Nous rapportons des mesures relatives, des taux, des ratios et des moyennes par réponse, plutôt que des volumes bruts.
Nous ne rapportons volontairement pas de taux d’apparition d’AI Overview (« X % des recherches Google affichent un AI Overview »). Un taux d’apparition fiable exige de journaliser chaque recherche effectuée, y compris celles où aucune surface IA n’est déclenchée, afin d’avoir un dénominateur.
Notre jeu de données enregistre la réponse IA quand il y en a une à enregistrer ; il n’est pas conçu pour compter les recherches qui n’ont rien renvoyé. Tous les chiffres de cette étude sont conditionnels à l’existence d’une réponse.
Nous ne mettons pas non plus en avant, comme constat structurel, le désaccord par requête entre surfaces. La tentation existe (lorsqu’au moins une surface mentionne la marque, deux surfaces divergent sur le fait de la nommer dans ~45-48 % des cas), mais une grande partie de ce désaccord par requête relève du même bruit d’une exécution à l’autre que celui documenté dans l’angle mort n° 2, et non d’une propriété stable des surfaces. La comparaison structurelle honnête porte sur les taux agrégés, où le bruit s’annule. C’est ce que nous rapportons.
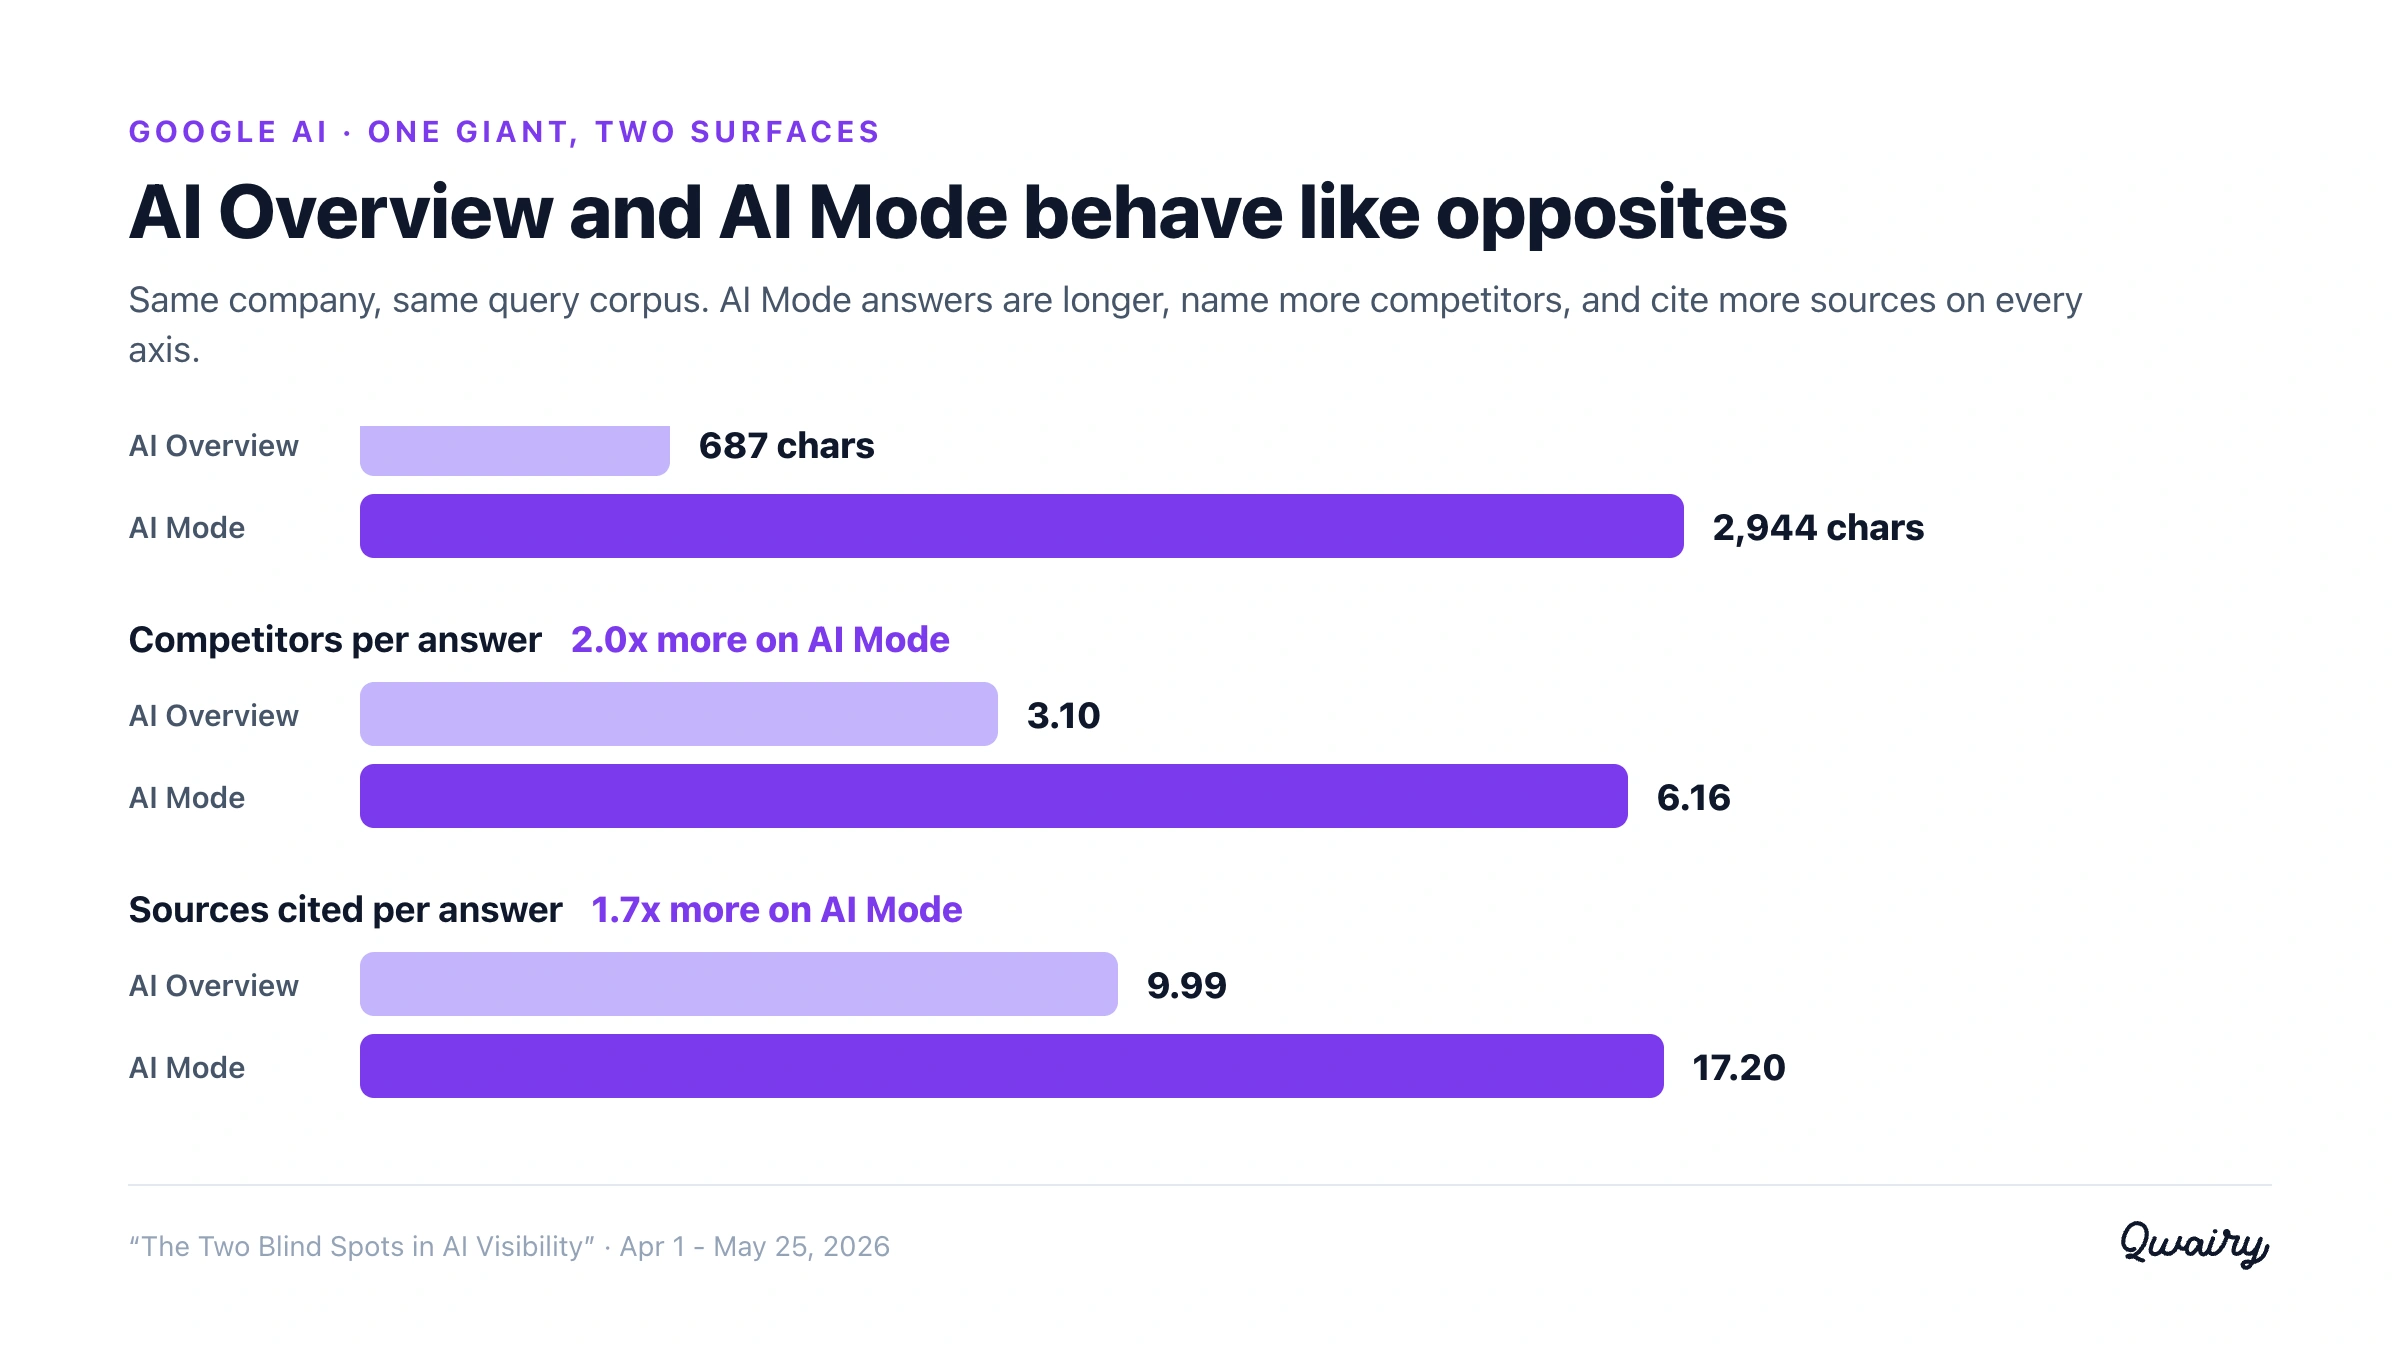
Les deux surfaces de Google divergent sur tous les axes structurels que nous avons mesurés.
Indicateur | AI Overview | AI Mode | Écart |
Longueur médiane de la réponse | 687 caractères (~110 mots) | 2 944 caractères (~470 mots) | ~4,3 fois plus longue |
Taux de mention de concurrents | 73,7 % | 82,1 % | +8,4 points |
Concurrents moyens / réponse | 3,10 | 6,16 | ~2,0 fois plus |
Sources moyennes / réponse | 9,99 | 17,20 | ~1,7 fois plus |
Réponses avec une source | 96,3 % | 97,6 % | quasi universel pour les deux |
La forme raconte l’histoire. AI Overview est un extrait : une synthèse courte en haut des résultats (médiane de ~110 mots) qui nomme une poignée de marques. AI Mode est une destination : une réponse longue et conversationnelle (médiane de ~470 mots) qui se comporte bien plus comme un assistant de chat, nomme deux fois plus de marques et mobilise bien plus de sources. Dans l’esprit des utilisateurs, elles occupent la même barre de recherche Google, mais pour une marque ce sont deux jeux différents. Une marque peut être visible dans l’une et presque absente de l’autre. Une remarque de transparence sur la longueur : la longueur moyenne des réponses d’AI Mode dépasse très largement la médiane (une minorité de réponses très longues tire la moyenne au-delà de 10 000 caractères). Nous rapportons partout la médiane, car c’est le centre honnête de la distribution.
Lancez un audit gratuit : en quelques minutes, ChatGPT, Gemini et Perplexity répondent en direct à 8 questions d’achat sur votre marché, et vous voyez qui ils recommandent.
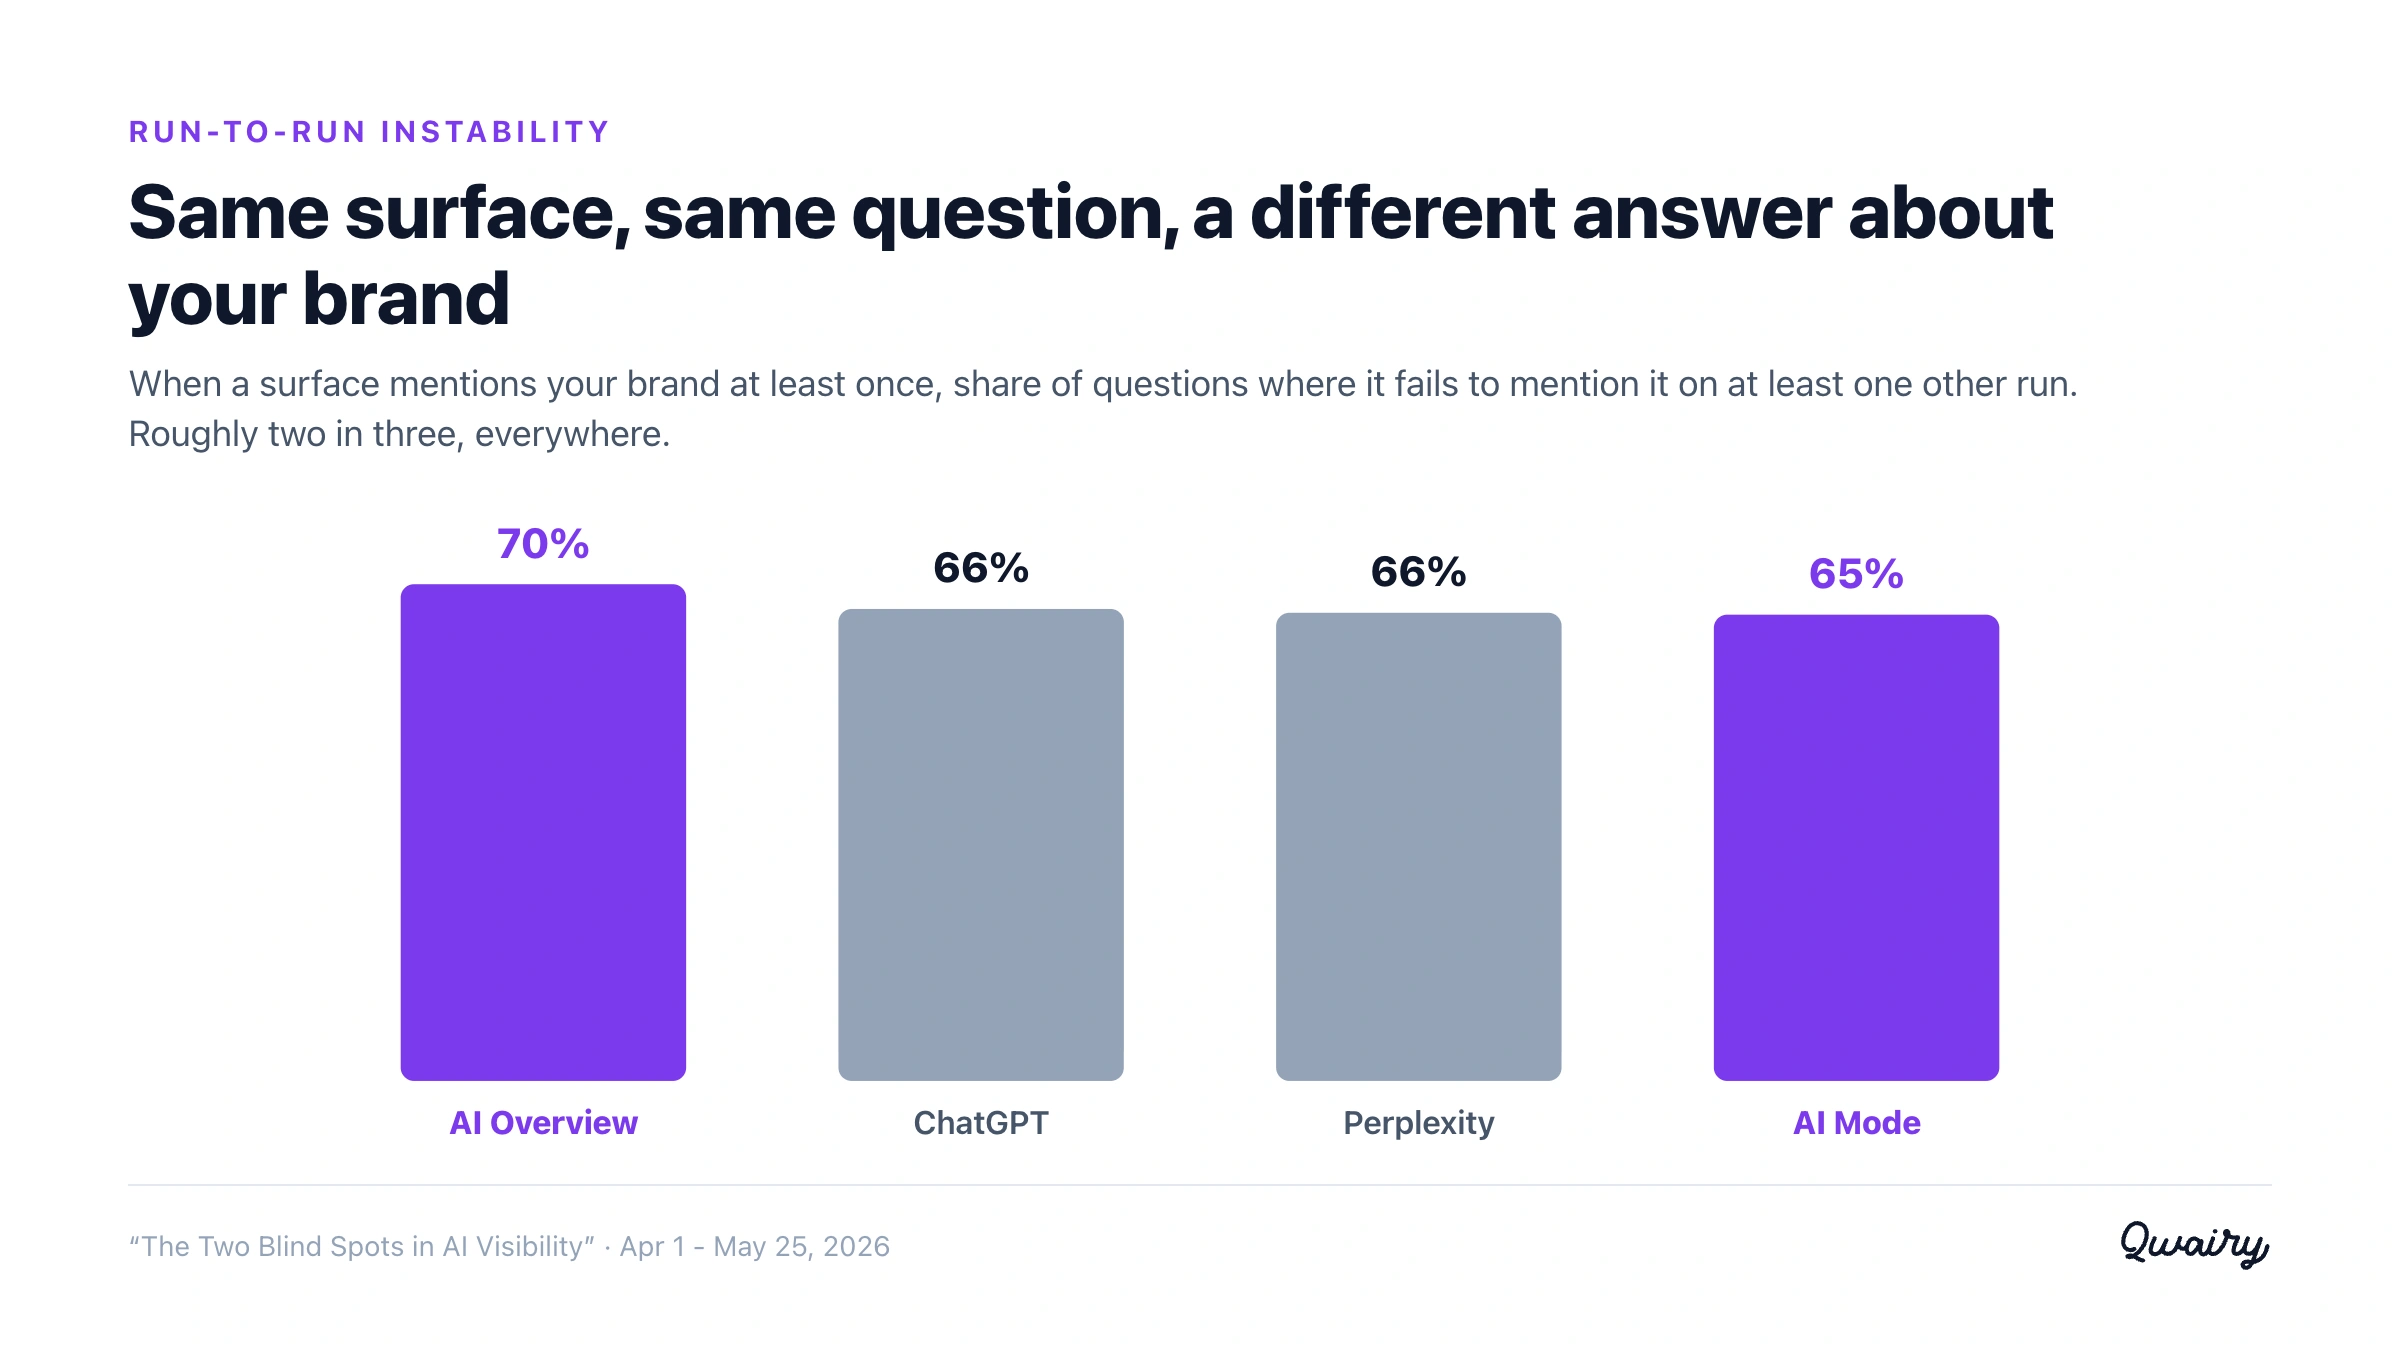
Voici le constat le plus susceptible de changer votre lecture de n’importe quel chiffre de visibilité IA. Comme nous exécutons chaque prompt plusieurs fois par surface, nous pouvons poser une question simple : quand une surface mentionne votre marque lors d’une exécution, la mentionne-t-elle à la suivante ? Souvent, non.
Surface | Questions où le verdict change d’une exécution à l’autre | Parmi les questions où la marque apparaît au moins une fois, part incohérente d’une exécution à l’autre |
AI Overview | 24,7 % | 69,5 % |
AI Mode | 24,7 % | 65,3 % |
OpenAI ChatGPT | 21,8 % | 66,0 % |
Perplexity | 20,6 % | 65,5 % |
Sur environ 1 question sur 4, une surface donne un verdict incohérent sur votre marque d’une de ses exécutions à l’autre : présente dans certaines, absente dans d’autres. Et lorsque l’on se restreint aux questions où la marque apparaît au moins une fois, l’incohérence est la règle, pas l’exception : environ 2 questions sur 3 sont instables d’une exécution à l’autre. Cela vaut pour chaque surface que nous avons testée, Google ou non. La conséquence pratique est brutale.
Une vérification isolée relève presque du pile ou face. « J’ai demandé à ChatGPT et il ne nous a pas mentionnés » n’est pas une preuve d’invisibilité : c’est un tirage dans une distribution. La seule lecture fiable est un taux mesuré sur de nombreuses exécutions, ce qui rend d’emblée dignes de confiance les différences structurelles de la partie 1 : les réponses individuelles sont bruitées, on en fait donc la moyenne sur assez d’exécutions pour que le signal se stabilise. C’est tout l’argument en faveur d’une mesure systématique et répétée plutôt que de prompts ponctuels.
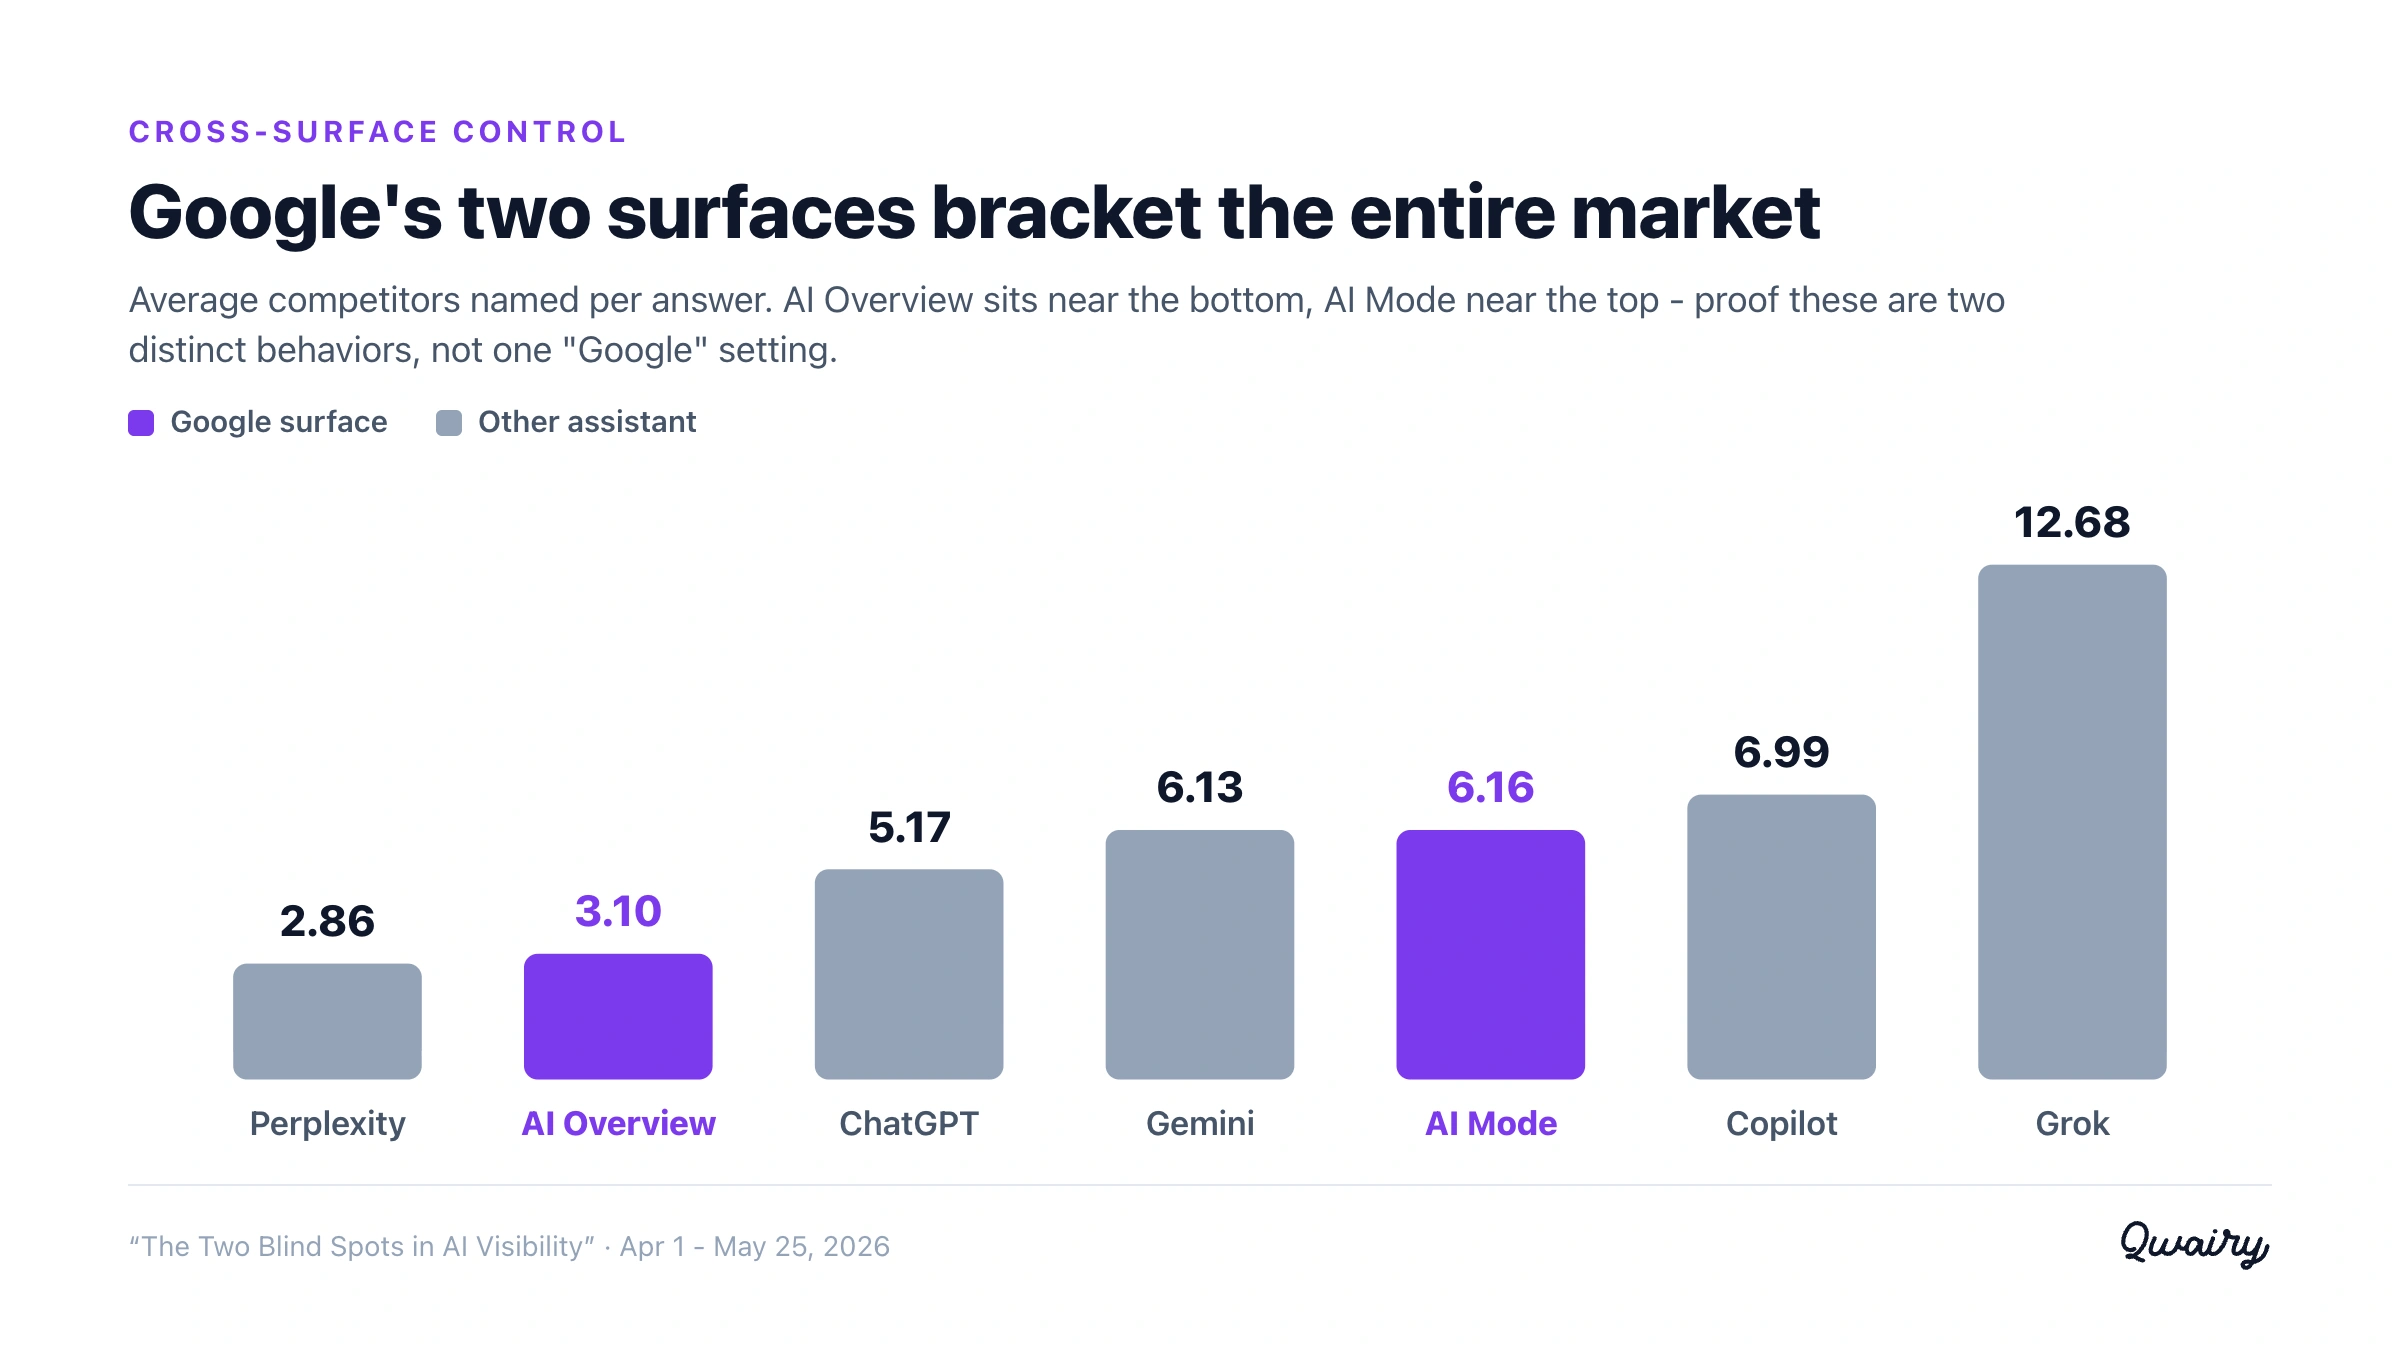
Si les réponses individuelles sont aussi bruitées, comment savoir que l’écart entre AI Overview et AI Mode de la partie 1 est réel et pas un bruit supplémentaire ? Parce que les taux agrégés sur assez d’exécutions répétées sont stables, et que l’on voit chaque surface se stabiliser sur un profil distinct. Le témoin inter-surfaces le rend visible : en appliquant la même mesure à cinq autres assistants, sur les mêmes marques et la même fenêtre, chacun se place à son propre niveau stable.
Surface | Taux de mention | Concurrents moyens / réponse | Sources moyennes / réponse |
Perplexity | 63,9 % | 2,86 | 9,61 |
Google AI Overview | 73,7 % | 3,10 | 9,99 |
OpenAI ChatGPT | 72,8 % | 5,17 | 4,16 |
Google Gemini | 78,6 % | 6,13 | 1,31 |
Google AI Mode | 82,1 % | 6,16 | 17,20 |
Microsoft Copilot | 92,7 % | 6,99 | 3,51 |
xAI Grok | 94,5 % | 12,68 | 43,34 |
Les deux surfaces de Google se situent aux deux extrémités du peloton : AI Overview est la deuxième surface la plus sélective que nous mesurons, AI Mode l’une des plus fournies, avec trois autres assistants dans l’intervalle. C’est aussi la vérification de l’artefact : si l’écart entre AI Overview et AI Mode tenait à notre façon de collecter chaque surface, cinq assistants indépendants ne s’intercaleraient pas proprement entre les deux. Or c’est le cas. « Google » n’est pas un réglage : ce sont deux produits aux rôles différents, et l’écart est structurel.
Voyez les domaines et les pages cités dans les réponses à vos prompts, et la fréquence de chacun.
Les deux surfaces de Google nomment plus de marques sur les questions à intention commerciale que sur les questions informationnelles, selon le schéma universel du parcours d’achat. Mais AI Overview discrimine bien plus nettement.
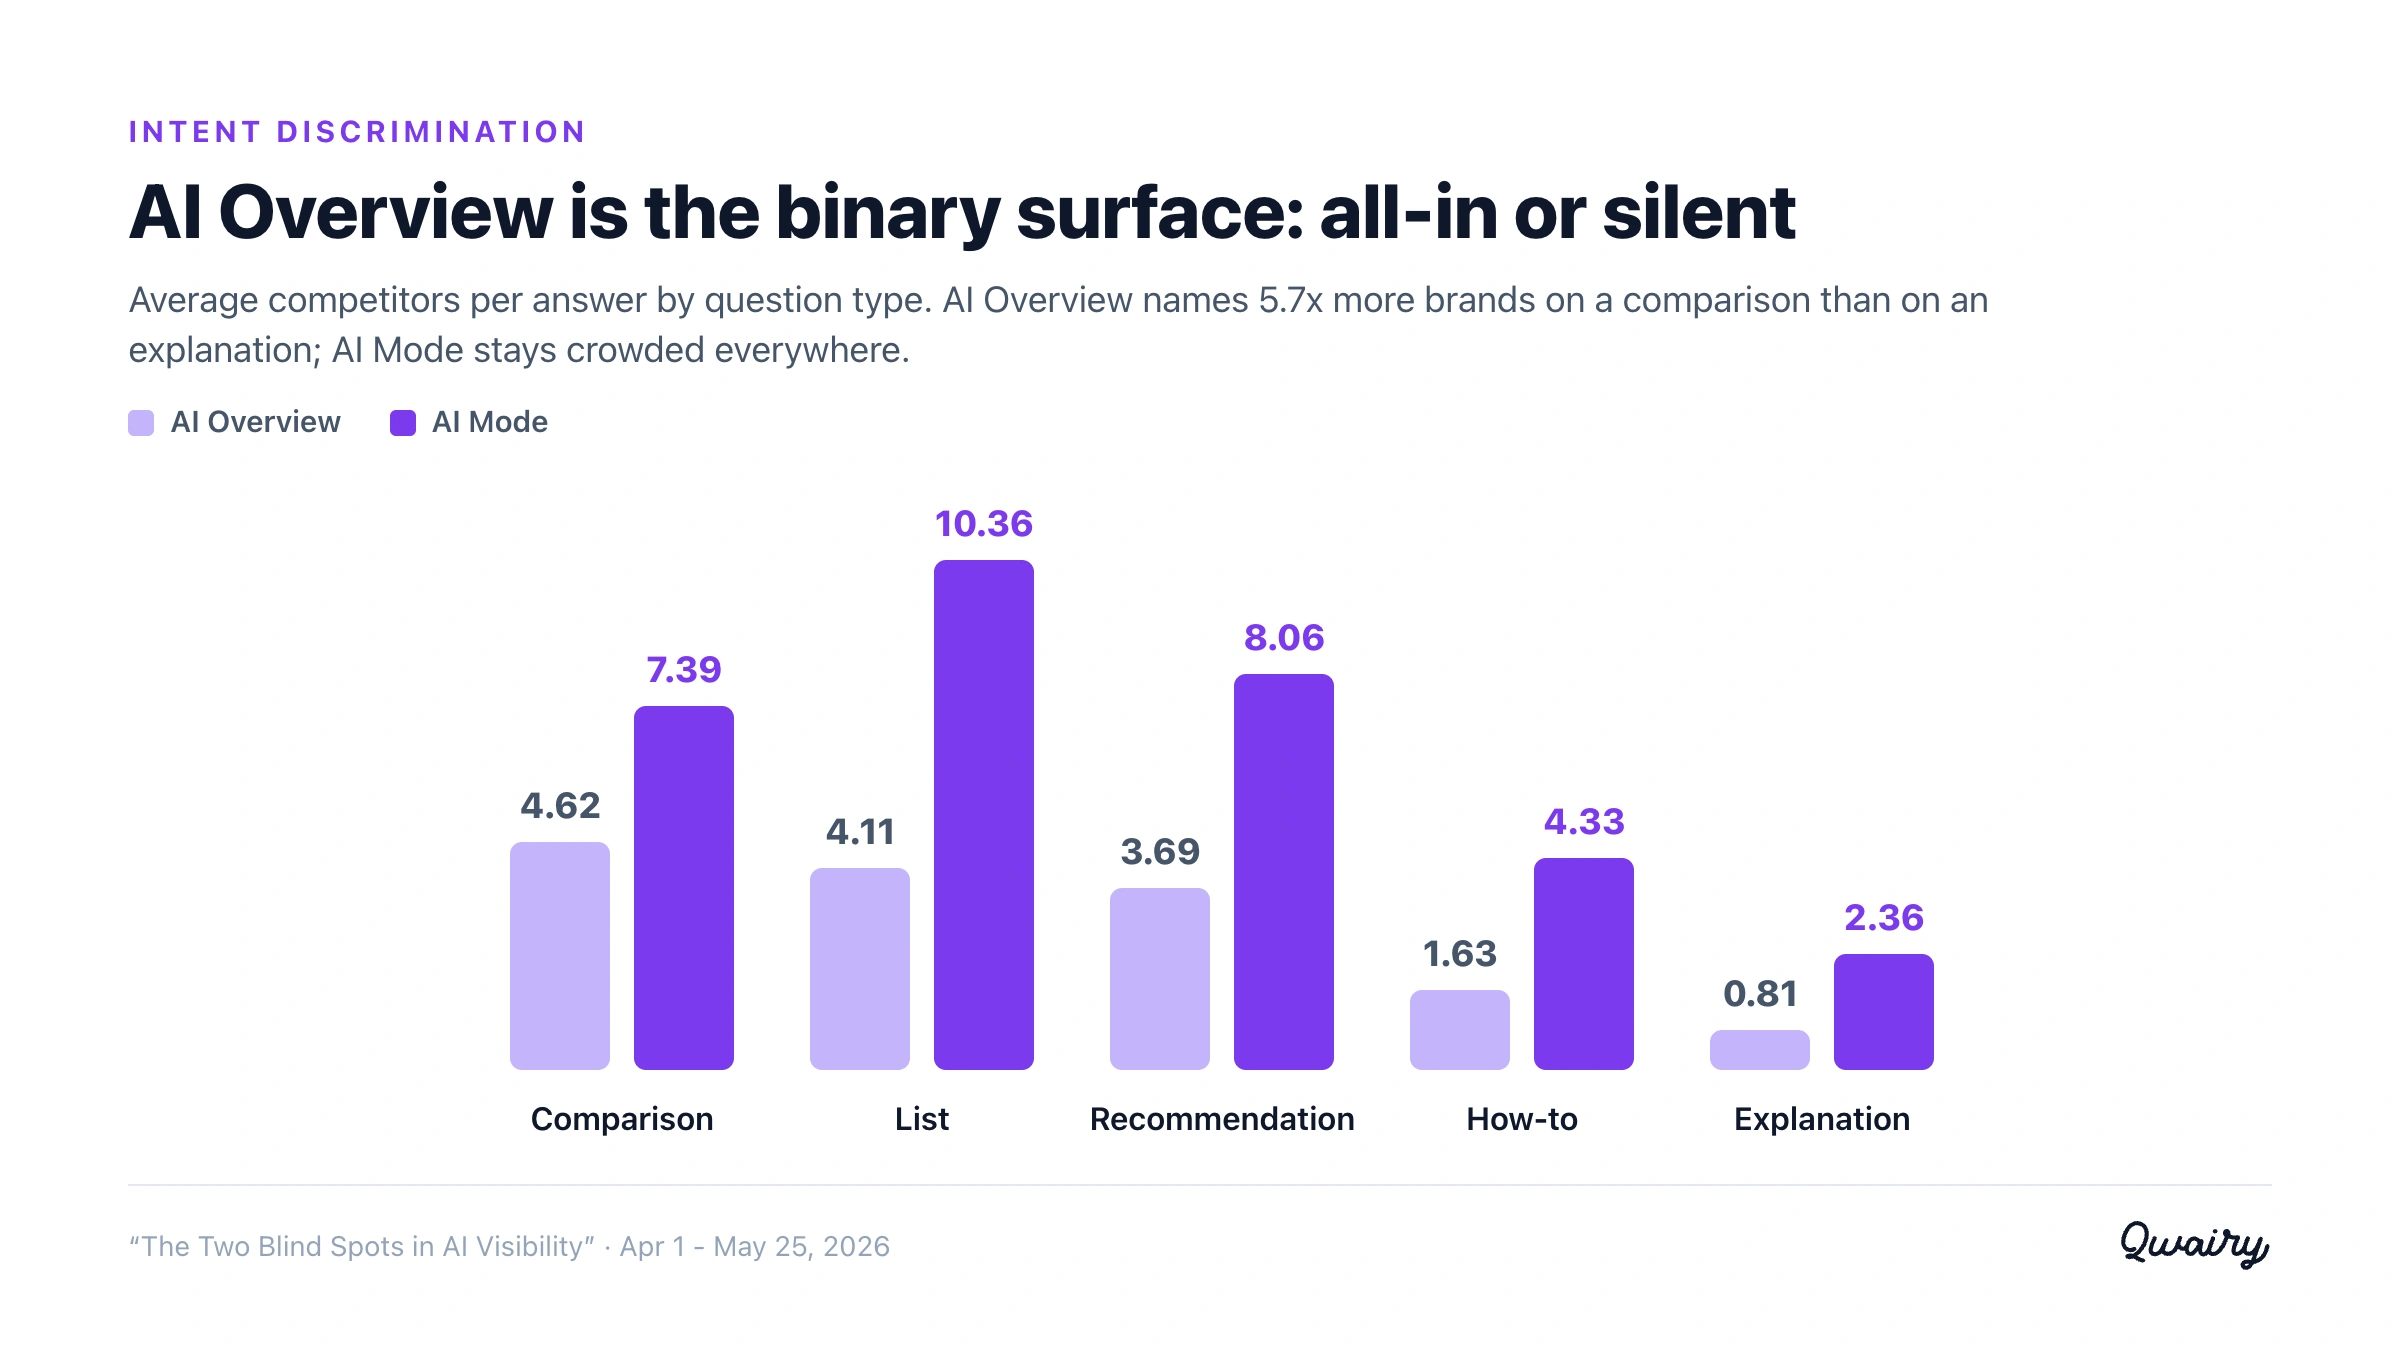
Type de question | Concurrents moyens, AI Overview | Concurrents moyens, AI Mode |
Comparaison | 4,62 | 7,39 |
Liste (« meilleur X ») | 4,11 | 10,36 |
Recommandation | 3,69 | 8,06 |
Guide pratique | 1,63 | 4,33 |
Explication | 0,81 | 2,36 |
Sur AI Overview, une requête de comparaison fait apparaître 5,7 fois plus de concurrents qu’une requête explicative (4,62 contre 0,81), et sur les questions explicatives elle mentionne un concurrent moins d’une fois sur deux. Sur l’intention informationnelle, AI Overview est en pratique absent du positionnement concurrentiel.
AI Mode ne descend jamais sous 2,36 concurrents par réponse, même sur les explications. Sur AI Overview, votre terrain de bataille concurrentiel se limite presque entièrement aux requêtes à intention commerciale ; sur AI Mode, vous êtes dans une pièce bondée sur presque toutes les requêtes.
Ne vous fiez jamais à une vérification isolée. La visibilité est un taux, pas un oui ou un non. La même surface change son verdict sur ~1 question sur 4 et est incohérente ~2 fois sur 3 quand votre marque est en jeu. Mesurez sur de nombreuses exécutions et dans la durée, sinon vous lisez du bruit.
Suivez Google comme deux surfaces, et suivez plus d’un moteur. Une marque peut gagner sur AI Mode et perdre sur AI Overview, ou l’inverse, et aucun moteur n’est le substitut d’un autre. Les fusionner, ou ne surveiller que ChatGPT, masque de vrais mouvements.
Pour AI Overview, gagnez l’intention commerciale. C’est l’extrait que voient 2,5 milliards de personnes, et votre présence concurrentielle s’y concentre sur les comparaisons, les listes « meilleur X » et les recommandations. Les contenus informationnels y ont peu de poids concurrentiel.
Pour AI Mode, attendez-vous à une pièce bondée partout. Avec deux fois plus de concurrents par réponse et des réponses de 470 mots, la simple mention est facile ; la position et la différenciation sont ce qui compte.
Réalité : une exécution n’est qu’un tirage. La même surface est incohérente d’une exécution à l’autre ~2 fois sur 3 quand la marque est en jeu. Mesurez le taux sur de nombreuses exécutions avant de conclure quoi que ce soit.
Réalité : AI Overview et AI Mode divergent sur la longueur (~4 fois), la densité de concurrents (~2 fois) et les sources (~1,7 fois). Une seule méthode ne peut pas servir les deux.
Réalité : AI Overview nomme 5,7 fois plus de concurrents sur l’intention commerciale que sur l’intention explicative, et mentionne à peine des concurrents sur les explications. Pour la visibilité concurrentielle, le levier est le contenu à intention commerciale.
Réalité : AI Mode mentionne un concurrent dans 82 % des réponses et en nomme plus de 6 par réponse. La mention est le plancher, pas la victoire. La position et la différenciation décident des résultats.
Périmètre : les deux surfaces IA de Google (AI Overview, AI Mode) plus cinq autres assistants (ChatGPT, Perplexity, Gemini, Microsoft Copilot, Grok) comme témoin inter-surfaces, tous mesurés sur des marques clientes en production du 1er avril au 25 mai 2026 (marques d’audit et de test exclues). Chaque prompt est exécuté à répétition par surface, ce qui nous permet de mesurer la stabilité d’une exécution à l’autre.
Méthodologie : analyse quantitative de réponses IA terminées. Longueur de la réponse mesurée en caractères à partir du texte de la réponse (médianes rapportées). Mentions de concurrents et sources citées mesurées par réponse puis agrégées par surface. Stabilité d’une exécution à l’autre mesurée sur les prompts ayant au moins deux exécutions par surface sur la fenêtre : un « changement de verdict » signifie que la marque est nommée lors de certaines exécutions et pas d’autres. La répartition par intention utilise la classification par type de réponse (comparaison, liste, recommandation, guide pratique, explication). Aucun indicateur de taux d’apparition n’est calculé (voir les limites).
Le non-déterminisme est mesuré, pas éliminé. Nous quantifions l’instabilité d’une exécution à l’autre (une surface change son verdict sur la marque sur ~1 question sur 4 ; ~2 sur 3 conditionnellement à une mention au moins une fois). Une part relève d’une véritable stochasticité du modèle et une autre d’une variance de récupération dans le temps ; nous ne les séparons pas. La conclusion (les vérifications isolées sont peu fiables, les taux le sont) vaut dans les deux cas.
Pas de taux d’apparition. Ce jeu de données n’est pas conçu pour mesurer la fréquence d’apparition d’un AI Overview sur une recherche Google. Tous les chiffres ici sont conditionnels à l’existence d’une réponse.
Le désaccord par requête entre surfaces n’est pas présenté comme structurel. Il est dominé par le même bruit d’une exécution à l’autre que celui décrit plus haut. Nous comparons plutôt des taux agrégés, où le bruit s’annule.
Population de marques suivies. Il s’agit de marques activement suivies par leurs propriétaires, et non d’un échantillon neutre. Les comparaisons entre surfaces en tiennent compte, car toutes les surfaces voient les mêmes marques.
Instantané. Les deux surfaces de Google évoluent vite (les requêtes d’AI Mode doublent chaque trimestre selon Google). Il s’agit d’un instantané de 8 semaines ; une nouvelle mesure au troisième trimestre 2026 pourrait diverger.
Vous voulez suivre votre marque sur les deux surfaces IA de Google, avec un échantillonnage répété plutôt que des vérifications ponctuelles ? Qwairy surveille les mentions de marque, la position et les citations sur AI Overview, AI Mode, ChatGPT, Perplexity, Claude, Gemini et des fournisseurs en nombre croissant, avec des analyses par surface.
Suivez les questions qui comptent pour votre activité, voyez quelles marques chaque réponse mentionne et quelles sources elle cite, puis travaillez sur les manques.
Offre gratuite avec 120 crédits initiaux • Sans carte bancaire
Autres articles
AI Overviews en France : ce que Google cite vraiment, face aux États-Unis
Qwairy et Converteo ont analysé 12 120 réponses AI Overviews en France et aux États-Unis : requêtes déclenchantes, sources citées, autorité et volatilité.
Questions de suivi IA : la première réponse n’est pas la décision
72 % des réponses IA invitent à poser une autre question, et la présélection se rebat quand l’acheteur répond. Le benchmark Qwairy montre ce que décide ce tour.