Loading page

Étude de 150 prompts français sans marque sur 9 intentions : l’éditorial de marque capte 76 % des citations IA. Ce que les équipes GEO doivent en faire.
Ce que nous avons observé au T2 2026 sur 150 prompts français traités par ChatGPT (Core) et Perplexity : Les résultats et recommandations de cette étude décrivent cet échantillon et cette période. La répartition des sources peut évoluer selon le moteur, l’intention et la date.
Filtre méthodologique appliqué dans toute l’étude. Les réponses qui ne contiennent aucune citation sont exclues de l’analyse. La décision binaire « citer ou ne pas citer » est une dimension légitime mais distincte, qui mélangerait deux signaux dans une seule métrique. L’étude porte exclusivement sur le profil de sourcing observé lorsque l’assistant décide de citer. Sur 600 réponses générées, 430 sont retenues.
Ce que cette étude exclut volontairement. Gemini, Claude, Mistral et DeepSeek sont hors périmètre pour cette itération, car l’instrumentation de notre pipeline d’extraction interne stable est incomplète sur ces fournisseurs. La partie 9 aborde ce que leur ajout changerait et présente le plan du T3 2026.
Le résultat le plus reproductible de cette étude est aussi celui qui risque le plus de remodeler la stratégie GEO française en 2026 : sur chaque type d’intention mesuré, la plus grande famille de sources, et de loin, est le contenu publié par les acteurs économiques eux-mêmes.
Nous avons regroupé 1 819 domaines cités distincts en neuf familles génériques (taxonomie détaillée en partie 2). Une seule famille, les éditeurs de contenu éditorial de marque et SEO, qui comprend les cabinets de conseil, les plateformes SaaS, les blogs éditoriaux d’entreprise, les médias de marque et tout autre éditeur dont l’activité de fond consiste à vendre un produit ou un service, capte 76 % des citations en moyenne, avec une part par intention comprise entre 59 % (Tutoriel) et 89 % (Local).
Trois observations s’en dégagent.
Ce n’est pas un effet de concentration, c’est un effet de longue traîne. L’IA ne s’appuie pas sur un noyau dur de quelques dizaines d’éditeurs faisant autorité. Elle puise dans un large éventail de contenus éditoriaux d’entreprise, dont la majorité n’apparaît qu’une ou deux fois dans l’ensemble des données. Cela renverse le playbook SEO de la dernière décennie : ce n’est pas une poignée de pages « hub » qui capte l’essentiel du signal, c’est une production éditoriale large, déclinée par intention et par sujet.
Les signaux d’autorité classiques s’effacent discrètement. En SEO traditionnel, Wikipédia, la presse établie et les sites institutionnels portaient l’essentiel du signal d’autorité. Dans nos mesures, Wikipédia ne représente que 0,2 % à 2,7 % des citations selon l’intention. Les médias de presse (économique, tech, généraliste) plafonnent entre 1 % et 2 % sur chaque type d’intention. Les références encyclopédiques et journalistiques qui ont structuré quinze ans de discours SEO sont devenues marginales dans les réponses IA en français.
La marque est devenue sa propre source d’autorité principale. Ce n’est pas une métaphore. Quand l’IA répond en français, trois citations sur quatre proviennent d’éditeurs dont l’activité de fond est le sujet traité. La stratégie de contenu d’une marque n’est plus un canal d’acquisition parmi d’autres, c’est son canal de représentation dans la couche IA. Le silence éditorial n’est plus une opportunité manquée, c’est une invisibilité structurelle. C’est le résultat principal. La suite de l’étude détaille comment le mix de sources évolue selon l’intention (parties 3-4), comment un simple changement de cadrage de la question remodèle tout (partie 5), comment les deux assistants divergent dans leur personnalité de recherche (partie 6) et ce que les équipes GEO doivent concrètement faire (partie 7).
Pour évaluer le profil de sourcing, c’est-à-dire ce que l’IA mobilise lorsqu’elle mobilise quelque chose, nous excluons toutes les réponses qui ne contiennent aucune citation. La décision binaire « recherche ou pas de recherche » est informative mais distincte, et l’intégrer à la métrique de part par famille mélangerait deux phénomènes. Après filtrage, l’analyse porte sur 430 réponses : les 300 réponses de Perplexity (Perplexity cite dans 100 % des cas par conception) et 130 réponses de ChatGPT sur 300.
Nous avons classé chaque domaine cité dans l’une des neuf familles génériques. La taxonomie est opportuniste, non théorique, et la catégorie de l’éditorial de marque est volontairement large.
.gouv.fr, régulateurs (CNIL, ARCEP, ACPR, AMF), ordres professionnels (Notaires de France, Ordre des experts-comptables), institutions européennes, agences publiques (Bpifrance, France Num)Cette catégorie fourre-tout, la neuvième, est en soi une observation. Il n’existe aucune classification universellement admise des « types de sources IA » en français ; chaque équipe GEO peut construire une taxonomie adaptée à ses besoins.
Elles sont détaillées en partie 9. Les principales : grille de 9 intentions (non exhaustive), 15-30 prompts par cellule (marge d’erreur d’environ ±10 points), périmètre de 2 fournisseurs, 4 exécutions cumulées (instantané), français uniquement, classification manuelle des domaines (subjective) et période d’instantané (les versions de modèles évoluent).
La matrice ci-dessous se lit par ligne : sur 100 citations émises pour les prompts d’une intention donnée, X % appartiennent à une famille donnée. Les deux fournisseurs sont agrégés.
Intention | Marque/SEO | Officiel | Agrég. | Forums | Vidéo | Wikipédia |
Définition / pédagogie | 77 | 11 | 4 | 1 | 3 | 2 |
Tutoriel / how-to | 59 | 28 | 2 | 2 | 5 | 1 |
Recommandation ouverte | 76 | 0 | 14 | 7 | 2 | 0 |
Comparaison et alternatives | 86 | 1 | 6 | 3 | 2 | 0 |
Fiabilité / réputation | 77 | 6 | 6 | 3 | 4 | 0 |
Problèmes et dépannage | 74 | 14 | 4 | 2 | 3 | 0 |
Prix et conditions commerciales | 85 | 3 | 9 | 3 | 0 | 0 |
Juridique / conformité | 77 | 20 | 0 | 3 | 0 | 0 |
Local / proximité | 89 | 3 | 3 | 2 | 1 | 0 |
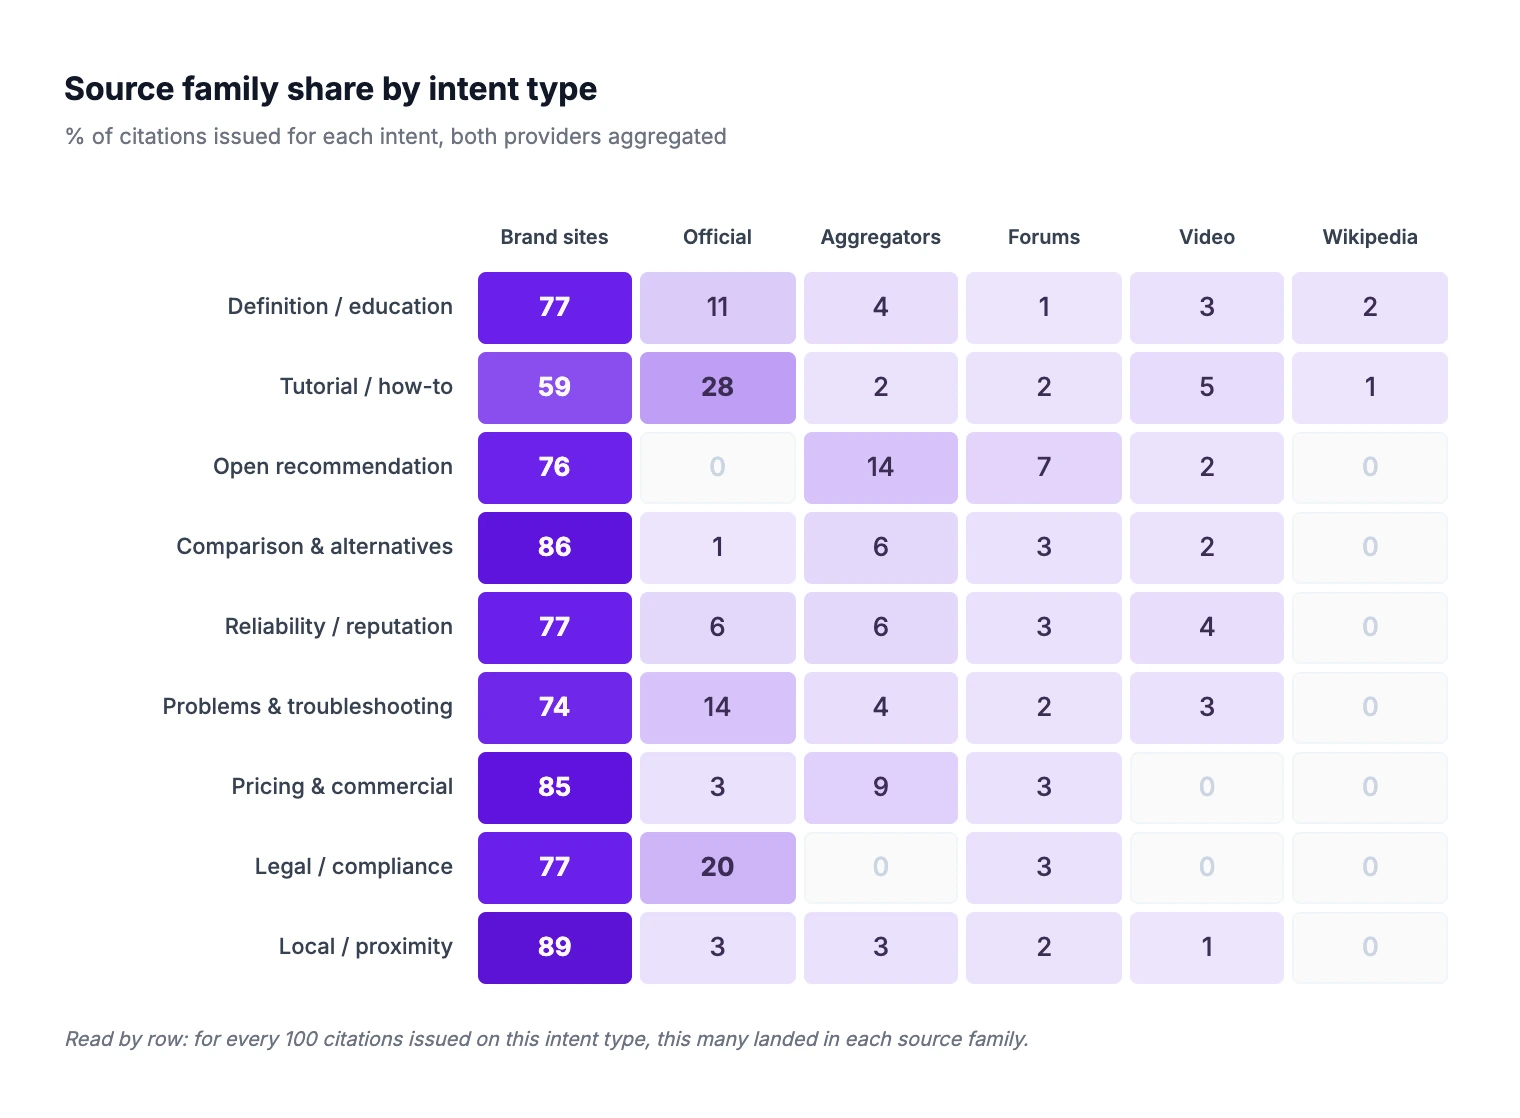
Trois constats se dégagent.
Les questions à cadre normatif font appel aux sources officielles. Le Tutoriel (28 %) et le Juridique (20 %) tirent de quatre à cinq fois plus de citations des sites .gouv.fr et institutionnels que la moyenne de l’étude. Quand un utilisateur demande « comment créer une SASU » ou « quelles sont les obligations RGPD d’un site e-commerce », l’IA s’appuie massivement sur les portails Service Public et CNIL. Pour les marques des secteurs réglementés, être référencée par un acteur institutionnel n’est plus un plus éditorial, c’est devenu une condition de présence dans la réponse de l’IA.
Les agrégateurs et les forums émergent sur la recommandation commerciale, et seulement là. La recommandation ouverte est la seule intention où les agrégateurs (14 %) et les forums (7 %) dépassent ensemble 20 % des citations. Sur tous les autres types d’intention, ces deux familles restent à un chiffre ou absentes. Le format « top X » et le format forum communautaire gardent une utilité GEO précise et bien délimitée, exactement sur les requêtes où les utilisateurs choisissent entre plusieurs options. Les sites commerciaux représentaient une forte part des citations dans cet échantillon. Cette catégorie ne se limite pas au site de la marque étudiée : examinez votre contenu et les sites tiers pertinents. Les données ne démontrent pas qu’un corpus éditorial propre serait le seul moyen d’être cité.
Lancez un audit gratuit : en quelques minutes, ChatGPT, Gemini et Perplexity répondent en direct à 8 questions d’achat sur votre marché, et vous voyez qui ils recommandent.
Pour ancrer la matrice dans des comportements concrets, voici trois prompts de notre jeu de données, posés à chacun des deux assistants, avec le profil de citations réellement produit par chaque IA. Les sources sont décrites par famille et par catégorie pour préserver l’anonymat des éditeurs commerciaux.
C’est un prompt de tutoriel administratif typique. Les deux assistants le sourcent massivement, et tous deux se tournent d’abord vers les portails officiels.
impots.gouv.fr (12 citations sur ce seul prompt), arcep.fr (8) et de la page de résultats Google (6). Un sourcing fortement institutionnel, avec presque aucun contenu de marque dans les premières positions.youtube.com (12 citations) en tête, suivi de service-public.gouv.fr (7), bpifrance-creation.fr (6) et d’une longue traîne d’éditeurs de contenu éditorial dans les services juridiques.À retenir. Sur une question qui appelle une réponse institutionnelle forte, ChatGPT concentre ses citations sur quelques portails .gouv.fr. Perplexity se diversifie vers la vidéo et vers des éditeurs de contenu d’entreprise du secteur des services juridiques. Même prompt, deux expériences de sourcing très différentes.
Un prompt de recommandation commerciale sans aucune marque mentionnée. Le mix change radicalement.
reddit.com en première source (14 citations sur ce seul prompt), suivi d’un comparateur bancaire et d’une plateforme de comptabilité B2B. Reddit domine le profil de citations, avec près de la moitié de toutes les sources citées sur ce prompt.youtube.com.À retenir. Pour ce prompt de recommandation, ChatGPT a fait de Reddit une source principale, tandis que Perplexity a cité d’autres sources. Cet exemple illustre un écart observé au T2 2026, sans établir qu’une présence sur Reddit garantit une exposition dans ChatGPT.
Même intention de Fiabilité qu’une question neutre, mais reformulée sur un registre critique.
reddit.com (part élevée), un éditeur de contenu de finance grand public et quelques blogs indépendants de finances personnelles.À retenir. Aucune source officielle n’apparaît dans les citations de l’un ou l’autre fournisseur sur ce prompt. La même intention en cadrage neutre aurait fait remonter amf-france.org et les portails du superviseur financier ; le cadrage critique les a effacés. La partie 5 quantifie cet effet sur l’ensemble du sous-lot à cadrage négatif.
Sur les 15 prompts de Fiabilité reformulés sur un registre critique, le mix de familles se réorganise de façon spectaculaire :
Famille | Cadrage neutre | Cadrage négatif | Évolution |
Officiel et institutionnel | 11,1 % | 0,6 % | divisé par ~18 |
Agrégateurs et annuaires | 3,2 % | 8,6 % | × 2,7 |
Forums et communautés | 1,6 % | 3,6 % | × 2,3 |
Vidéo et réseaux sociaux | 2,6 % | 4,7 % | × 1,8 |
Éditorial de marque et SEO | 76,6 % | 79,1 % | stable |
Avis et organisations de consommateurs | 1,8 % | 0,6 % | divisé par 3 |
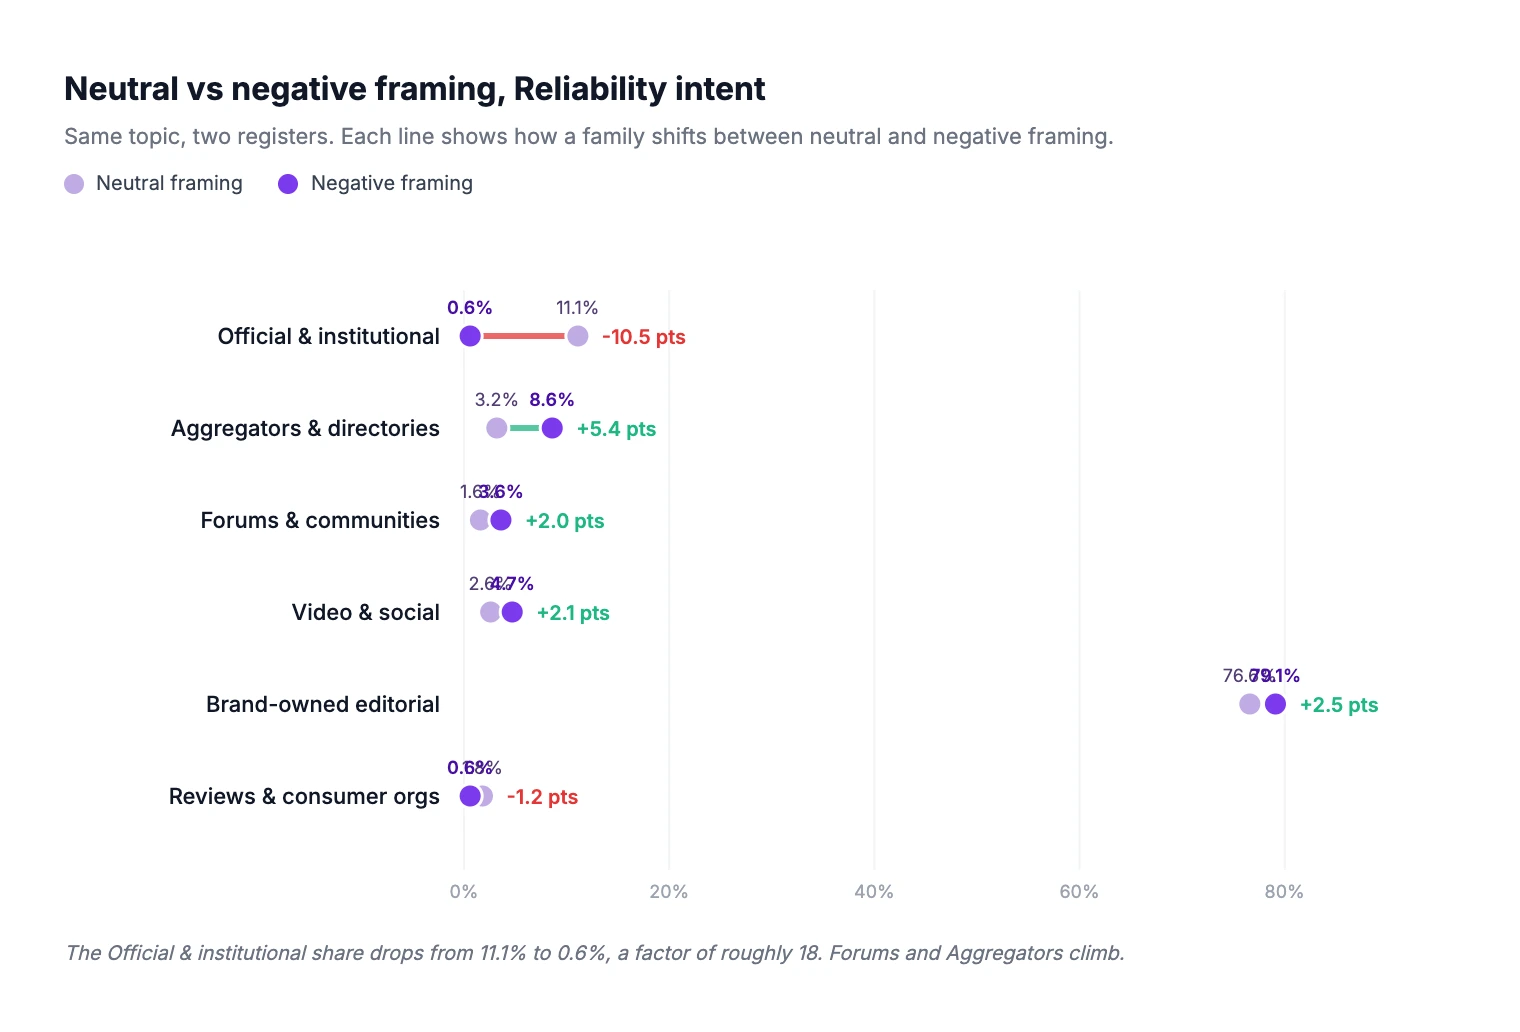
L’effet le plus frappant concerne les sources officielles : elles s’effondrent. À intention constante, reformuler la question sur un registre critique fait chuter la part institutionnelle d’un facteur d’environ 18. Le modèle, semble-t-il, n’associe pas les sources faisant autorité à un registre de désapprobation. Il pivote vers les sources où la critique a une légitimité native : agrégateurs, forums, vidéo. Un effet plus inattendu : la part des plateformes d’avis et des associations de consommateurs recule aussi sous cadrage négatif. C’est contraire à l’intuition selon laquelle les questions critiques amplifieraient ces sources. L’explication probable est que les plateformes d’avis produisent un contenu structurellement moins critique que leur réputation ne le laisse penser : l’essentiel de ce qu’elles publient reste neutre ou modéré éditorialement.
L’implication tactique est qu’il existe deux paysages de sources distincts pour un même thème. Un paysage « positif/neutre » et un paysage « négatif/critique ». Une marque qui cherche à maîtriser ce qui se dit d’elle dans les réponses IA doit travailler les deux registres. Une stratégie GEO qui ne traite que le cadrage positif cède 100 % de la conversation critique à d’autres acteurs. Ce point est rarement abordé dans les playbooks GEO existants, et pour les marques dont la réputation est en jeu, c’est un risque structurel. Le cadrage négatif n’a été testé que sur une seule intention (Fiabilité) et un seul axe (positif contre négatif). Extrapoler l’ampleur du ×18 aux autres types d’intention serait prématuré. Mais la direction de l’effet (les sources officielles reculent dans les registres critiques) est cohérente sur chaque prompt du sous-lot.
À périmètre comparable (réponses sourcées uniquement), les deux assistants citent un nombre de domaines par réponse similaire : environ 8 citations en moyenne pour ChatGPT et 10 citations pour Perplexity. Le volume d’information cité est du même ordre de grandeur. C’est sur la composition de cette information que les deux assistants divergent nettement :
Famille | ChatGPT (Core) | Perplexity |
Éditorial de marque et SEO | 68,5 % | 81,3 % |
Officiel et institutionnel | 15,5 % | 6,6 % |
Forums et communautés | 9,0 % | 0,8 % |
Agrégateurs et annuaires | 3,3 % | 6,3 % |
Vidéo et réseaux sociaux | 0,5 % | 2,9 % |
Médias et presse | 0,4 % | 1,0 % |
Avis et organisations de consommateurs | 0,7 % | 0,6 % |
Wikipédia | 0,2 % | 0,2 % |
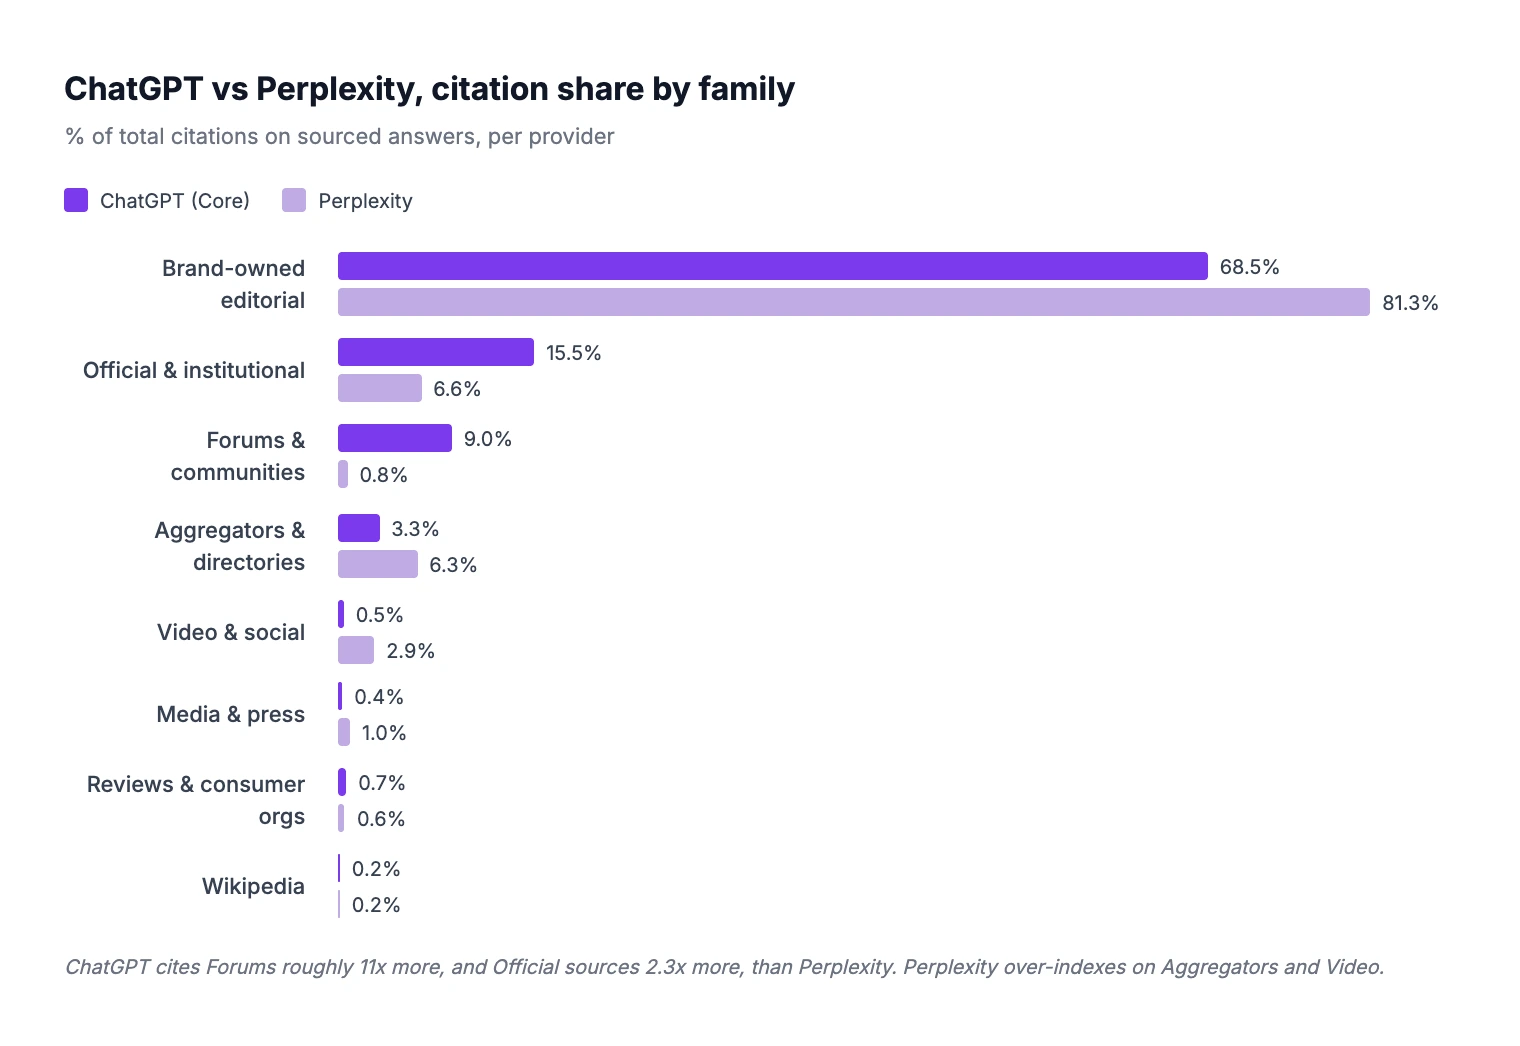
Trois écarts ressortent :
.gouv.fr et aux régulateurs lorsqu’il source.Ces écarts suggèrent que les deux assistants appliquent des stratégies de recherche qualitativement différentes, avec des pondérations différentes selon les familles de sources. Nous ne pouvons pas confirmer le mécanisme sous-jacent depuis l’extérieur des systèmes : il peut s’agir d’un index de recherche web différent, d’heuristiques de reranking différentes ou de filtres de politique différents lors de la synthèse. Ce que nous pouvons confirmer, c’est que ces écarts sont cohérents sur chaque type d’intention testé. La conséquence stratégique est que améliorer votre visibilité sur Perplexity et l’améliorer sur ChatGPT sont deux projets distincts, avec des ensembles d’actifs qui se recoupent sans être identiques. N’optimiser que pour l’un des deux laisse l’autre insuffisamment couvert.
Voyez les recherches web capturées derrière les réponses des modèles compatibles, et les manques de contenu qu’elles révèlent.
La matrice de la partie 3 est le livrable exploitable de cette étude. Nous la traduisons ci-dessous en recommandations par intention. La logique est constante : identifier la famille de sources dominante pour les intentions qui comptent pour votre marque, puis investir de façon disproportionnée dans la production de contenu de cette famille, ou dans le fait d’y être référencé.
X vs Y et ****alternatives à X. L’IA cite presque exclusivement l’éditorial de marque pour cette intention. Votre propre corpus est le levier le plus direct..gouv.fr et ceux des régulateurs. Les citer dans vos propres contenus, y faire des liens, co-rédiger quand c’est possible.La réalité : dans les réponses IA en français, Wikipédia plafonne à 2,7 % sur son meilleur type d’intention, et la grande presse à 2 %. Le signal d’autorité s’est déplacé vers les éditeurs de contenu éditorial de marque. Le silence éditorial est désormais un risque structurel de visibilité.
La réalité : dans notre échantillon du T2 2026, ChatGPT et Perplexity citaient des familles de sources dans des proportions différentes. Une marque visible sur l’un n’est pas automatiquement visible sur l’autre ; il faut examiner les résultats récents propres à chaque moteur.
La réalité : dans notre matrice du T2 2026, sur les prompts de recommandation ouverte, les forums représentent 7 % des citations, derrière l’éditorial de marque et les agrégateurs à 14 %. Leur intérêt doit être réévalué selon le moteur et la période.
La réalité : le paysage de sources de « pourquoi X est-il critiqué » est structurellement différent de celui de « qu’est-ce que X ». Les sources institutionnelles s’effondrent ; les forums et les agrégateurs progressent. Votre investissement dans le contenu positif ne se transpose pas au paysage du cadrage négatif.
La réalité : le mix de familles varie de plus de 80 points selon l’intention. Un prompt juridique tire 20 % de sources institutionnelles et 0 % d’agrégateurs ; un prompt de recommandation tire 0 % de sources institutionnelles et 14 % d’agrégateurs. La stratégie GEO exige une segmentation par intention, et non un playbook global unique.
Taille d’échantillon. Avec 15-30 prompts par intention et 4 exécutions cumulées, la marge statistique sur chaque cellule de la matrice se situe autour de ±10 points. Les ordres de grandeur tiennent. Les comparaisons fines de 1 à 2 points au sein d’une cellule ne tiennent pas.
Instantané temporel. Les deux assistants déploient régulièrement des mises à jour de modèles, et les pipelines de recherche évoluent. Une mesure répétée à T+3 mois peut diverger sensiblement. Le format cyclique est conçu pour cela : le T3 2026 produira un instantané comparable.
Périmètre des fournisseurs. Deux fournisseurs seulement. Gemini, Claude, Mistral et DeepSeek sont hors périmètre pour cette itération, en raison d’une instrumentation incomplète dans notre pipeline interne stable. Nous prévoyons d’intégrer Gemini et Claude au T3.
Périmètre linguistique. Français uniquement. On sait que la part de Reddit, de Wikipédia et des médias de presse diffère nettement sur les marchés anglophones. Reddit, en particulier, pèse beaucoup plus lourd dans les réponses IA en anglais.
Taxonomie des sources. Neuf familles, c’est pratique et opportuniste. La seule catégorie de l’éditorial de marque mélange des éditeurs SaaS, des cabinets de services professionnels, des blogs d’entreprise et des médias de marque (des objets dont les implications GEO sont très différentes). Décomposer cette catégorie en sous-familles est l’amélioration la plus urgente pour la v2, en partie motivée par des retours de clients.
Axe du cadrage. Testé sur une seule intention (Fiabilité). L’ampleur du ×18 sur les sources officielles ne doit pas être extrapolée à d’autres intentions sans test dédié.
Avec marque contre sans marque. Nous avons travaillé exclusivement en mode sans marque. L’effet de l’introduction d’un nom de marque dans le prompt (avec marque contre sans marque, à intention constante) est une question GEO connue que nous n’avons pas traitée dans cette itération.
Si le T3 2025 posait la question « sur quelle plateforme IA dois-je optimiser ? » et le T1 2026 celle de « quel playbook de fan-out convient à mon marché ? », le T2 2026 demande : « quelles familles de sources dominent les requêtes qui comptent pour moi, et y suis-je présent ? » Les trois idées à retenir :
L’itération du T3 2026 affinera la catégorie de l’éditorial de marque, ajoutera Gemini et Claude et testera l’axe avec marque contre sans marque. Nous nous attendons à ce qu’au moins l’un de ces raffinements mette sensiblement à jour le playbook.
Réalisée par : Nicolas Ilhé (Qwairy)
Jeu de données : 150 prompts français sans marque, répartis sur 9 typologies d’intention, exécutés deux fois chacun sur ChatGPT (Core) et Perplexity au T2 2026. 600 réponses générées, 430 retenues après le filtre des réponses sans citation, 4 171 citations sur 1 819 domaines uniques. Le suivi de marque a été mené dans un workspace de recherche dédié sur la plateforme Qwairy ; aucune donnée client n’a été utilisée dans cette étude.
Méthodologie : analyse qualitative de la composition des familles de sources par type d’intention et par fournisseur. Domaines classés manuellement en neuf familles génériques. Pourcentages par cellule calculés sur le total des citations de la tranche concernée. Comparaison du cadrage négatif réalisée sur un sous-lot de 15 prompts à intention constante (Fiabilité). Marges d’erreur statistiques d’environ ±10 points par cellule pour n = 15-30 prompts.
Vous souhaitez suivre les citations de votre marque par intention ? Qwairy surveille les citations de marque sur ChatGPT, Perplexity, Claude, Gemini et d’autres fournisseurs en expansion, avec une classification par source et des analyses par intention.
Suivez les questions qui comptent pour votre activité, voyez quelles marques chaque réponse mentionne et quelles sources elle cite, puis travaillez sur les manques.
Offre gratuite avec 120 crédits initiaux • Sans carte bancaire
Autres articles
AI Overviews en France : ce que Google cite vraiment, face aux États-Unis
Qwairy et Converteo ont analysé 12 120 réponses AI Overviews en France et aux États-Unis : requêtes déclenchantes, sources citées, autorité et volatilité.
Questions de suivi IA : la première réponse n’est pas la décision
72 % des réponses IA invitent à poser une autre question, et la présélection se rebat quand l’acheteur répond. Le benchmark Qwairy montre ce que décide ce tour.