Loading page

Guide complet et sourcé du GEO : comment les LLM lisent et choisissent les contenus, structure, densité sémantique, E-E-A-T, typologie de pages et fraîcheur.
Pendant vingt ans, être trouvé en ligne voulait dire une seule chose : se classer sur Google. En tant que SEO, nous avons optimisé nos balises title, construit des backlinks, analysé l’intention de recherche et prié les dieux de l’algorithme. Cette méthode compte toujours, mais elle ne suffit plus. Une part croissante des recherches se déroule désormais à l’intérieur des moteurs IA. ChatGPT, Perplexity, Google AI Overviews, Gemini. Ces systèmes ne classent pas les pages. Ils les lisent, en extraient ce qui est crédible et citent les sources qu’ils jugent utiles. Les signaux auxquels ils réagissent recoupent ceux du SEO, mais ne sont pas identiques. Et la tendance ne fait que s’accélérer : ChatGPT est passé d’environ 100 millions d’utilisateurs actifs par semaine en janvier 2024 à environ 780 millions en septembre 2025 (comme le mentionne cette étude ). Par ailleurs, une analyse à grande échelle de 815 000 couples requête-page menée par Kevin Indig montre que la stratégie du « guide ultime » (couvrir tous les sous-thèmes possibles) donne de moins bons résultats en citations qu’une page ciblée et plus courte. Les pages qui couvrent 26-50 % des sous-thèmes sont davantage citées que celles qui en couvrent 100 %. Après avoir lu plus de 100 études sur la façon dont les LLM classent les contenus et analysé plus d’un million de requêtes pour nos propres études, nous avons décidé de construire ce guide de référence sur la création de contenus cités par les LLM. Ce guide présente ce que disent réellement les données : comment les LLM consomment et sélectionnent les contenus, comment la structure et la densité sémantique favorisent l’extractibilité, en quoi les signaux E-E-A-T fonctionnent différemment dans un contexte génératif, et à quoi ressemble un workflow de contenu GEO réaliste en 2026.
Avant d’optimiser pour le GEO, il faut comprendre un point fondamental : les LLM ne consomment pas le contenu comme Google. Google explore votre page, l’indexe et la note selon des centaines de signaux de classement. Un LLM procède d’une manière structurellement différente. Quand un utilisateur pose une question, le modèle répond soit de mémoire (ses données d’entraînement), soit en récupérant du contenu en temps réel, en extrayant les passages les plus pertinents et en synthétisant une réponse. Ce sont deux voies totalement distinctes, qui appellent des stratégies d’optimisation différentes.
C’est ce que le modèle a appris pendant son entraînement. Si votre marque, votre contenu ou vos idées ont été fréquemment cités dans des sources à forte autorité avant la date limite d’entraînement du modèle, il y a de bonnes chances que celui-ci en ait encodé une représentation. En février 2026, selon une étude de Semrush, ChatGPT n’active sa recherche web que sur 34,5 % des requêtes , contre 46 % fin 2024. La plupart des réponses reposent donc encore sur les seules données d’entraînement. Pour la majorité des requêtes, aucune récupération n’a lieu : le modèle répond avec ce qu’il sait déjà. Cela a une implication sous-estimée : les mentions de marque dans les publications de référence, sur Wikipédia, dans les rapports sectoriels et sur les sites à fort trafic ne construisent pas seulement l’autorité SEO. Elles façonnent ce que les LLM « savent » de vous au niveau paramétrique. Les relations presse digitales et la présence hors site comptent pour le GEO bien au-delà des backlinks.
Voie 2 : la génération augmentée par récupération (RAG)
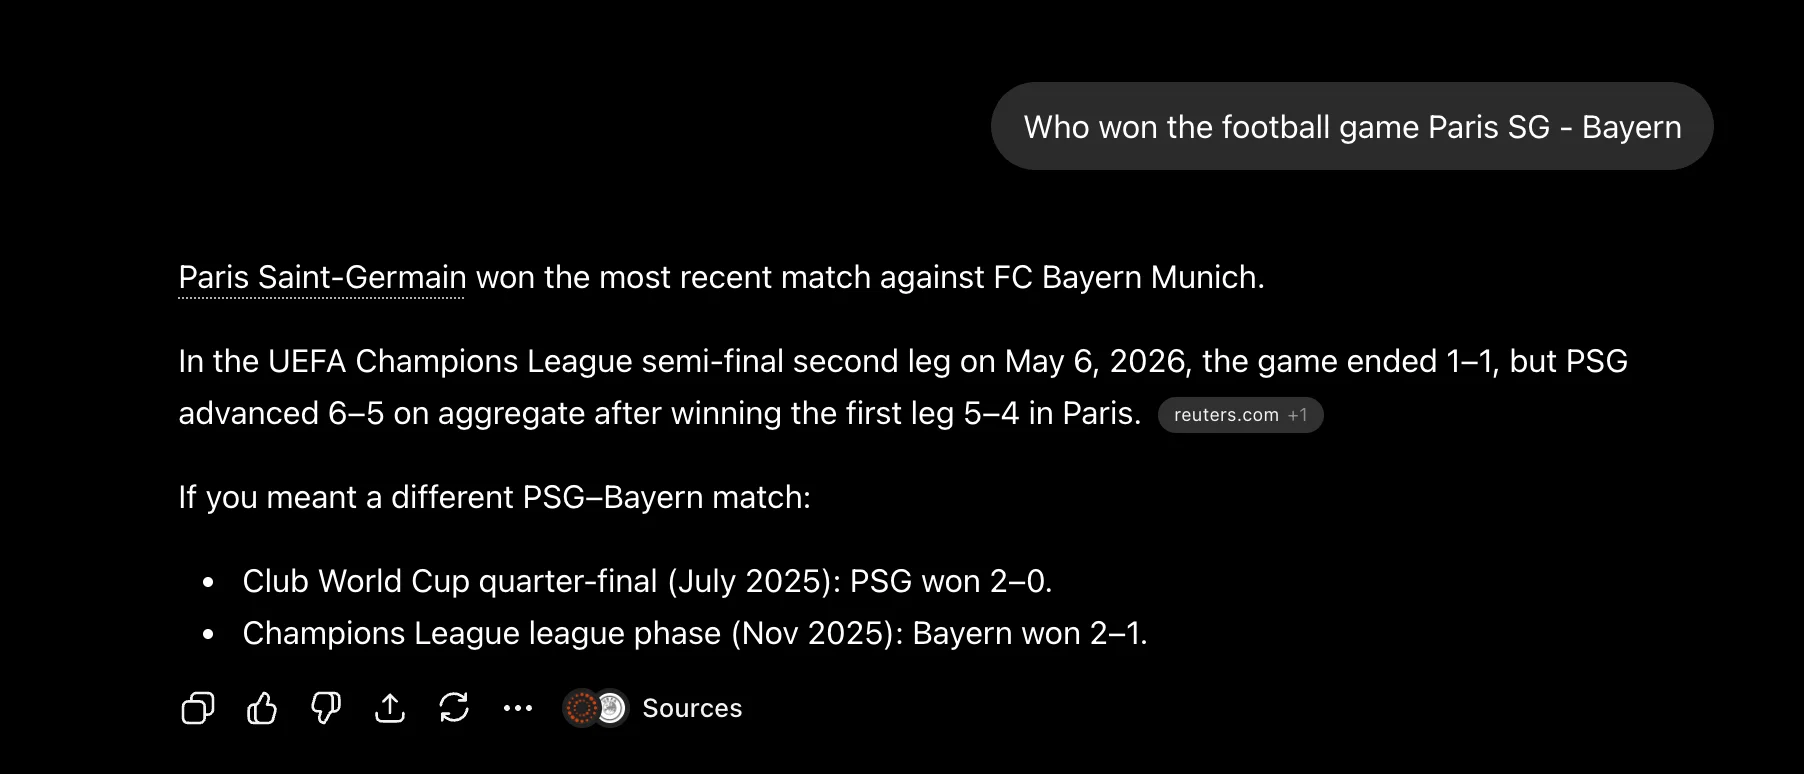
Quand une requête exige des informations récentes ou précises, le modèle déclenche une recherche web, récupère un ensemble d’URL, lit leur contenu et choisit ce qu’il inclut dans sa réponse. Mais il ne lance pas une seule recherche. Il décompose votre requête en plusieurs sous-requêtes, ce que l’on appelle le query fan-out, et les exécute simultanément avant de synthétiser une réponse.
Une analyse de 102 018 requêtes IA par Qwairy montre que le comportement de query fan-out varie nettement selon le fournisseur : Perplexity ne génère qu’une seule requête de recherche pour 70,5 % des prompts, contre 32,7 % seulement pour ChatGPT. ChatGPT décompose donc beaucoup plus souvent une même question en plusieurs sous-recherches parallèles.
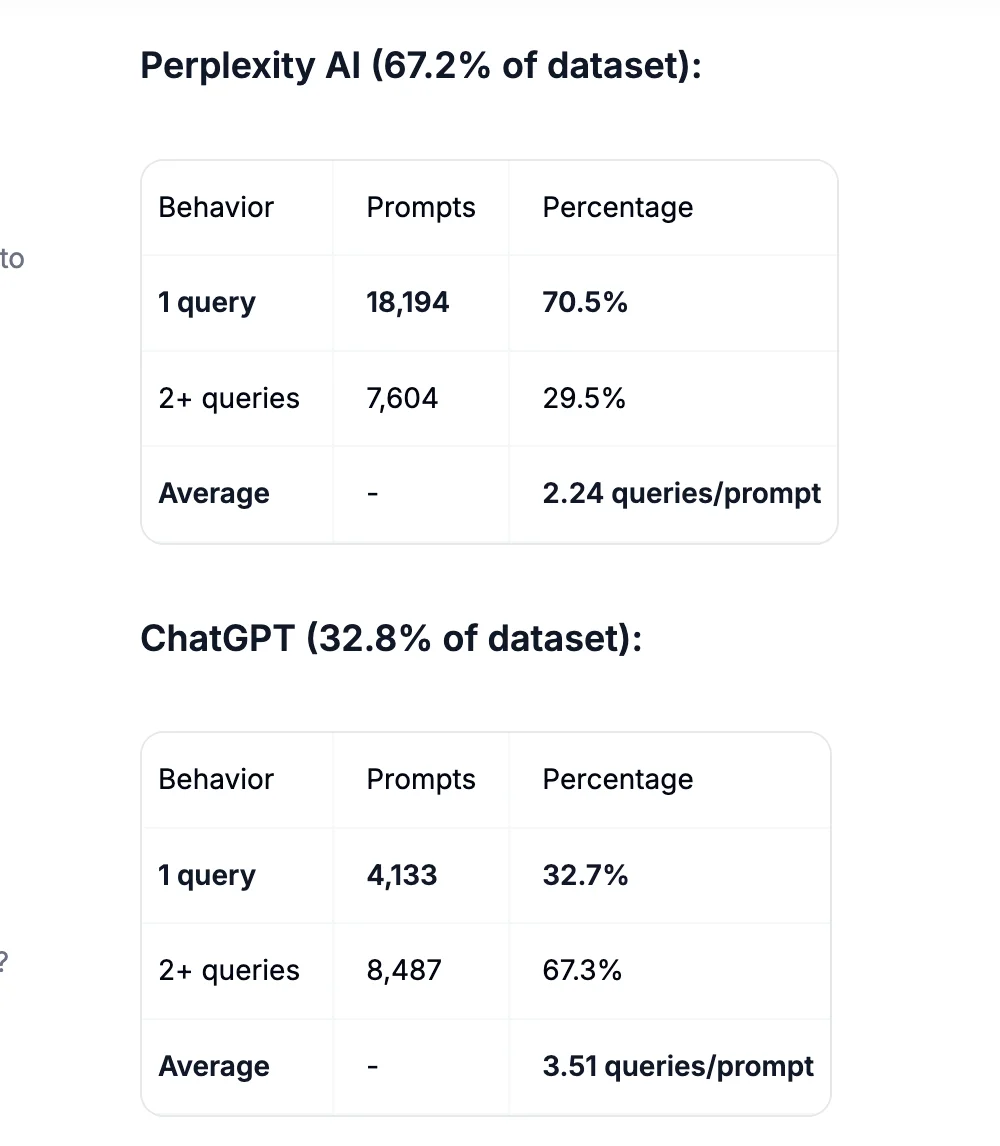
Conséquence pratique : une marque qui ne couvre que le cadrage superficiel d’un sujet peut apparaître dans Perplexity, mais rester invisible dans ChatGPT parce qu’il lui manque les variantes de sous-requêtes que ChatGPT récupère réellement. Les prompts qui contiennent des mots comme « top » ou « best » génèrent jusqu’à 14 fois plus de sous-requêtes que les questions factuelles simples. Les requêtes commerciales et concurrentielles sont donc précisément celles où une couverture thématique large compte le plus. C’est là que la structure de votre contenu devient décisive. Le modèle ne lit pas votre page comme un humain, de haut en bas et avec patience. Il en extrait des segments (chunks). Un contenu structuré de façon que chaque paragraphe puisse tenir seul comme unité citable, en répondant de manière complète à une requête potentielle, est nettement plus performant dans les pipelines de récupération. Un mur de prose aux renvois internes, qui oblige à lire trois sections pour comprendre un seul point, coûte cher à traiter. Un concurrent qui avance le même argument en deux phrases propres et autonomes sera cité à votre place.
Le principe du coût d’extraction C’est le modèle mental central du GEO. Chaque moteur IA, qu’il s’agisse de ChatGPT qui récupère via Bing (ou Google), de Perplexity qui explore son propre index ou de Google AI Mode qui puise dans son graphe de recherche, fait un calcul coûts-bénéfices au moment de choisir ce qu’il cite. Le bénéfice, c’est la qualité et la pertinence de votre contenu. Le coût, c’est l’effort de calcul nécessaire pour en extraire la valeur. Un HTML mal structuré, du contenu rendu en JavaScript, du code surchargé issu d’un copier-coller depuis Google Docs, des paragraphes denses et ininterrompus : tout cela augmente le coût d’extraction. Et contrairement à un lecteur humain, qui peut insister par intérêt, si vous ne structurez pas votre contenu comme les LLM le préfèrent, vous ne serez tout simplement pas cité, car un concurrent qui le fait sera toujours l’option la moins coûteuse. Voici à quoi ressemble, concrètement, la réduction de ce coût :
Utilisez correctement le HTML5 sémantique. Ne vous contentez pas de donner l’apparence d’un titre à du texte en le mettant en gras et en agrandissant la police. Utilisez de vraies balises <h1>, <h2>, <h3> dans une hiérarchie cohérente. Placez votre contenu principal dans une balise <main>, utilisez <article> pour le contenu éditorial, <header> et <footer> quand c’est pertinent. Ces balises n’aident pas seulement les humains à naviguer : elles indiquent au système de récupération quelle partie de la page prioriser. Une page dont le contenu principal est clairement étiqueté coûte moins cher à analyser qu’une page où tout vit dans des conteneurs <div> génériques.
Gardez une hiérarchie de titres lisible comme un plan autonome. Si quelqu’un ne lit que votre H1, vos H2 et vos H3 à la suite, il doit comprendre de quoi parle l’article et à quoi répond chaque section. Trois à cinq niveaux de titres constituent la plage pratique. Au-delà, vous ajoutez une structure qui n’aide pas la navigation : elle ajoute du bruit. Pensez à la table des matières d’un livre bien édité : claire, logique, explicite.
Évitez le contenu rendu en JavaScript pour tout ce que vous voulez voir cité. Quand le contenu d’une page est généré côté client par JavaScript, un système de récupération qui n’exécute pas le JS verra une page vide. Certains robots d’exploration s’en accommodent, mais c’est plus lent, plus coûteux et moins fiable. Si vous utilisez un framework JS moderne comme Next.js ou Nuxt, passez par le rendu côté serveur (SSR) pour que le HTML soit complet à l’arrivée du robot. Le contenu doit exister dans la réponse HTML brute, et non apparaître après l’exécution d’un script par le navigateur.
Nettoyez votre balisage avant de publier. L’effet est plus important qu’il n’y paraît. Nous avons réalisé un test de comptage de tokens sur un vrai article WordPress rédigé avec Gutenberg : le même contenu éditorial, comparé dans deux versions, la sortie Gutenberg brute et une version HTML sémantique nettoyée. Résultats :
Gutenberg (original) | HTML nettoyé | |
Caractères | 11 503 | 8 994 |
Tokens estimés | ~2 875 | ~2 248 |
Réduction | −21,8 % |
La différence vient entièrement du bruit du balisage, pas du contenu. Gutenberg a généré 94 commentaires de bloc (<!-- wp:paragraph -->, <!-- /wp:paragraph -->, etc.), 6 balises <strong> redondantes imbriquées dans des balises de titre et 4 classes de présentation sur des titres. Aucune valeur éditoriale. Du pur surcoût de traitement.
Ces 22 % de tokens que le LLM a dû traiter ne contenaient aucune information. Sur un article plus long, ou sur un site de milliers de pages, ce surcoût s’accumule. Vous pouvez vérifier vous-même le nombre de tokens de n’importe quelle page avec le tokenizer public d’OpenAI : collez le code source HTML brut et comparez-le à une version nettoyée.
Écrivez des paragraphes autonomes. Chaque paragraphe doit énoncer un point complet, qui puisse être extrait et cité indépendamment. Si comprendre le paragraphe quatre exige d’avoir lu les paragraphes un à trois, vous avez écrit de la prose, pas du contenu citable. Cela ne signifie pas simplifier à l’excès. Cela signifie rappeler le contexte quand il le faut, définir les termes dès qu’on les introduit et traiter chaque paragraphe comme une unité qui pourrait, en théorie, figurer seule dans la réponse de quelqu’un d’autre. Pensez briques de Lego, pas dalle de béton coulée d’un seul bloc.
L’effet « Lost in the Middle » (perdu au milieu)
Un biais bien documenté touche la façon dont les LLM traitent les longs documents. Des recherches montrent que les LLM présentent un phénomène de « lost in the middle » : la précision chute nettement pour les informations situées vers le centre de la fenêtre de contexte, tandis que le début et la fin reçoivent une attention disproportionnée. Cette courbe en U (performance élevée au début, dégradation au milieu, puis reprise à la fin) a été observée de façon constante sur GPT-3.5, Claude et d’autres grands modèles. Pour les créateurs de contenu, cela se traduit par une règle concrète : la réponse vient en premier. Votre affirmation, votre définition ou votre enseignement le plus important doit figurer dans les premières lignes de chaque section, et non après trois paragraphes de mise en contexte. Le milieu de votre article recevra toujours moins de poids. Cela ne veut pas dire qu’il ne faut pas l’écrire. Cela veut dire qu’il ne faut pas compter dessus.
Chaque moteur fonctionne différemment Les données montrent clairement que ChatGPT, Perplexity, Google AI Overviews et Gemini ne sont pas des cibles interchangeables. Une étude de Kevin Indig portant sur 3 981 domaines a constaté que Gemini nomme des marques dans 83,7 % de ses apparitions mais ne génère un lien de citation que dans 21,4 % des cas, alors que ChatGPT est l’inverse : il cite dans 87,0 % des cas mais ne mentionne des marques que dans 20,7 % des réponses. Optimiser pour l’un n’aide pas automatiquement l’autre.
Perplexity est conçu comme un moteur qui place la citation au premier plan, et c’est celui dont les résultats s’alignent le plus avec le haut des résultats organiques de Google. ChatGPT applique sa propre couche de sélection par-dessus. Google AI Mode puise dans l’index de Google, mais avec un recouvrement au niveau des URL plus lâche que celui d’AI Overviews. Ce sont des architectures de récupération différentes, avec des biais différents, un point sur lequel nous reviendrons tout au long de ce guide. Comprendre ce paysage est le préalable à tout ce qui suit. Le GEO ne consiste pas à tromper un système unique. Il s’agit de rendre votre contenu structurellement facile à extraire, sémantiquement clair et assez crédible pour que n’importe quel système de récupération, quelle que soit son architecture sous-jacente, juge qu’il mérite d’être cité.
Comprendre comment les LLM lisent le contenu est une chose. Changer la façon de l’écrire en est une autre. Cette section présente les trois principes de structure qui ont l’effet le plus direct sur les taux de citation et qui ne demandent aucune compétence technique.
BLUF signifie « Bottom Line Up Front » (l’essentiel en premier). C’est un principe de communication emprunté à l’armée : énoncer d’abord l’information la plus importante, puis fournir le contexte et le raisonnement. Pour le GEO de contenu, ce n’est pas une préférence de style : c’est une exigence technique. Les données sont d’une netteté inhabituelle. Une analyse de Kevin Indig portant sur 1,2 million de réponses de ChatGPT et 18 012 citations vérifiées a montré que 44,2 % de toutes les citations proviennent des 30 premiers % du contenu d’une page . Il décrit ce schéma comme une distribution en « rampe de ski », constatée dans tous les lots de validation avec une signification statistique. Les citations viennent de façon disproportionnée du début de votre contenu. Le milieu est l’endroit où elles vont mourir.
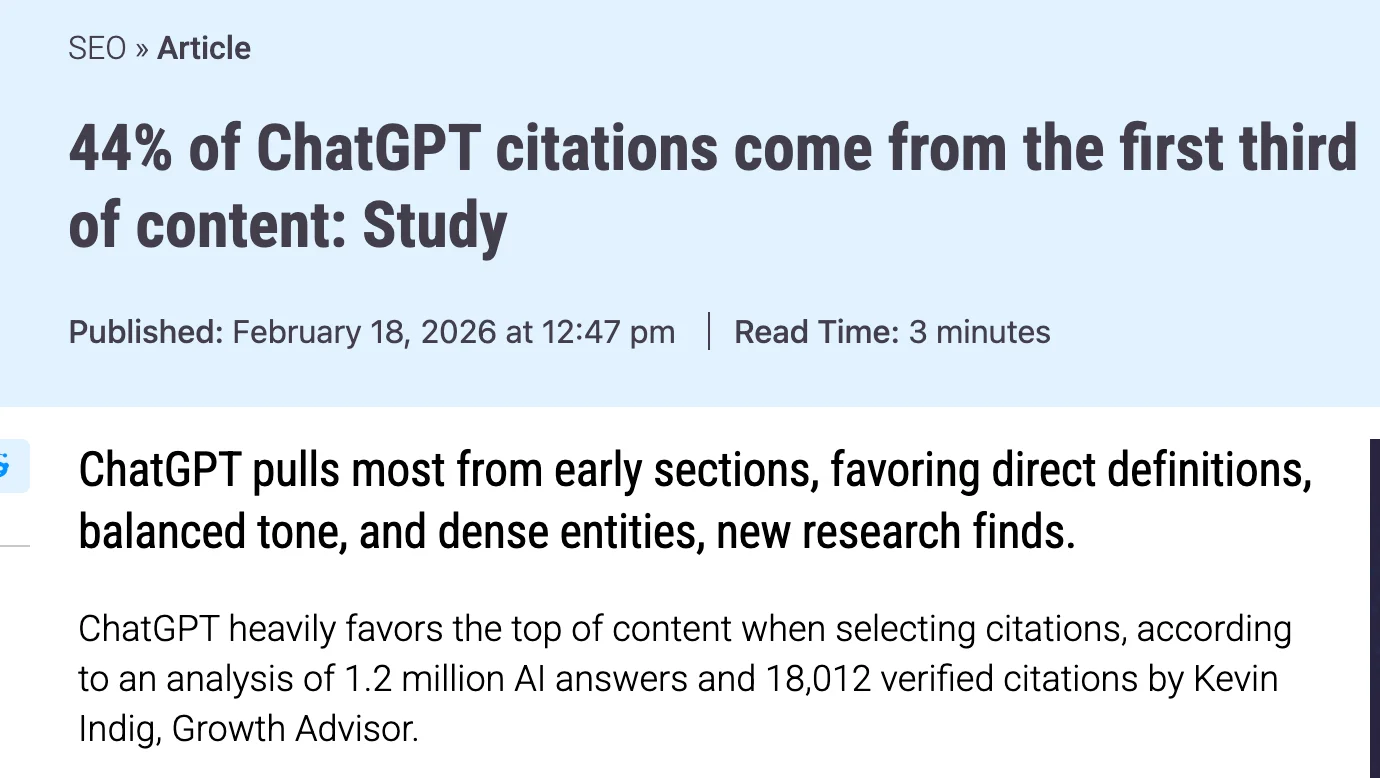
Cela rejoint directement l’effet Lost in the Middle présenté en Partie 1 . Mais l’implication est ici éditoriale, pas technique : la façon dont la plupart des contenus SEO ont été écrits depuis dix ans (longue introduction, mise en contexte progressive, enseignement clé enfoui trois écrans plus bas) est structurellement mal alignée avec la manière dont les LLM extraient l’information. Un contenu qui oblige un système de récupération à analyser 500 mots de préambule avant de trouver la réponse est récupéré de façon constamment moins fréquente pour les requêtes de définition. En 2026, un contenu qui demande une interaction de type « scroller pour trouver la valeur » est souvent abandonné purement et simplement par les agents de récupération. La solution est simple à décrire, mais plus difficile à intégrer quand on a écrit autrement pendant des années :
Il a aussi été constaté qu’un contenu cité a 2 fois plus de chances de comporter un point d’interrogation, et que 78,4 % des citations liées à des questions provenaient de titres. L’IA semble donc souvent traiter les H2 comme des prompts et le paragraphe qui suit immédiatement comme la réponse. Si vos titres sont des étiquettes vagues (« Contexte », « Présentation », « Plus d’informations ») plutôt que des questions directes ou des affirmations, vous laissez des citations sur la table.
Les pipelines RAG ne lisent pas votre article. Ils en extraient des segments, en général au niveau du paragraphe ou de la section sous un titre, et évaluent chaque segment indépendamment pour sa pertinence par rapport à la requête. Cela a une implication concrète sur la façon d’écrire. Si vos paragraphes sont trop longs ou couvrent plusieurs idées, les modèles peinent à décider quelle phrase répond le mieux à une requête. Des paragraphes courts et autonomes donnent aux LLM des limites claires et facilitent l’extraction d’informations pertinentes sans perte de contexte. Pensez à chaque paragraphe comme à une brique de Lego. Une brique a une forme définie et s’assemble proprement avec les autres. On peut la prendre et l’utiliser seule. Un paragraphe qui oblige le lecteur à avoir assimilé les trois précédents pour être compris n’est pas une brique : il fait partie d’une dalle coulée. On ne peut ni l’extraire, ni le citer proprement. Face à un tel paragraphe, un LLM le reformulera lourdement ou trouvera un concurrent mieux structuré. Concrètement, cela signifie :
C’est la principale habitude d’écriture à rompre pour les rédacteurs SEO expérimentés. Le style de prose fluide et enchaînée, qui se lit bien dans un article long (avec rappels, anaphores et idées qui se construisent d’un paragraphe à l’autre), est activement pénalisé dans les contextes de récupération. La lisibilité pour les humains et l’extractibilité pour les machines ne sont pas toujours la même chose. Quand elles entrent en conflit, la structure l’emporte.
Votre structure de titres doit fonctionner comme une table des matières qu’une machine, ou un humain qui survole la page en trois secondes, peut utiliser pour comprendre toute l’étendue de votre article sans lire un seul paragraphe. Les pages dont les titres répondent directement à la question sont citées dans 41 % des cas. Les pages aux titres vaguement liés au sujet tombent à 29 %. Cet écart de 12 points vient entièrement de la façon dont le titre correspond à la requête, et non du nombre de mots, de l’autorité du domaine ou de la qualité du texte situé dessous. Les règles pratiques :
Utilisez 3 à 5 niveaux de titres au maximum. H1 pour le titre de l’article, H2 pour les grandes sections, H3 pour les sous-sections. Au-delà de H4, vous ajoutez une hiérarchie qui alourdit la charge cognitive sans aider la navigation. Plus de niveaux, c’est plus de bruit pour un système de récupération qui cherche à comprendre l’architecture de votre contenu.
Rédigez les titres comme des réponses directes ou des questions directes, pas comme des étiquettes. Comparez :
❌ <h2>Vitesse de page</h2>
✅ <h2>La vitesse de page influence-t-elle les taux de citation des LLM ?</h2>
❌ <h2>Présentation de l’E-E-A-T</h2>
✅ <h2>Comment les signaux E-E-A-T influencent la visibilité GEO</h2>
La première version indique un sujet à la machine. La seconde lui indique une affirmation ou une question, ce que cherche réellement un système de récupération quand il évalue si votre contenu correspond à une requête d’utilisateur.
Lisez vos titres à la suite, sans le texte. Si le plan n’a pas de sens logique tout seul, c’est-à-dire si vous ne pouvez pas suivre l’argumentation du H1 au dernier H2 sans lire un seul paragraphe, votre structure doit être retravaillée. Un article bien structuré se parcourt au seul niveau des titres. Cette navigabilité est précisément ce qui permet à un système de récupération d’identifier le bon segment à extraire pour une sous-requête donnée.
Il existe une catégorie de modifications de contenu qui se distingue de toutes les autres dans la recherche sur le GEO : elles demandent très peu de réécriture, s’appliquent à presque tous les types de contenu et ont l’effet le plus constant d’un LLM à l’autre et d’un domaine de requêtes à l’autre. Ce sont aussi celles que les équipes de contenu, concentrées sur la structure et la sémantique, ignorent le plus souvent. Ajouter des statistiques précises et des citations d’experts est la tactique GEO au meilleur retour sur investissement. Voici ce que disent réellement les preuves.
Ce qu’a constaté l’étude de Princeton La recherche fondatrice sur le GEO, publiée à KDD 2024 par des équipes de Princeton University, de l’IIT Delhi, de Georgia Tech et de l’Allen Institute for AI , a testé plusieurs stratégies d’optimisation de contenu sur un benchmark à grande échelle de requêtes variées. Trois stratégies ont systématiquement surpassé toutes les autres dans tous les domaines : ajouter des citations de sources fiables, intégrer des citations d’experts du sujet et inclure des statistiques précises. Ces trois méthodes ont augmenté la visibilité des sources jusqu’à 40 % dans les réponses des moteurs génératifs, tout en demandant très peu de changements au contenu de départ. Deux points méritent d’être soulignés avant d’appliquer ces résultats. Premièrement, l’ampleur de l’effet varie selon le domaine. L’optimisation par les citations a été la plus efficace pour les requêtes factuelles. L’ajout de statistiques s’est révélé particulièrement bénéfique pour les contenus juridiques et gouvernementaux. L’optimisation « faisant autorité », qui consiste à employer un langage plus persuasif, a donné ses meilleurs résultats sur les contenus historiques. Le principe s’applique largement, mais l’accent change selon votre thématique. Un éditeur juridique et une entreprise SaaS ne doivent pas pondérer ces tactiques de la même façon. Deuxièmement, l’étude a mesuré la visibilité dans les réponses des moteurs génératifs, c’est-à-dire la présence au niveau des mots dans la réponse de l’IA, et pas seulement l’obtention d’un lien de citation. Cette distinction compte. L’objectif n’est pas seulement d’être listé comme source. C’est de voir votre contenu spécifique remonter dans la réponse elle-même.
Lancez un audit gratuit : en quelques minutes, ChatGPT, Gemini et Perplexity répondent en direct à 8 questions d’achat sur votre marché, et vous voyez qui ils recommandent.
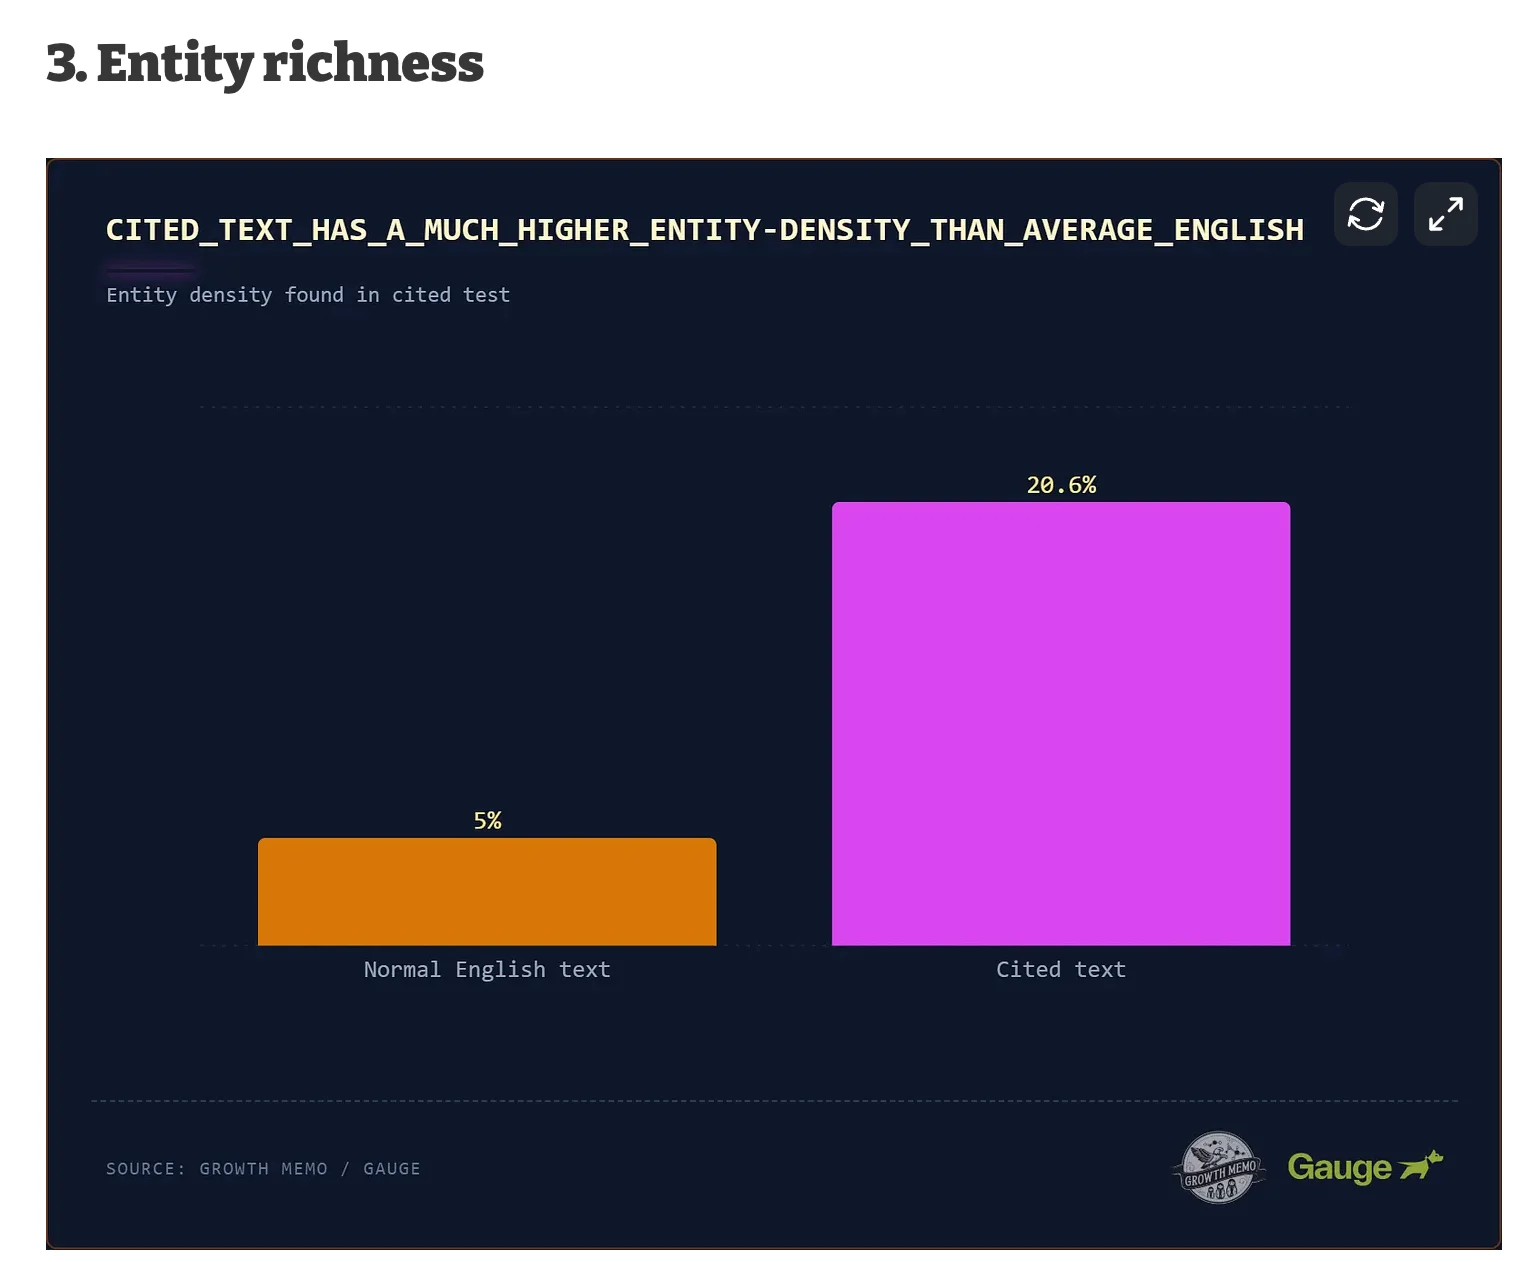
Quand un LLM synthétise une réponse, il cherche à fournir la réponse la plus vérifiable et la plus riche en information possible. Une statistique précise (un chiffre identifié, avec une source identifiée, à une date identifiée) fait trois choses à la fois : elle étaye l’affirmation, elle signale la qualité de la source et elle donne au modèle quelque chose de concret à extraire et à attribuer. Les contenus très cités ont une densité d’entités de 20,6 % , contre 5-8 % pour un texte anglais ordinaire. Les LLM privilégient les phrases qui contiennent des ancres (noms propres, marques, chiffres précis) parce qu’elles réduisent la perplexité de la réponse. Une phrase contenant trois entités porte plus de bits d’information qu’une phrase qui n’en contient aucune.
En pratique, il s’agit de remplacer les références vagues par des références précises et nommées :
Ce n’est pas du bourrage de mots-clés, c’est le contraire. Il s’agit de remplacer un langage vague par des unités précises et citables, qui donnent au modèle quelque chose de concret à extraire et à attribuer. « Les taux de conversion se sont améliorés » ne donne rien au modèle. « Les taux de conversion ont progressé de 34 % en 90 jours, selon une étude de référence de HubSpot de 2025 » lui donne un chiffre, une période et une source nommée, dans une seule phrase. C’est une unité citable. La règle pratique : n’énoncez jamais une affirmation quantifiable sans chiffre, et n’énoncez jamais un chiffre sans source. Les affirmations vagues sont absorbées dans la réponse de façon anonyme. Les statistiques sourcées sont extraites et attribuées.
Le mécanisme des citations d’experts est un peu différent. Il ne s’agit pas d’abord de densité d’entités, mais de transfert de crédibilité. Les LLM sont conçus pour fournir des réponses fondées sur des preuves. Quand il compare des sources concurrentes sur un même sujet, un modèle favorise le contenu qui montre qu’il s’est confronté à des voix faisant autorité dans le domaine. Une citation d’expert signale que le contenu n’est pas une simple opinion : c’est une opinion rattachée à une personne nommée et vérifiable, dont la légitimité sur le sujet est établie. L’étude de Princeton classe l’ajout de citations parmi les trois principales stratégies GEO , aux côtés de l’ajout de sources citées et de statistiques. Ces 3 stratégies peuvent accroître la visibilité d’un contenu jusqu’à 40 %. Bonne nouvelle : toutes les trois demandent très peu de modifications du contenu, tout en améliorant sensiblement la visibilité dans les réponses des moteurs génératifs. Cela rejoint aussi le cadre E-E-A-T que nous traiterons en Partie 5. Un article qui cite un chercheur, un praticien ou une autorité du secteur nommés sur un point controversé est structurellement plus crédible qu’un article qui paraphrase la même information sans attribution. La citation joue le rôle de preuve sociale, non pas pour le lecteur humain, mais pour le système de récupération qui évalue si ce contenu mérite d’être mis en avant.
L’échec typique est l’insertion mécanique : parsemer des statistiques au hasard dans les paragraphes et ajouter des citations qui interrompent le fil. Aucune des deux approches ne fonctionne. Une statistique sans lien avec l’argumentation alentour ajoute du bruit. Une citation qui exige trois phrases de contexte pour être comprise n’est pas une unité citable. Le bon schéma d’intégration suit le principe BLUF de la Partie 2 :
Pour les statistiques :
Exemple :
La plupart des récupérations de LLM se font sans aucune recherche web. Début 2026, ChatGPT n’active la recherche web que sur 34,5 % des requêtes, contre 46 % fin 2024 (Growth Memo, 2026). Pour la majorité des réponses, le modèle répond uniquement à partir de ses données d’entraînement, ce qui fait des connaissances paramétriques et de la présence de la marque dans des sources faisant autorité le principal levier de visibilité.
Pour les citations d’experts :
Une citation introduite par « John Smith, PDG d’Acme, a déclaré… » est plus faible que « John Smith, qui a dirigé l’équipe produit à l’origine du premier déploiement de RAG à grande échelle dans les services financiers, a décrit ainsi le problème : … ». La légitimité qui compte est celle qui se rapporte à l’affirmation.
Les deux ont leur place, et elles remplissent des fonctions différentes dans un article optimisé pour le GEO. Les sources académiques (articles évalués par les pairs, actes de conférences, recherches universitaires) portent le signal de crédibilité le plus fort pour les LLM entraînés sur des textes savants. Elles fonctionnent mieux pour les affirmations fondamentales : établir qu’un principe est réel, qu’un mécanisme existe, qu’un effet a été mesuré. L’étude GEO de Princeton est elle-même un bon exemple de la façon d’utiliser une source académique : citer l’article, citer l’institution, citer le résultat précis. Les sources sectorielles (rapports d’entreprises, études de praticiens, données de plateformes) fonctionnent mieux pour les affirmations actuelles et appliquées : ce qui se passe maintenant, ce que les praticiens observent sur le terrain, ce que des outils ou des plateformes précis ont mesuré. Une étude de Semrush sur les schémas de citation de ChatGPT ou une analyse de Kevin Indig portant sur 1,2 million de réponses a plus d’autorité pratique qu’un article académique vieux de deux ans pour les affirmations sensibles au temps. Les contenus les plus solides utilisent les deux ensemble : des sources académiques pour établir le mécanisme, des données sectorielles pour montrer l’application concrète actuelle. C’est la logique d’un rapport d’analyste bien documenté, et cette voix d’analyste, comme l’ont montré les données de citation de Kevin Indig, est exactement ce que les LLM ont appris à reconnaître et à récompenser. Une remarque pratique : citez toujours la source d’origine, pas une source secondaire. Si vous avez lu parler d’une étude de Princeton sur un blog marketing, retrouvez l’article original et faites un lien vers lui. Les LLM entraînés sur le web ont vu la source primaire bien plus souvent que ses résumés. Citer l’original augmente les chances que votre référence soit reconnue comme faisant autorité.
L’optimisation sémantique est le domaine où le GEO s’écarte le plus nettement de l’intuition du SEO classique, et celui où l’écart est le plus grand entre les praticiens qui comprennent les mécanismes sous-jacents et ceux qui ne les comprennent pas.
Le SEO traditionnel repose sur un modèle de recherche d’information : Google met en correspondance des signaux de mots-clés avec des pages indexées et les classe selon leur autorité. Le jeu consiste à être le document le plus pertinent pour une chaîne de requête donnée. Les LLM fonctionnent selon un modèle de synthèse. Ils utilisent la recherche par embeddings denses, qui met en correspondance les contenus sur leur sens sémantique plutôt que sur le recouvrement de mots-clés. Une page peut se classer sur Google pour « logiciel de suivi des commerciaux terrain » grâce à l’optimisation de mots-clés, alors qu’un LLM la récupérera peut-être pour « comment les équipes de vente itinérantes suivent-elles l’activité de leurs commerciaux » parce que le sens correspond. Le bourrage de mots-clés nuit activement : les LLM analysent le sens, pas la fréquence des mots-clés. Cette distinction a une implication concrète. La question n’est plus « cette page contient-elle les bons mots-clés ? », mais « cette page couvre-t-elle le bon espace conceptuel ? ». Les LLM utilisent le clustering sémantique, qui regroupe les contenus selon leur sens sous-jacent plutôt que par correspondance de mots-clés, grâce à la recherche vectorielle et à la reconnaissance d’entités. Les concepts reçoivent des embeddings numériques dans un graphe multidimensionnel, et la distance entre embeddings détermine si deux idées sont liées. Une page qui couvre des concepts sémantiquement voisins signale une compréhension globale du sujet, et pas seulement une présence superficielle de mots-clés. Pour les SEO qui ont travaillé l’autorité thématique pour Google, le terrain est familier, mais la barre est plus haute. La proximité sémantique compte dans la récupération par les LLM : il ne s’agit pas seulement du volume de couverture du sujet, mais de traiter de façon pertinente les sous-thèmes et les questions connexes, c’est-à-dire du recouvrement de tokens et de la similarité de modèle thématique entre votre contenu et la couverture idéale d’un sujet donné. Une page pilier bien structurée, qui couvre un sujet sous plusieurs angles, surpassera systématiquement une page optimisée pour des mots-clés qui n’aborde que la requête principale.
De tous les signaux de contenu qui prédisent la citation par un LLM, la complétude sémantique est celui dont la corrélation mesurée est la plus forte. Le concept central est le suivant : chaque section de votre contenu fournit-elle une réponse complète et autonome, sans nécessiter de contexte extérieur ? C’est ce que les pipelines RAG sont conçus pour évaluer. Un système de récupération qui extrait un segment de votre page le notera indépendamment par rapport à la requête. Si le segment n’a de sens que dans le contexte des trois paragraphes précédents, il échoue à cette évaluation. À quoi ressemble la complétude sémantique en pratique ? Une section sur « comment les LLM récupèrent le contenu » qui définit le RAG, explique le processus de découpage en segments et donne un exemple concret est sémantiquement complète. Une section qui dit « les LLM utilisent des techniques de récupération (voir Partie 1) » ne l’est pas : elle exige un contexte extérieur pour être comprise, ce qui augmente le coût d’extraction et réduit la probabilité de citation. L’objectif d’écriture pratique : chaque section doit pouvoir tenir seule comme réponse courte et autonome à une sous-requête précise. Définissez les termes quand vous les introduisez. Rappelez le contexte quand c’est nécessaire. Ne supposez pas que le lecteur, ou le système de récupération, a lu ce qui précède.
Au-delà de la couverture thématique, il existe un second signal sémantique, plus fin : la densité d’entités. Comme établi en Partie 3, les contenus très cités ont une densité d’entités de 20,6 %, contre 5-8 % pour un texte anglais ordinaire. Les LLM privilégient les phrases qui contiennent des ancres (noms propres, marques, outils, personnes, concepts précis) parce qu’elles réduisent la perplexité de la réponse. Il ne s’agit pas de bourrage de mots-clés, mais de son contraire. Des entités nommées précises remplacent des généralités vagues. « De nombreux outils peuvent aider » devient « Des outils comme Screaming Frog, Ahrefs et Semrush abordent cela différemment ». La seconde phrase est plus utile, plus citable et mieux ancrée sémantiquement dans l’espace vectoriel du LLM. L’implication pratique pour la relecture : passez vos paragraphes au crible de la densité d’entités. Les paragraphes sans nom propre, sans étude nommée, sans chiffre précis, sans outil nommé sont sémantiquement minces. Ils peuvent se lire avec fluidité, mais ils ne donnent rien de concret au modèle à quoi s’accrocher.
L’une des erreurs d’optimisation sémantique les plus courantes consiste à concentrer le travail sur les mots-clés et les entités en fin d’article, en chargeant une section FAQ de tous les termes sémantiques qui « semblaient manquer » une fois le contenu principal rédigé. C’est la mauvaise approche, pour deux raisons. D’abord, elle enfreint le principe de la rampe de ski : le contenu situé dans les 30 premiers % d’un article est cité dans 44 % des cas . Charger la densité sémantique dans une FAQ finale place vos signaux les plus forts dans votre zone de citation la plus faible.
Ensuite, elle crée un profil sémantique incohérent sur l’ensemble de l’article. La proximité sémantique se mesure au niveau du segment, pas du document. Une introduction sémantiquement pauvre sera peu performante en récupération même si le reste de l’article est solide. Un système de récupération qui extrait votre introduction comme segment candidat la notera indépendamment par rapport à la requête, et si ce segment n’a pas la densité sémantique des introductions de vos concurrents, il ne sera pas sélectionné, quelle que soit la force de votre FAQ. La bonne approche consiste à répartir la couverture sémantique de façon homogène, section par section :
Il existe une dimension plus subtile de l’optimisation sémantique, qui va au-delà de la densité d’entités et de la couverture de mots-clés : les associations conceptuelles qu’un LLM donné a construites autour de votre sujet pendant son entraînement. Quand un LLM répond à une requête, il ne cherche pas des mots-clés correspondants, il prédit quels tokens ont le plus de chances de suivre, à partir des schémas absorbés pendant l’entraînement. Les concepts reçoivent des embeddings numériques, et le modèle mesure la distance entre embeddings pour comprendre les relations. Si votre contenu emploie le même langage conceptuel que celui que le modèle a appris à associer à un sujet, il occupe une position plus proche dans l’espace sémantique du modèle, ce qui augmente la probabilité qu’il soit récupéré et cité pour cette requête. Concrètement, cela signifie écrire avec tout le vocabulaire d’un sujet, pas seulement avec ses mots-clés principaux. Un article sur le GEO qui couvre le RAG, les connaissances paramétriques, le découpage en segments, la densité d’entités, la complétude sémantique et l’attribution des citations occupe davantage de l’espace conceptuel pertinent qu’un article qui ne traite que de « comment se classer sur ChatGPT ». Le premier article correspond à davantage d’associations sémantiques que le modèle a construites autour du sujet. Le second n’en touche qu’une surface étroite. C’est pourquoi la profondeur thématique, c’est-à-dire le fait de s’engager réellement dans toute l’étendue intellectuelle d’un sujet, reste la stratégie GEO la plus durable. L’optimisation pour la recherche IA consiste moins à tromper un algorithme qu’à publier le type de contenu qui pourrait raisonnablement passer une évaluation par les pairs rigoureuse . Un contenu qui couvre un sujet de manière exhaustive, emploie une terminologie précise et prend en compte la complexité réelle du sujet occupera davantage de l’espace sémantique pertinent, et sera davantage cité en conséquence.
L’E-E-A-T (Experience, Expertise, Authority, Trustworthiness, c’est-à-dire expérience, expertise, autorité et fiabilité) est un cadre de qualité de contenu de Google depuis 2018. La plupart des SEO connaissent l’acronyme. Moins nombreux sont ceux qui comprennent à quel point il fonctionne différemment dans un contexte génératif, ou qui vont bien au-delà de la checklist habituelle « ajouter une bio d’auteur et un peu de schema ». Dans le GEO, l’E-E-A-T n’est pas qu’un signal de qualité pour le classement. C’est un filtre de crédibilité qui détermine si un système de récupération fait assez confiance à votre contenu pour le citer, et si, lorsqu’il le cite, il vous nomme ou absorbe anonymement votre contenu dans sa réponse.
Le cadre E-E-A-T de Google a été conçu pour des évaluateurs de qualité humains. Les LLM appliquent une logique structurellement similaire mais plus automatisée : ils sont conçus pour éviter d’amplifier la désinformation, ce qui fait de la crédibilité des sources une préoccupation de premier ordre dans chaque décision de récupération. Le mécanisme est architectural : les LLM sont entraînés à minimiser les hallucinations et à préférer les affirmations qu’ils peuvent vérifier de manière indépendante. Un contenu anonyme (article sans auteur nommé, sans qualifications indiquées, sans références externes) ne donne au modèle rien à quoi se référer pour vérifier. Un auteur nommé, présent de façon cohérente sur le web, dont le contenu est relié à ses profils professionnels par un balisage schema et qui est mentionné par des sources tierces faisant autorité, donne au modèle plusieurs points de confirmation indépendants. Le signal de crédibilité n’est pas déclaré : il est recoupé. L’écart pratique entre une application correcte de l’E-E-A-T et une application superficielle est important. Ajouter un nom dans la signature d’un article est le minimum. Ce qui fait vraiment la différence, c’est de construire un graphe d’entités vérifiable : un ensemble de signaux cohérents et lisibles par les machines, qui permettent aux LLM de vérifier de manière indépendante qui a écrit votre contenu, quelles sont ses qualifications et si le reste du web confirme cette crédibilité.
Le travail sur l’E-E-A-T se divise nettement en deux dimensions, qui demandent chacune un type d’effort différent. La crédibilité sur le site est ce que démontre votre contenu lui-même. Un article bien sourcé, qui cite des études nommées, inclut des exemples de première main, s’appuie sur des expériences réelles et est rédigé par un auteur identifiable aux qualifications indiquées, est intrinsèquement plus crédible qu’un article qui avance les mêmes affirmations de façon anonyme. C’est la couche éditoriale, directement liée aux Parties 3 et 4 : statistiques précises, citations d’experts et densité d’entités ne sont pas seulement des tactiques d’optimisation sémantique. Ce sont aussi des signaux E-E-A-T. L’autorité hors site est ce que le reste du web dit de vous. Une analyse de 680 millions de citations dans ChatGPT, Google AI Overviews, Perplexity, Gemini et Claude par 5WPR a constaté que les 15 premiers domaines captent 68 % de toute la part de citations de l’IA, une concentration bien plus extrême que tout ce que le PageRank de Google a produit. Les marques qui occupent cet espace y sont parvenues parce qu’elles sont constamment référencées, commentées et citées par d’autres sources faisant autorité, et non parce qu’elles ont optimisé correctement une seule page. Cela a une implication contre-intuitive pour les petits éditeurs. Votre stratégie de contenu et votre stratégie de relations presse sont désormais la même stratégie. Chaque mention dans la presse, chaque passage en podcast, chaque citation d’expert dans une publication sectorielle, chaque intervention en conférence qui génère de la couverture : ce ne sont pas que des activités de notoriété. Ce sont des signaux E-E-A-T hors site qui influencent directement la décision des LLM de vous inclure dans leur ensemble de sources de confiance.
Le balisage schema est l’infrastructure technique qui rend vos signaux E-E-A-T lisibles par les machines. Il ne crée pas la crédibilité : il la communique. Fabrice Canel, chef de produit principal chez Bing (Microsoft), a confirmé en mars 2025 à SMX Munich que le balisage schema aide les LLM de Microsoft à comprendre les contenus pour Copilot. En revanche, une étude de Search Atlas de décembre 2024 n’a trouvé aucune corrélation entre la couverture en balisage schema et les taux de citation. Les sites dotés d’un schema complet ne surpassaient pas systématiquement ceux dont le balisage était minimal ou inexistant. L’interprétation est claire : le schema est une infrastructure nécessaire, pas un levier de citation à lui seul. Une page sans substance E-E-A-T mais dotée d’un schema parfait ne fera pas mieux qu’une page crédible et bien sourcée avec un schema minimal. Le schema aide les LLM à analyser ce que vous leur dites, mais il ne remplace pas le fait d’avoir quelque chose de crédible à dire. La mise en œuvre de base du schema pour la crédibilité GEO :
Person sur chaque page d’auteur, avec name, jobTitle, knowsAbout et sameAs renvoyant vers LinkedIn, les profils professionnels et toute présence sur WikipédiaOrganization sur votre site, avec sameAs renvoyant vers Wikidata, Crunchbase, la page entreprise LinkedIn et tout annuaire de référence pertinent pour votre secteurArticle sur chaque contenu, avec author référençant l’entité Person, datePublished et dateModifiedLa propriété sameAs est l’élément le plus sous-utilisé ici. Quand vous reliez un schema Organization à un schema Person par une propriété adaptée comme founder ou employee, et réservez sameAs aux références de la même entité, vous créez un fait vérifiable et lisible par les machines que les systèmes d’IA peuvent recouper avec des sources externes pour le confirmer en confiance. Sans cela, un LLM peut lire vos affirmations sur votre expertise, mais il ne peut pas les vérifier de façon indépendante.
Selon l’analyse Brand Radar d’Ahrefs portant sur 76,7 millions d’interactions IA en juin 2025 , Wikipédia est le domaine le plus cité dans ChatGPT, Perplexity et Google AI Overviews, ChatGPT le citant avec une part de mentions de 16,3 %, la plus élevée de toutes les plateformes. Des données indépendantes confirment cette domination : l’analyse de Qwairy sur les schémas de citation de l’IA pour des requêtes GEO place wikipedia.org dans le top 10 des domaines les plus cités, avec une position moyenne de citation de 6,3, soit un positionnement d’autorité supérieur à celui de la plupart des sources commerciales. Pour la plupart des marques, obtenir une page Wikipédia n’est pas réaliste. Mais le mécanisme sous-jacent est instructif : les LLM font confiance aux contenus encyclopédiques, factuels et bien référencés, qui définissent clairement les entités. Vous pouvez reproduire cette structure sans avoir de page Wikipédia. L’équivalent pratique est ce que certains praticiens appellent un « hub d’entité » : une page unique et bien structurée sur votre propre domaine, qui définit votre marque comme une entité : ce qu’elle est, ce qu’elle fait, quand elle a été fondée, qui la dirige, pour quoi elle est connue, avec des références externes qui corroborent ces éléments. Pas une page marketing. Une page informative structurée comme Wikipédia structure ses notices, avec la même exigence de précision factuelle et de sources externes.
Il reste une dernière dimension de l’E-E-A-T que la plupart des guides GEO ignorent : la différence entre être cité et être nommé. Quand une IA répond à une question en s’appuyant sur votre contenu, elle vous cite généralement avec un lien source. Ce qu’elle ne fait pas, dans 62 % des cas, c’est dire votre nom, comme le documente la recherche de Kevin Indig sur les citations fantômes . Le lien est là. La mention de la marque, non. C’est le problème des citations fantômes. Votre contenu construit la réponse de l’IA. Votre marque n’obtient aucun crédit dans le texte. Le schéma varie fortement selon la plateforme. Une recherche portant sur 3 981 domaines a constaté que Gemini nomme des marques dans 83,7 % de ses apparitions mais ne génère un lien de citation que dans 21,4 % des cas, tandis que ChatGPT est pratiquement l’inverse : il cite dans 87 % des cas mais ne mentionne des marques que dans 20,7 % des réponses. Optimiser pour l’un n’améliore pas automatiquement l’autre : ils demandent des approches différentes. Réduire les citations fantômes exige d’aller au-delà de l’optimisation de contenu, vers la construction d’entité : être nommé dans des sources tierces auxquelles les LLM font confiance, de sorte que le modèle ait appris à associer le nom de votre marque aux affirmations que vous faites. Quand un modèle a rencontré à plusieurs reprises le nom de votre marque dans le contexte d’un sujet précis (couverture presse, citations d’experts, rapports sectoriels, actes de conférences), il est plus susceptible de vous mentionner par votre nom lorsqu’il cite votre contenu, plutôt que de vous traiter comme une source anonyme. C’est là que l’E-E-A-T et l’autorité hors site se rejoignent. Les marques qui sont nommées sont celles dont on a parlé. Les relations presse digitales ne sont pas facultatives dans le GEO : c’est le mécanisme qui transforme les citations fantômes en citations attribuées.
Il existe une catégorie d’erreurs GEO qu’aucune optimisation sémantique, aucun travail sur l’E-E-A-T ni aucune structure BLUF ne peut corriger : cibler le bon sujet avec le mauvais type de page. Avant toute question d’optimisation (quelle longueur, quelle structure, combien d’entités), il y en a une préalable : est-ce le bon format pour cette requête ?
L’un des enseignements les plus directement exploitables de l’étude de Kevin Indig et d’AirOps portant sur 16 851 requêtes ChatGPT et 353 799 pages concerne la focalisation des pages. Les pages qui gagnent sont systématiquement ciblées. Les pages mixtes, ces « guides ultimes » qui couvrent tous les sous-thèmes possibles, ont le plus grand nombre de mots, le plus de titres et la plus forte autorité de domaine de l’échantillon. Ce sont aussi les moins fiables dans ChatGPT. Cela a des conséquences directes sur la structure de votre bibliothèque de contenus. L’instinct qui a bâti les stratégies de contenu SEO pendant dix ans, créer une page hub complète qui se classe sur toutes les variantes d’un sujet, nuit activement aux performances GEO. Une page qui répond correctement à vingt questions sera systématiquement surpassée par une page qui répond de façon définitive à une seule. La conséquence pratique : là où votre stratégie SEO compte des pages hub à large couverture thématique, votre stratégie GEO doit compter des pages satellites, chacune construite autour d’une requête unique et précise. Pas « le guide complet des outils de travail à distance », mais des pages distinctes pour « les meilleurs outils de gestion de projet pour équipes à distance », « comment mener des stand-ups asynchrones » et « comparatif des outils de visioconférence ». Chaque page cible une question, y répond de façon définitive dans les 30 premiers % du contenu et laisse la structure des titres communiquer la réponse sans qu’il soit nécessaire de lire le corps du texte. Une nuance importante : cela vaut pour la constance des citations, pas pour leur volume. Selon l’étude de suivi de Kevin Indig sur la façon dont l’IA choisit ses sources , une seule page evergreen couvrant plus de 10 intentions de requête vaut plus, en portée de citations IA, que 10 pages à intention unique. Mais ces pages evergreen gagnent leur largeur par la profondeur structurelle, pas par une couverture superficielle. La distinction passe entre une page qui répond de façon définitive à une question par section et une page qui évoque vaguement vingt sujets. C’est la profondeur par section, et non l’étendue des sujets, qui fait gagner des citations constantes.
Le processus d’audit est simple, mais il doit être mené directement dans les LLM où vous voulez apparaître, et non déduit des classements Google.
Étape 1 : lancez vos requêtes cibles dans ChatGPT et Perplexity. Ne vous contentez pas de demander « qu’est-ce que X ». Posez les requêtes que votre audience utilise réellement : « meilleur X pour Y », « comment faire X », « X vs Y », « X vaut-il le coup ». Pour chacune, notez les pages citées et leur type : article, comparatif, guide, page produit, page d’accueil.
Étape 2 : repérez le type de page dominant pour chaque requête. Si 4 résultats cités sur 5 pour « meilleurs outils de gestion de projet » sont des comparatifs, et que vous avez un article de blog, vous avez un décalage de typologie. La solution n’est pas d’optimiser l’article de blog : c’est de créer une page de comparatif.
Étape 3 : vérifiez la couverture des sous-thèmes face aux requêtes de fan-out. Chaque requête reçue par ChatGPT génère en moyenne 2 sous-requêtes de fan-out, et ChatGPT récupère environ 10 URL par sous-recherche avant de choisir lesquelles citer. Lancez votre requête cible, notez les sous-requêtes de fan-out qui apparaissent et vérifiez que votre page comporte des sections qui y correspondent directement. Si votre page n’a aucun titre qui correspond à une sous-requête de fan-out, elle ne sera pas récupérée pour cette sous-requête, et n’a donc aucune chance d’être citée pour elle.
Étape 4 : vérifiez le signal d’intention de votre début de contenu. Les pages qui ouvrent sur les prix envoient un signal d’intention commerciale et sont classées comme des pages de vente plutôt que comme des sources de référence. Relisez les 150 premiers mots de toute page que vous voulez voir citée. S’ils se lisent comme un argumentaire produit, une landing page ou un plaidoyer commercial, reclassez la page, ou créez une version informative parallèle qui couvre le même sujet sans le cadrage de conversion.
Étape 5 : comparez votre type de page au résultat le plus cité. Si le résultat le plus cité est un guide comparatif de 2 000 mots et que le vôtre est une FAQ de 500 mots, l’écart est d’abord typologique avant d’être un problème de qualité de contenu. Alignez d’abord le format, puis optimisez le contenu.
Le GEO n’est pas une optimisation ponctuelle. C’est une compétition continue contre des concurrents qui mettent eux aussi à jour, améliorent et se disputent les mêmes places de citation. Une page qui obtient des citations aujourd’hui les perdra si elle cesse d’en mériter, et les données sur la fraîcheur montrent à quelle vitesse cela peut arriver.
Content Opportunities liste les sujets où l’IA mentionne vos concurrents mais pas votre marque, chacun avec un score d’impact.
En SEO traditionnel, une page bien optimisée peut conserver sa position pendant des mois, voire des années, avec très peu de maintenance. Les signaux qui font les classements organiques (backlinks, autorité de domaine, profondeur thématique) évoluent lentement. Le GEO ne fonctionne pas ainsi. Une étude de Seer Interactive portant sur plus de 5 000 URL dans ChatGPT, Perplexity et AI Overviews révèle un net biais de fraîcheur : près de 65 % des visites de bots IA ciblaient du contenu publié dans l’année écoulée, 79 % dans les deux dernières années et 89 % dans les trois dernières. Seules 6 % des interactions IA concernaient du contenu de plus de six ans. L’analyse de 17 millions de citations par Ahrefs sur plusieurs plateformes IA confirme cette tendance : le contenu cité par l’IA est en moyenne 25,7 % plus récent que celui cité dans les résultats organiques traditionnels de Google. ChatGPT affiche le biais de fraîcheur le plus marqué, avec 76,4 % de ses pages les plus citées mises à jour dans les 30 derniers jours. Perplexity est encore plus extrême, avec environ 50 % de l’ensemble de ses citations provenant du seul contenu de l’année en cours. L’implication est structurelle. Une page qui n’a pas été touchée depuis douze mois subit un désavantage de citation important, quelle que soit sa qualité d’origine. Les robots IA passent littéralement moins de temps sur les pages obsolètes. Quand un concurrent plus récent couvre le même sujet, la page obsolète sort vite de la rotation des citations et la regagne rarement sans intervention directe. Cela ne veut pas dire qu’il faut tout réécrire en permanence. Le signal de fraîcheur récompense une réelle amélioration du contenu, pas des changements de date cosmétiques. Le Core Update de décembre 2025 a introduit une pénalité contre la fausse fraîcheur : les sites qui changeaient les dates de publication sans mise à jour significative du contenu ont subi des baisses de signaux de fiabilité et des rétrogradations de classement sur les requêtes sensibles à la fraîcheur. Les changements de date sans changement de contenu correspondant sont détectables et sanctionnés.
L’exigence de fraîcheur n’est pas uniforme. L’analyse sectorielle de Seer Interactive montre que les services financiers exigent un contenu extrêmement récent en raison de réglementations qui évoluent vite, tandis que le voyage laisse plus de marge, un contenu evergreen restant performant. L’énergie affiche une durée de vie de contenu plus longue, en particulier pour les contenus pédagogiques et evergreen. Le cadre pratique pour la cadence de mise à jour :
Le seuil trimestriel n’est pas absolu, mais il fixe le plancher. Les pages non mises à jour chaque trimestre ont trois fois plus de risques de perdre leurs citations IA, selon les recherches 2026 d’AirOps et de Kevin Indig sur l’état de la recherche IA . Dès qu’une alternative plus récente existe, les pages obsolètes sortent vite de la rotation des citations et retrouvent rarement de la visibilité sans intervention directe.
La logique concurrentielle de la maintenance GEO est simple : vous devez être meilleur que vos concurrents actuels, et pas seulement meilleur que votre version passée. Chaque cycle de mise à jour doit inclure un audit des concurrents : lancer vos requêtes cibles dans ChatGPT et Perplexity pour voir ce qui est cité maintenant et pourquoi. Au-delà de la vérification des concurrents, voici ce qu’il faut réévaluer à chaque mise à jour substantielle :
Statistiques et données. C’est la mise à jour au meilleur retour sur investissement. Remplacez chaque statistique obsolète par des données actuelles, avec leur source et leur date. Une page qui citait « AI Overviews est apparu dans 31 % des recherches début 2025 » doit désormais indiquer « AI Overviews apparaît dans environ 50 % de toutes les recherches en 2026 ». Ces mises à jour prennent 20 à 30 minutes par article et produisent régulièrement une amélioration mesurable des citations IA en six semaines . Des données actuelles signalent une expertise actuelle, et les systèmes d’IA récompensent les deux.
Alignement sur l’intention de recherche. Le comportement des requêtes évolue. Une requête surtout informationnelle il y a dix-huit mois peut aujourd’hui avoir une intention commerciale. Relancez vos requêtes cibles et vérifiez si le type de page dominant dans les résultats cités a changé. Si vos concurrents sont passés d’articles de blog à des guides comparatifs, votre typologie de page est désormais mal alignée.
Couverture sémantique. De nouveaux sous-thèmes apparaissent à mesure qu’un domaine évolue. Lancez vos requêtes cibles dans ChatGPT et notez les sous-requêtes de fan-out : ce sont les sous-thèmes que le modèle juge pertinents pour la requête principale. Vérifiez que votre page comporte des sections qui répondent à chaque fan-out. Si trois nouvelles sous-requêtes sont apparues depuis votre dernière mise à jour et que votre page ne les traite pas, votre couverture sémantique s’est dégradée face aux contenus plus récents qui les traitent.
Signaux E-E-A-T. Vérifiez si des statistiques, des citations d’experts ou des citations externes que vous avez incluses sont devenues obsolètes, ou si les sources ont changé. Une étude de 2023 présentée comme « recherche récente » en 2026 nuit activement à la crédibilité. Actualisez les sources qui signalent votre contenu comme périmé.
Signaux techniques de fraîcheur. Mettez à jour le champ dateModified du schema Article quand vous apportez des modifications substantielles. C’est le signal de fraîcheur lisible par les machines le plus fort pour les robots IA. Associez-le à une mention visible « Dernière mise à jour » près du haut de la page, à la fois pour les lecteurs humains et pour les systèmes de récupération qui évaluent la fraîcheur.
Tout n’a pas besoin d’être maintenu à jour en permanence. L’approche pratique consiste à concentrer les ressources de mise à jour sur les pages qui comptent le plus. Commencez par les 20 % de pages qui génèrent le plus de trafic. Les pages qui ont les taux de citation et le trafic les plus élevés sont celles qui risquent le plus d’être déplacées par la fraîcheur et qui valent le plus la peine d’être défendues. Une bibliothèque de 200 pages n’a pas besoin de 200 mises à jour trimestrielles. Elle a besoin de 40 pages maintenues à un rythme soutenu, et du reste surveillé pour repérer les signes de vieillissement. Le symptôme visible du déclin des citations apparaît souvent dans les métriques organiques avant d’apparaître dans le suivi des citations IA : un taux de clic en baisse sur une page jusque-là stable, une chute des impressions sur la requête principale, une concurrence croissante de pages plus récentes. Ce sont des signes que le déplacement par la fraîcheur a commencé. Considérez-les comme des déclencheurs de mise à jour plutôt que d’attendre un cycle de revue planifié. Les marques qui conservent leur visibilité GEO dans la durée ne sont pas celles qui publient le plus. Ce sont celles qui traitent leur bibliothèque de contenus comme un actif vivant, avec des responsables désignés, un suivi du vieillissement et un processus systématique pour que leurs pages les plus importantes restent meilleures que tout ce que leurs concurrents ont publié le trimestre dernier.
Utilisez cette checklist pour auditer une page existante ou relire un nouveau contenu avant publication. Parcourez-la dans l’ordre : les premiers points sont fondamentaux, les suivants s’appuient sur eux.
<strong> redondant dans les titres, pas de classes de présentation sur les balises de titreArticle est en place, avec author, datePublished et dateModifiedPerson existe pour l’auteur, avec sameAs renvoyant vers LinkedIn ou des profils professionnelsOrganization existe sur le site, avec sameAs renvoyant vers Wikidata, Crunchbase ou un équivalentdateModified est mis à jour à chaque modification substantielledateModified reflète la dernière mise à jour substantielleSuivez les questions qui comptent pour votre activité, voyez quelles marques chaque réponse mentionne et quelles sources elle cite, puis travaillez sur les manques.
Offre gratuite avec 120 crédits initiaux • Sans carte bancaire
Autres articles
How to Improve Your Brand Sentiment in ChatGPT and AI Search
Being mentioned by ChatGPT is not enough if it calls your products overpriced. A step-by-step process to analyze and improve how AI assistants talk about your brand, with Nike as an example.
Stratégie GEO : 5 vérités sur la recherche IA et un cadre en 4 étapes
Cinq vérités sur la recherche IA partagées au SEO & GEO Summit de Paris, et le cadre GEO en 4 étapes de Qwairy pour être recommandé par ChatGPT ou Gemini.