Loading page

Qwairy cartographie les cas où ChatGPT Shopping apparaît sur plus de 100 000 exécutions suivies. Un test apparié mesure des taux de 21,7 % à 96,7 %.
ChatGPT Shopping ne commence pas par un classement de produits. Il commence par une décision : Shopping doit-il apparaître ? Qwairy a combiné un panel de suivi de plus de 100 000 exécutions ChatGPT terminées avec un test apparié équilibré. Le panel couvre des dizaines de milliers de textes de prompts distincts, des centaines de marques, 15 paramètres régionaux de langue configurés et 33 pays. Dans le test apparié, des fiches Shopping sont apparues dans 21,7 % des scénarios informationnels, contre 95 % des scénarios de recommandation et 96,7 % des scénarios « où acheter ». La catégorie et le cas d’usage restaient appariés ; seule la tâche demandée changeait. Nous avons ensuite retracé la séquence observable : reformulation de la requête, sources, recherches propres à des produits, classement des produits et classement des marchands.

Test apparié ; le panel de suivi, plus large, est analysé séparément.
Ici, le cadrage commercial consiste à demander à ChatGPT de recommander ou de localiser un produit achetable, de comparer des options ou d’évaluer des prix. Mentionner une catégorie de produits ne suffit pas à garantir l’apparition de Shopping. Le test apparié rend la distinction concrète :
« Où puis-je acheter… » a déclenché Shopping dans 96,7 % des observations contrôlées. Les recommandations directes ont atteint 95 %. Les comparaisons ont atteint 85 %. Les prompts formulés comme des conseils généraux ne produisaient des fiches que dans 21,7 % des cas. Les demandes de tests et d’avis ont atteint 53,3 %. Les contraintes de budget et les contraintes chiffrées ont produit des taux d’apparition intermédiaires, de 76,7 % et 78,3 % respectivement. Sur l’ensemble des catégories de produits appariées, la formulation « où acheter » a augmenté l’apparition de Shopping de 75 points de pourcentage par rapport à la référence informationnelle. Le langage de recommandation l’a augmentée de 73,3 points. Dans le panel de juillet, plus large, Shopping est apparu dans 11,2 % des exécutions terminées, mais sa composition n’était équilibrée ni par intention, ni par langue, ni par zone géographique. Le test apparié offre la comparaison la plus propre du cadrage commercial, car la catégorie et le cas d’usage restaient fixes.
Dans le test apparié, la couche des requêtes capturées reformulait les demandes avant l’apparition des recherches propres à des produits. Elle introduisait des critères supplémentaires de spécificité, d’actualité et de découverte de produits. Les requêtes capturées ajoutaient fréquemment des termes absents du prompt d’origine :

Version anglaise d’une paire prompt-requête observée ; mise en forme normalisée pour la lisibilité. Cela change le problème d’optimisation. Les équipes e-commerce ne se disputent pas seulement les mots tapés par l’acheteur. Elles se disputent aussi les critères introduits ou reformulés dans les requêtes capturées, notamment l’actualité, le langage du type « meilleur », les termes commerciaux et la pertinence locale.
Lancez un audit gratuit : en quelques minutes, ChatGPT, Gemini et Perplexity répondent en direct à 8 questions d’achat sur votre marché, et vous voyez qui ils recommandent.
Dans le test apparié, les deux résultats présentaient la même empreinte médiane de sources : 13 références de sources capturées, issues de 9 domaines distincts. Les réponses avec Shopping ne présentaient pas une empreinte médiane de sources plus large que celles sans Shopping. Les sources éditoriales, d’avis et communautaires dominaient la couche de recherche observée.

Les deux groupes de résultats avaient la même ampleur médiane de sources ; le graphique n’estime pas l’influence des sources. Amazon était presque absent des listes de sources de recherche capturées par ce test apparié, même lorsque Shopping apparaissait. Cela n’exclut pas Amazon ni d’autres sources dans des couches amont que le collecteur ne peut pas observer. La visibilité des places de marché et des revendeurs devient une question distincte, plus loin, lorsque les marchands sont classés. La présence d’une source capturée ne prouve pas son influence. Les données ne permettent pas d’attribuer un poids causal à un domaine donné ni de relier une source à un produit sélectionné.
La couche de recherche observée contenait généralement une seule requête reformulée ; les requêtes distinctes multiples au niveau de la catégorie étaient rares. Dans les structures de réponse capturées, la plus forte ramification apparaissait à l’étape des recherches de produits. Dans les réponses avec Shopping disposant de données brutes observables, 98,8 % contenaient des requêtes de recherche propres à des produits. Le fan-out médian portait sur quatre produits nommés, avec une étendue observée de un à dix. Ces recherches nommaient généralement des modèles précis de casques audio, de matelas ou de poussettes.

Il s’agit du pipeline de réponse observable, et non d’une cartographie complète du système interne privé d’OpenAI. Cela complète l’analyse de Profound au niveau du réseau . Profound a analysé des journaux réseau à grande échelle pour en déduire le fan-out des requêtes produit et les relations entre fiches produits et offres. Qwairy traite une autre question avec un dispositif apparié : quels schémas de prompts font apparaître Shopping, et à quelle fréquence le même prompt change de résultat. Les études observent des couches différentes. Les URL de destination capturées par Qwairy montrent vers où pointent les liens d’achat ; elles ne permettent pas de savoir si les métadonnées des fiches produits proviennent d’un crawl du web ou d’un flux produit direct.
Le même prompt ne produisait pas toujours le même résultat. Shopping s’est activé puis désactivé dans 42,7 % des scénarios appariés au fil des observations répétées.

Cinq observations répétées par scénario prompt-catégorie, avec le même dispositif de collecte. Le cadrage commercial modifiait les chances sans rendre le résultat déterministe. Parmi les facteurs possibles figurent la variation du modèle, l’évolution de la disponibilité des candidats et l’éligibilité des produits, mais cette étude ne peut pas isoler leurs effets respectifs. C’est pourquoi une capture d’écran n’est pas une mesure. Le taux de déclenchement doit être suivi sur des observations répétées.
OpenAI documente la sélection des produits et la sélection des marchands comme deux étapes distinctes. Le panel de suivi de juillet de Qwairy montre que l’ensemble de produits collecté était lui aussi instable. Sur des observations consécutives avec Shopping pour une même configuration, le premier élément validé du tableau de produits collecté changeait dans 77,7 % des cas. Dans 45,4 % des paires, les ensembles de produits renvoyés n’avaient rien en commun. Il s’agit d’une mesure de l’ordre de collecte, et non d’une preuve directe de la façon dont chaque utilisateur voyait les fiches agencées. La couche des marchands peut ensuite faire apparaître des revendeurs plutôt que la boutique de la marque. Dans l’étude précédente de Qwairy sur les destinations, seules 6,4 % des destinations d’achat identifiables correspondaient au domaine enregistré de la marque du produit. Pour 51,8 % des domaines de marque éligibles, le domaine enregistré de la marque n’apparaissait jamais comme destination identifiable. Lisez l’étude complète : ChatGPT Shopping : le produit est recommandé, mais où mène le lien d’achat ?.
Dans cet exemple d’interface, ChatGPT recommande la Nike Pegasus 41. Le panneau de marchands visible liste Intersport, Sport 2000 et SportsShoes.com , et non la boutique de Nike.
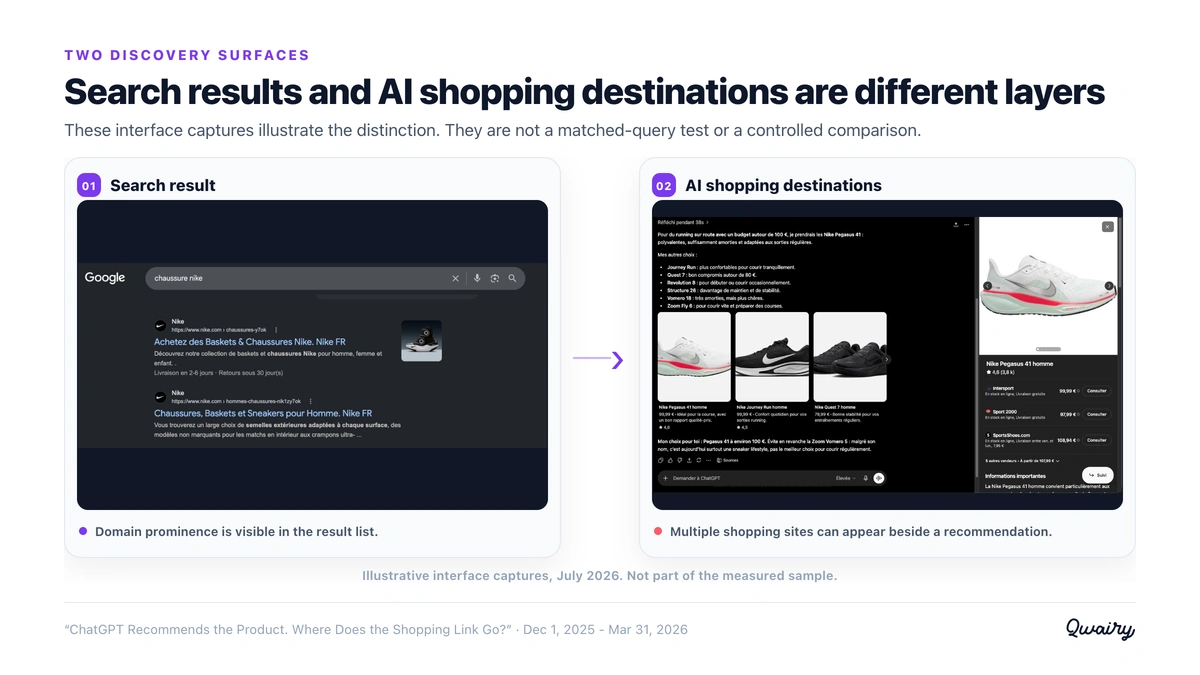
Visuel repris de l’étude de Qwairy sur les destinations marchandes. Capture d’interface en français, juillet 2026 ; elle ne fait partie d’aucune cohorte mesurée dans cet article. Nike peut remporter la recommandation de produit pendant que des revendeurs occupent les emplacements visibles de marchands.
Voyez quelles discussions Reddit, YouTube, LinkedIn et forums les réponses IA citent, selon les modèles et pays pris en charge.
Construisez un jeu de prompts stable couvrant les intentions informationnelle, de comparaison, de recommandation, de budget et d’achat. Suivez l’apparition de Shopping sous forme de taux, et non comme une capture d’écran en oui ou non. Qwairy permet de segmenter ces familles de prompts et de les répéter dans le temps pour repérer où Shopping s’active, disparaît ou change.
Suivez les requêtes et les domaines que ChatGPT fait ressortir autour de chaque intention. Repérez les critères qu’il ajoute, puis assurez-vous que les pages produits, les contenus éditoriaux et la couverture par des tiers y répondent clairement. Ne considérez pas une citation comme la preuve qu’elle a causé un résultat produit.
Autorisez OAI-SearchBot si vous voulez que les pages éligibles apparaissent dans ChatGPT Search. Maintenez exacts les identifiants, titres, descriptions, variantes, images, prix, stocks, informations de livraison et de vendeur. La spécification des flux produits d’OpenAI expose directement ces champs. Un flux peut améliorer la fraîcheur et l’exhaustivité. Il ne garantit ni Shopping, ni la sélection du produit, ni la position du marchand.
Pour chaque produit renvoyé, classez les vendeurs affichés : boutique de la marque, place de marché, revendeur ou autre marchand. Suivez la présence du produit et la destination marchande comme deux KPI distincts. Si l’attribution des clics est disponible, reliez le trafic vers votre propre domaine aux sessions et aux données de paiement first-party, sans y voir une preuve d’incrémentalité.
ChatGPT Shopping est une séquence de décisions et de classements. La destination marchande finale peut diverger de la marque recommandée, même après l’apparition de Shopping.

Qwairy mesure une séquence de couches observables et documentées. Le pipeline interne privé d’OpenAI peut comporter des étapes supplémentaires. Remporter une recommandation de produit n’est qu’une étape. Les équipes e-commerce doivent aussi mesurer si Shopping apparaît, quels produits restent visibles et quels domaines de marchands s’affichent à côté. Auditez la visibilité de vos produits et de vos marchands dans ChatGPT Shopping avec Qwairy.
Le panel de suivi multilingue de juillet 2026 a été figé pour l’analyse le 1er août 2026. Cet instantané contenait 133 609 exécutions ChatGPT terminées, 45 647 textes de prompts distincts et 696 marques, réparties sur 15 paramètres régionaux de langue configurés et 33 pays. Shopping est apparu dans 11,2 % des exécutions terminées. La composition n’était équilibrée ni par intention, ni par langue, ni par zone géographique. Le test apparié a été collecté le 1er août 2026 sur 12 catégories de produits et huit schémas de prompts. Chaque scénario prompt-catégorie a été répété cinq fois avec le même dispositif de collecte, soit 480 réponses. La langue et le marché sont restés constants. Les taux d’apparition principaux proviennent de ce test apparié et ne doivent pas être supposés transposables tels quels à d’autres paramètres régionaux. Les structures de réponse observables ont servi à comparer les requêtes normalisées, les références de sources et les recherches propres à des produits. Un terme n’était compté comme ajouté que s’il était absent du prompt d’origine normalisé ; des lexiques fixes regroupaient le langage de type « meilleur », les indicateurs d’année et les termes commerciaux. Les chiffres relatifs aux marchands proviennent d’une autre étude de Qwairy, sur quatre mois, et n’ont été regroupés avec aucun des deux jeux de données.
Les requêtes capturées, les URL de produits et les URL de marchands n’exposent que la couche de réponse observable, et non le fan-out interne complet d’OpenAI, ses sources de récupération ni ses pondérations de classement. L’ordre du tableau collecté n’a pas été rapproché de façon indépendante de l’ordre affiché dans l’interface de ChatGPT. Les études identifient des destinations visibles, et non le comportement des utilisateurs. Elles n’observent ni impressions, ni clics, ni achats, ni commandes, ni chiffre d’affaires, ni incrémentalité.
Suivez les questions qui comptent pour votre activité, voyez quelles marques chaque réponse mentionne et quelles sources elle cite, puis travaillez sur les manques.
Offre gratuite avec 120 crédits initiaux • Sans carte bancaire
Autres articles
AI Overviews en France : ce que Google cite vraiment, face aux États-Unis
Qwairy et Converteo ont analysé 12 120 réponses AI Overviews en France et aux États-Unis : requêtes déclenchantes, sources citées, autorité et volatilité.
Questions de suivi IA : la première réponse n’est pas la décision
72 % des réponses IA invitent à poser une autre question, et la présélection se rebat quand l’acheteur répond. Le benchmark Qwairy montre ce que décide ce tour.