Loading page

Claude puise dans son entraînement, le web en direct et des outils. Découvrez comment il choisit ses sources, comment devenir citable et mesurer vos citations.
Claude est discrètement devenu l’un des moyens les plus influents de se renseigner, de décider et d’acheter. Quand quelqu’un demande à Claude de comparer des outils, d’expliquer une catégorie ou de recommander un fournisseur, les marques qu’il nomme et les sources vers lesquelles il renvoie façonnent la présélection bien avant qu’un humain n’ouvre un moteur de recherche. Être cité par Claude n’est pas la même chose qu’être bien classé sur Google. Claude compose ses réponses à partir d’un mélange de ce qu’il a appris à l’entraînement, de ce qu’il récupère sur le web en direct et de ce que vous lui fournissez par des outils. Chacune de ces voies obéit à ses propres règles, et optimiser pour l’une n’apporte presque rien aux autres. La bonne nouvelle, c’est que les leviers sont concrets. Une fois que vous comprenez comment Claude construit une réponse et d’où viennent réellement ses citations, vous pouvez faire de votre contenu ce vers quoi il se tourne. Ce guide détaille comment Claude s’approvisionne en informations et les cite, ce qu’il tend à mettre en avant, les tactiques qui font la différence, et comment mesurer si tout cela fonctionne.
Claude répond à partir de trois sources distinctes, et « être cité » signifie autre chose dans chacune.
Être « cité par Claude » signifie le plus souvent apparaître comme source avec lien dans une réponse ancrée dans le web. Mais la position la plus solide consiste à être présent dans les trois couches à la fois : connu à l’entraînement, récupérable sur le web en direct et facile à faire remonter par des outils.
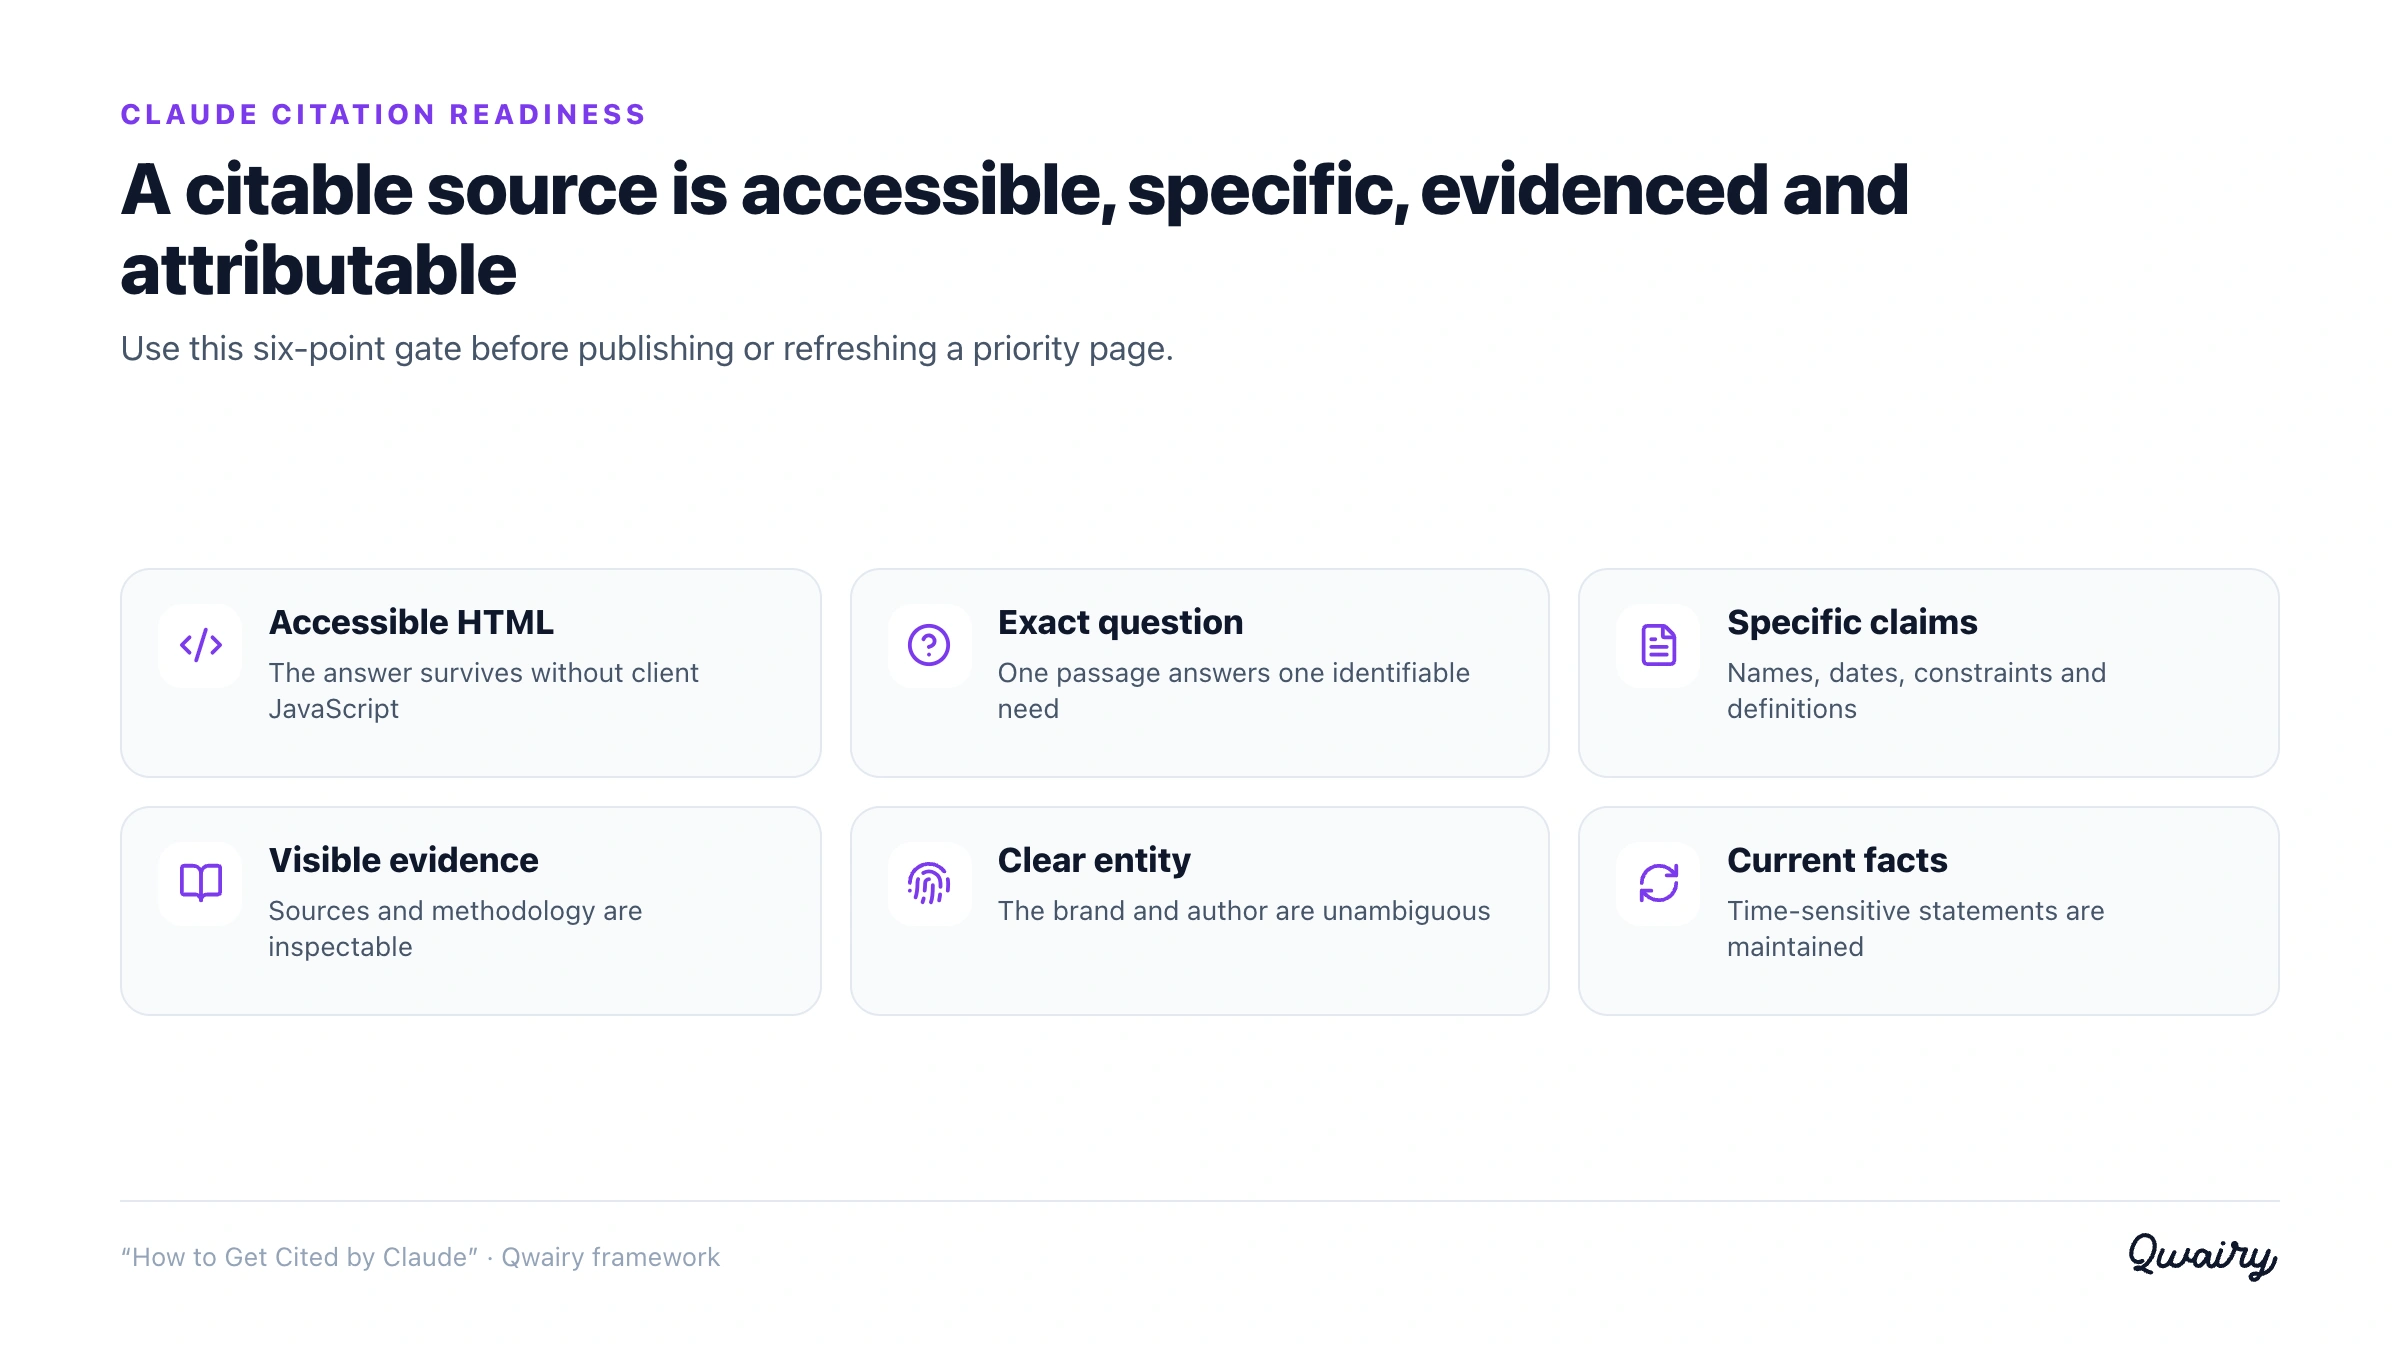
Claude privilégie les sources qui sont clairement la meilleure réponse, la plus vérifiable, à la question exacte posée, et pas seulement la page la mieux classée. Les moteurs de réponse IA récupèrent de nombreuses pages mais n’en citent que quelques-unes ; la visibilité dépend donc d’être sélectionné, et pas seulement d’être trouvé. La recherche fondatrice en la matière, GEO : Generative Engine Optimization (Aggarwal et al., d’abord publiée sur arXiv en 2023 et présentée à l’ACM SIGKDD 2024), a montré que l’ajout de citations de sources, de citations textuelles et de statistiques à une page augmentait de façon mesurable la fréquence à laquelle les moteurs génératifs la mettaient en avant, parfois dans de fortes proportions. Le constat large et reproductible d’une étude à l’autre est que la pertinence thématique et le fait d’être récupéré dans le contexte du modèle sont les premiers moteurs de la citation : la seule autorité de domaine compte moins ici qu’en SEO classique. En pratique, Claude se tourne vers des contenus qui sont :
Optimiser pour Claude consiste moins à tromper un algorithme de classement qu’à être réellement, sans ambiguïté, la meilleure réponse, et à rendre cette réponse facile à lire, à vérifier et à récupérer.
Cartographiez les vraies questions que vos acheteurs posent à Claude, puis construisez une page qui répond à chacune de front. Ouvrez par une réponse directe, citable, dès les premières phrases de la section concernée, et étayez-la avec du concret. Claude récompense les pages qui résolvent entièrement la question plutôt que celles qui tournent autour.
## et ### qui reprennent la manière dont les gens formulent leurs questions.La couche d’entraînement de Claude est celle où se trouve la mémoire de marque à long terme. Établissez votre marque comme une entité claire et cohérente : un nom et une description cohérents partout où elle apparaît, des pages « à propos » et produit faisant autorité, des signatures d’auteurs avec leurs qualifications, et des données structurées (Organization, Article, FAQPage) pour que les machines puissent vous désambiguïser. Une présence cohérente sur des sources tierces réputées est ce qui amène Claude à associer votre marque à votre catégorie.
Lancez un audit gratuit : en quelques minutes, ChatGPT, Gemini et Perplexity répondent en direct à 8 questions d’achat sur votre marché, et vous voyez qui ils recommandent.
Ce que d’autres sites crédibles disent de vous compte souvent plus que ce que vous dites de vous-même. Les avis indépendants, les publications sectorielles, les communautés bien modérées et les pages de référence alimentent à la fois les données d’entraînement et la récupération en direct. Être référencé comme source ailleurs est l’un des signaux les plus forts qui montrent que vous méritez d’être cité.
Pour toute question dont la réponse évolue, la fraîcheur est un facteur de classement dans la récupération. Mettez à jour vos pages piliers, datez-les honnêtement et retirez les affirmations périmées. Une page exacte il y a deux ans peut être discrètement écartée au profit d’un concurrent plus récent.
C’est le socle technique que beaucoup de marques négligent. La documentation officielle d’Anthropic définit trois bots contrôlables indépendamment :
Claude-SearchBot indexe le contenu pour améliorer les résultats de recherche de Claude. Le bloquer peut réduire votre visibilité et la précision des réponses de recherche de Claude.Claude-User récupère des pages en réponse à la demande d’un utilisateur. Le bloquer peut empêcher Claude d’aller chercher votre contenu pour la recherche web demandée par l’utilisateur.ClaudeBot collecte du contenu du web public pouvant contribuer au développement des modèles. Le bloquer signale que les contenus futurs doivent être exclus des jeux de données d’entraînement d’Anthropic.Bloquer ClaudeBot ne bloque pas automatiquement Claude-SearchBot ni Claude-User. Pour les marques qui veulent des citations sans donner accès à l’entraînement, autorisez les deux agents de récupération et prenez une décision de politique distincte pour le bot d’entraînement. Anthropic indique que ses bots respectent le fichier robots.txt et prend en charge Crawl-delay pour maîtriser le débit.
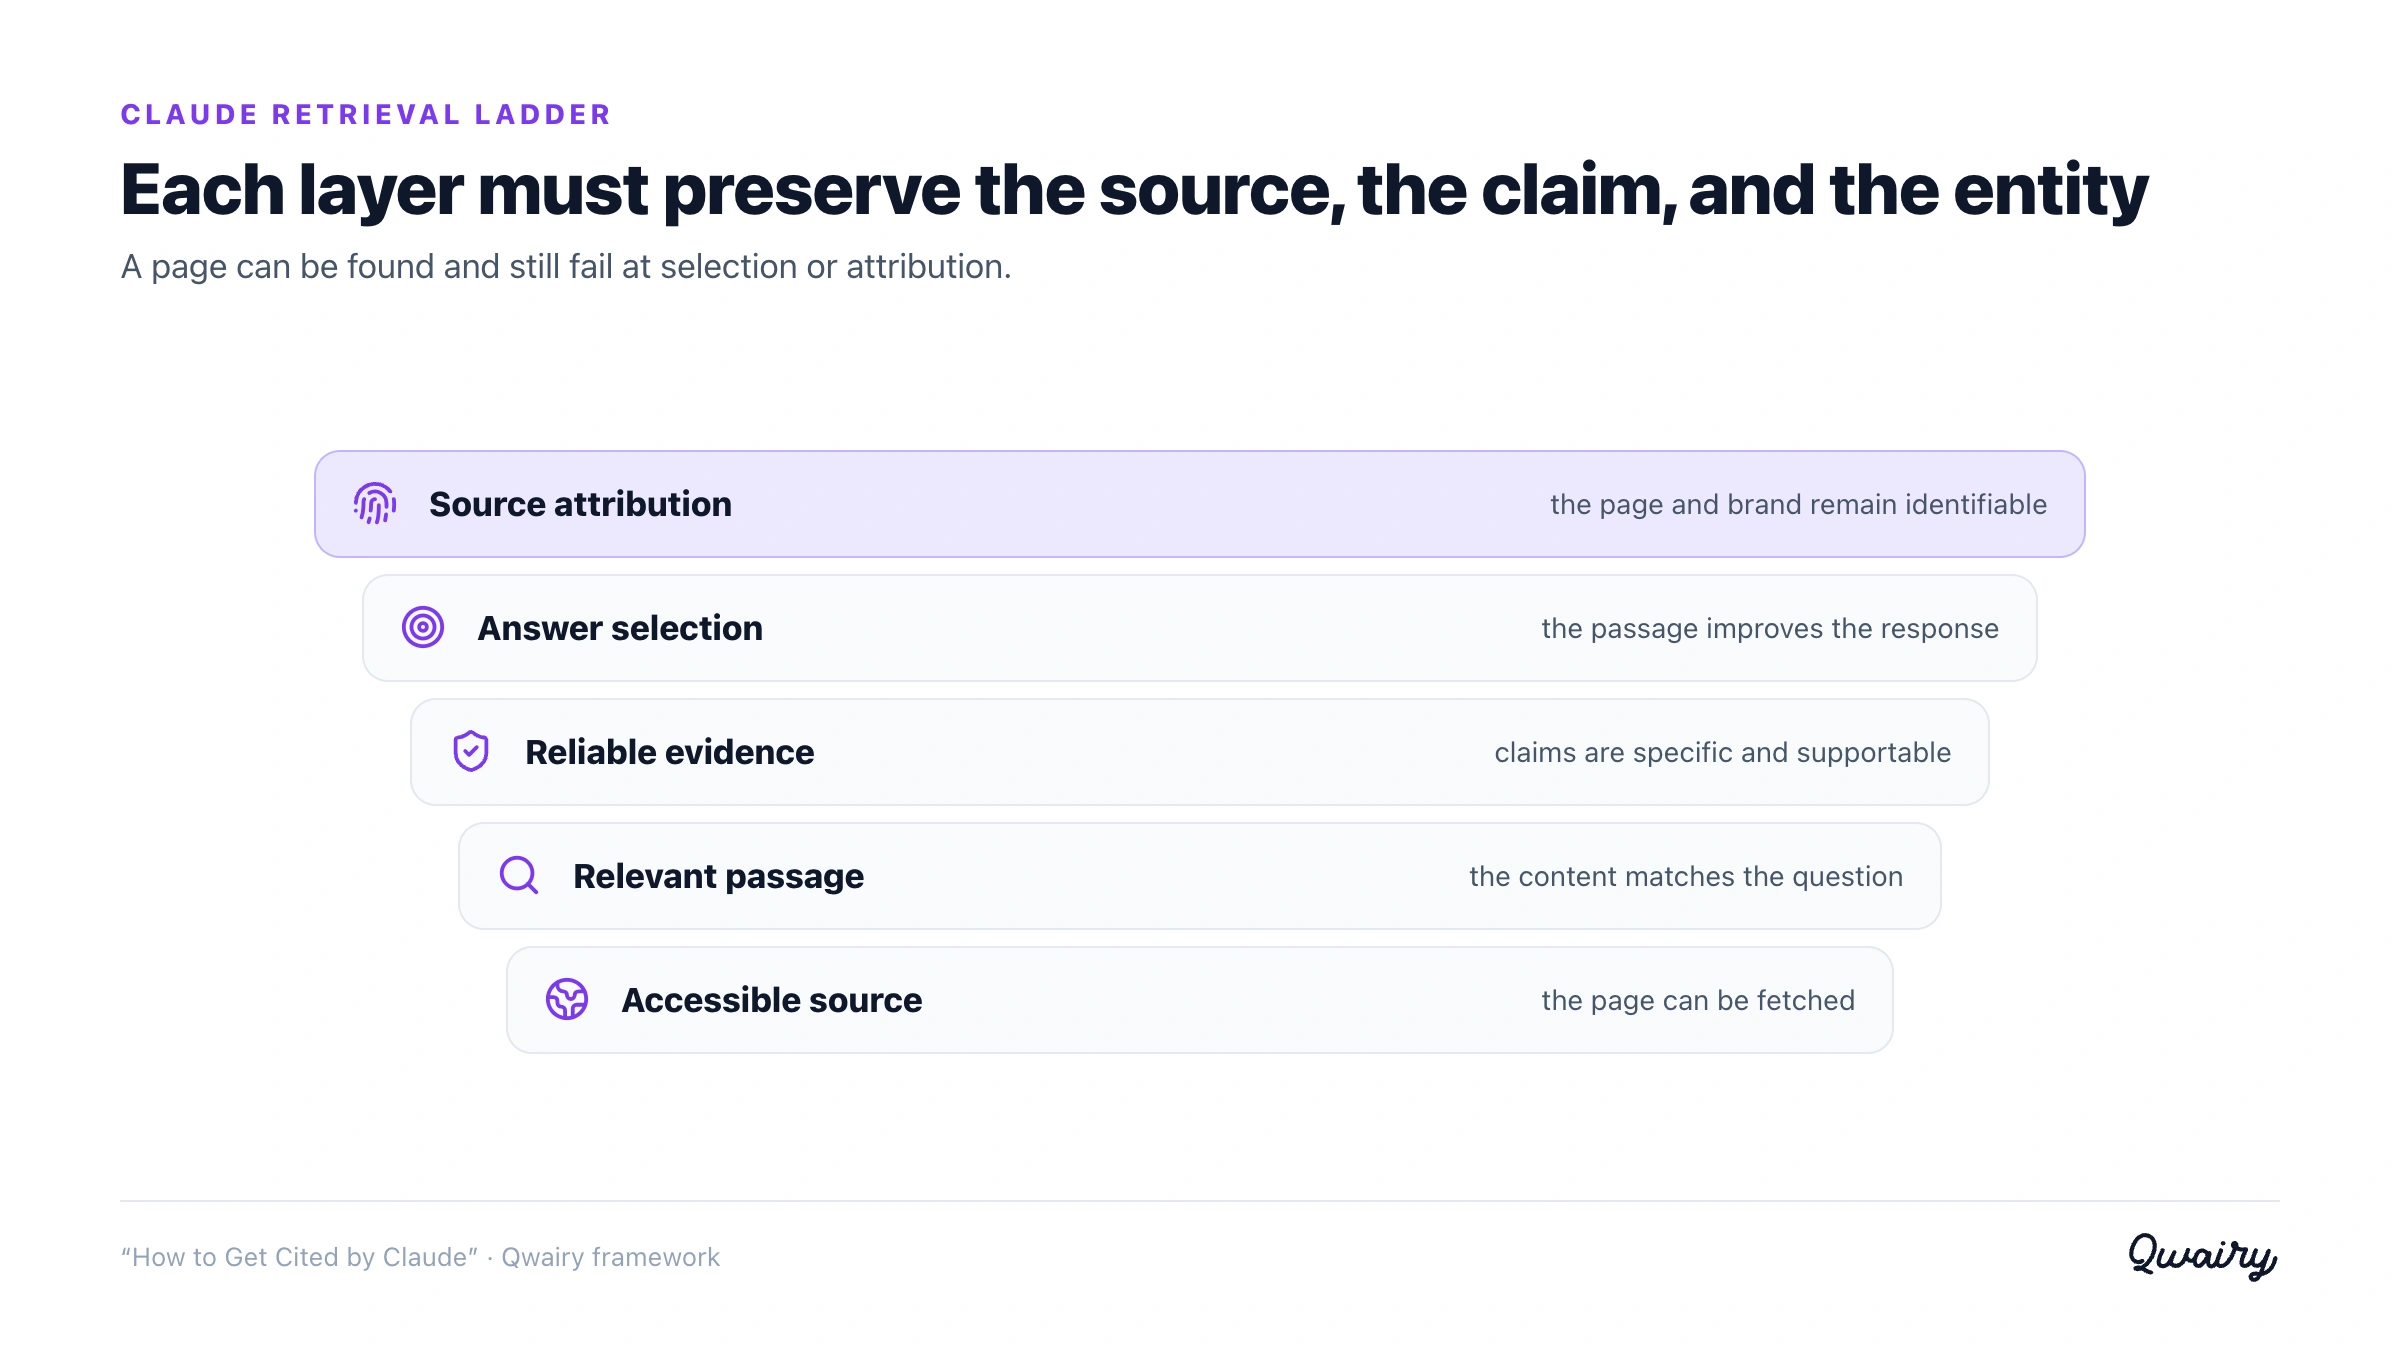
Claude-SearchBot et Claude-User ont-ils accès au site dans robots.txt ?ClaudeBot ?La visibilité dans Claude échoue par couches. Diagnostiquez d’abord la couche la plus basse en panne, car le travail effectué plus haut dans l’échelle ne peut pas compenser une défaillance en dessous.
Niveau | Question | Condition de réussite |
1. Découverte par la recherche | Claude-SearchBot peut-il découvrir et indexer la page ? | Le bot est autorisé, reçoit une réponse réussie et atteint le contenu canonique. |
2. Récupération par l’utilisateur | Claude-User peut-il récupérer la page quand un utilisateur le demande ? | La page est accessible sans authentification, sans boucle de vérification anti-bot ni contenu disponible uniquement côté client. |
3. Extraction du passage | Une seule section peut-elle répondre seule à la question cible ? | Le passage copié conserve la réponse, les entités, les preuves et la réserve nécessaire. |
4. Confiance dans la source | La page est-elle plus sûre à citer que les sources concurrentes ? | Les affirmations sont sourcées, l’auteur est clairement identifié, les dates sont honnêtes et l’incertitude est explicite. |
5. Attribution reproductible | Claude cite-t-il la bonne URL et la bonne marque d’un test à l’autre ? | La citation revient sur l’ensemble des prompts suivis, sans confusion d’entité. |
Une page au niveau 3 est lisible, mais pas forcément digne de confiance. Une page au niveau 4 est crédible, mais pas forcément récupérée pour les bons prompts. Le niveau 5 est la cible opérationnelle : une attribution reproductible, mesurée dans le temps, avec la même entité et la même URL canonique. Notez le premier niveau en échec pour chaque page prioritaire. Ce champ unique rend la remédiation évidente : configuration des crawlers, rendu, réécriture du passage, preuves ou correction d’entité.
Chaque opportunité de contenu est notée selon son potentiel IA, l’écart de marque, les sources manquantes et l’impact business, pour commencer là où ça compte.
On n’optimise pas ce que l’on ne voit pas, et Claude ne fournit aucun tableau de bord des marques qu’il nomme. Comme les réponses varient selon la formulation, le modèle et le moment, tester soi-même quelques prompts est peu fiable et non reproductible. C’est précisément le manque que comble Qwairy. Il suit la façon dont votre marque apparaît sur les principaux moteurs IA, Claude compris, en mesurant la fréquence de vos mentions, lesquelles de vos URL sont reprises comme sources, votre position face aux concurrents sur la part de citations, et le sentiment associé à votre marque dans les réponses IA. « Sommes-nous dans les réponses de Claude ? » devient ainsi un indicateur dont vous suivez la tendance et que vous pouvez relier au travail éditorial et aux relations presse. Pour les équipes qui construisent par-dessus, un serveur MCP pensé pour les agents met les mêmes données directement à la disposition des agents IA. Pour le panorama complet sur tous les moteurs, le blog de Qwairy couvre l’ensemble du paysage GEO et AEO. Mesurez, livrez une amélioration, puis observez si votre part de citations bouge. Cette boucle de rétroaction, et non les suppositions, est ce qui fait cumuler les gains.
Prolongez le guide Claude : appliquez le cadre de citation multi-moteurs, configurez l’accès d’Anthropic avec le guide des crawlers IA et renforcez la reconnaissance grâce au SEO d’entité pour l’IA.
Être cité par Claude revient à trois choses : être connu (présent et cohérent dans les données d’entraînement), être récupérable (explorable, à jour et structuré pour le web en direct) et être la meilleure réponse (directement pertinent, vérifiable et citable). Si vous maîtrisez ces trois points, Claude a toutes les raisons de se tourner vers vous. Mesurez ensuite sans relâche : dans un domaine aussi récent, les marques qui traitent la visibilité IA comme une discipline suivie et itérée prendront régulièrement l’avantage sur celles qui devinent encore.
Pas directement. ClaudeBot gère la collecte des données d’entraînement, tandis que les citations en direct dans les réponses ancrées dans le web passent par Claude-SearchBot et Claude-User, qui se contrôlent séparément. Bloquer ClaudeBot retire seulement votre contenu des jeux de données d’entraînement potentiels : vous pouvez toujours être récupéré et cité en direct, tant que les bots de recherche et de récupération utilisateur y ont accès.
Les principes de base (être pertinent, structuré, faisant autorité et à jour) valent pour tous, mais le comportement de récupération diffère. Perplexity tend à citer de nombreuses sources par réponse, ChatGPT moins, et Claude a ses propres crawlers et son propre mélange de connaissances entraînées et de recherche en direct. Concrètement, optimisez une fois les fondamentaux, puis mesurez chaque moteur séparément, car la part de citations est rarement la même de l’un à l’autre.
Anthropic n’a pas publié tous les détails du backend de récupération de Claude, et il exploite son propre Claude-SearchBot pour l’indexation, ce qui laisse penser à une couche de récupération distincte plutôt qu’à une dépendance directe envers Google. L’hypothèse prudente est qu’un bon socle SEO aide sans suffire : il faut aussi être explorable et citable par les bots spécifiques de Claude.
Pour la récupération web en direct, les changements peuvent apparaître assez vite dès que Claude-SearchBot et Claude-User peuvent atteindre les pages mises à jour. Influencer la couche d’entraînement est beaucoup plus lent et lié aux cycles de mise à jour des modèles : les gains de reconnaissance de marque s’accumulent donc sur des mois. Voyez l’optimisation de la récupération en direct comme la voie rapide, et la construction d’entité comme le long terme.
Oui : robots.txt permet d’autoriser ou d’interdire chaque crawler d’Anthropic indépendamment, et des règles par chemin permettent d’exposer les pages que vous voulez voir citées tout en limitant les autres. Gardez vos pages les plus précieuses et les plus prêtes à répondre ouvertes à Claude-SearchBot et à Claude-User. N’oubliez pas que bloquer un bot retire la visibilité associée, et pas seulement l’exploration.
Les données structurées ne sont pas une obligation, mais elles aident Claude à analyser et à désambiguïser votre contenu et votre entité de marque, ce qui favorise la sélection. Les balisages Organization, Article et FAQPage sont des points de départ raisonnables. Donnez d’abord la priorité à un contenu réellement clair et extractible ; considérez le schema comme un amplificateur, pas comme un substitut.
Suivez les questions qui comptent pour votre activité, voyez quelles marques chaque réponse mentionne et quelles sources elle cite, puis travaillez sur les manques.
Offre gratuite avec 120 crédits initiaux • Sans carte bancaire
Autres articles
How to Improve Your Brand Sentiment in ChatGPT and AI Search
Being mentioned by ChatGPT is not enough if it calls your products overpriced. A step-by-step process to analyze and improve how AI assistants talk about your brand, with Nike as an example.
Stratégie GEO : 5 vérités sur la recherche IA et un cadre en 4 étapes
Cinq vérités sur la recherche IA partagées au SEO & GEO Summit de Paris, et le cadre GEO en 4 étapes de Qwairy pour être recommandé par ChatGPT ou Gemini.