Loading page

Tous les crawlers IA n’ont pas le même rôle. Voyez lesquels autoriser ou bloquer dans robots.txt (GPTBot, ClaudeBot, PerplexityBot) sans sortir des réponses IA.
Une nouvelle catégorie de crawlers visite votre site, et elle ne se comporte pas comme Googlebot. GPTBot, ClaudeBot, PerplexityBot, OAI-SearchBot et une dizaine d’autres demandent désormais vos pages chaque jour : certains pour entraîner des modèles, d’autres pour construire les index en direct que citent les moteurs de réponse IA, d’autres encore pour récupérer une seule URL parce qu’un utilisateur vient de poser une question.
Votre fichier robots.txt est la porte d’entrée de tous ces bots. Or le réflexe habituel, « bloquons les bots IA, ils volent mon contenu », est une décision aux conséquences bien réelles. Bloquez le mauvais crawler et vous ne protégez pas seulement votre contenu : vous pouvez réduire fortement la capacité de ChatGPT, de Perplexity ou de Gemini à récupérer et citer vos pages, même si l’effet exact varie selon le moteur et le chemin de découverte.
Le problème, c’est que « crawler IA » ne désigne pas une seule réalité. Les crawlers d’entraînement, les crawlers de récupération (retrieval) et les agents déclenchés par l’utilisateur font des métiers complètement différents, et bloquer chacun d’eux ne vous coûte pas la même chose. Les traiter comme un seul groupe, c’est ainsi que des sites sacrifient sans le vouloir leur visibilité dans l’IA pour faire passer un message sur les données d’entraînement.
Ce guide passe en revue les principaux user-agents IA et ce que chacun fait réellement, l’arbitrage concret entre autoriser et bloquer (plus nuancé que ne l’admettent la plupart des articles du type « tout bloquer »), un robots.txt à copier-coller pour deux stratégies courantes, et la manière de voir quels crawlers vous visitent vraiment. L’objectif : faire un choix délibéré, pas un choix réflexe.
robots.txt** est un fichier d’instructions volontaire, pas un contrôle de sécurité.** Il se trouve à la racine de votre domaine (example.com/robots.txt) et indique aux crawlers respectueux quels chemins ils peuvent ou non demander. Le format est simple : une ligne User-agent qui nomme un crawler, suivie de règles Allow et Disallow. Le protocole d’exclusion des robots a été normalisé officiellement en 2022 dans la RFC 9309 .
Trois points sont faciles à oublier et pèsent énormément ici :
Disallow aujourd’hui n’y change rien. robots.txt encadre les requêtes futures, pas l’entraînement passé.robots.txt.Google-Extended et Applebot-Extended ne récupèrent rien. Ce sont des étiquettes de refus que vous placez dans robots.txt pour contrôler la façon dont les données d’un crawler existant sont utilisées. Les bloquer modifie les droits d’usage, pas l’accès à l’exploration.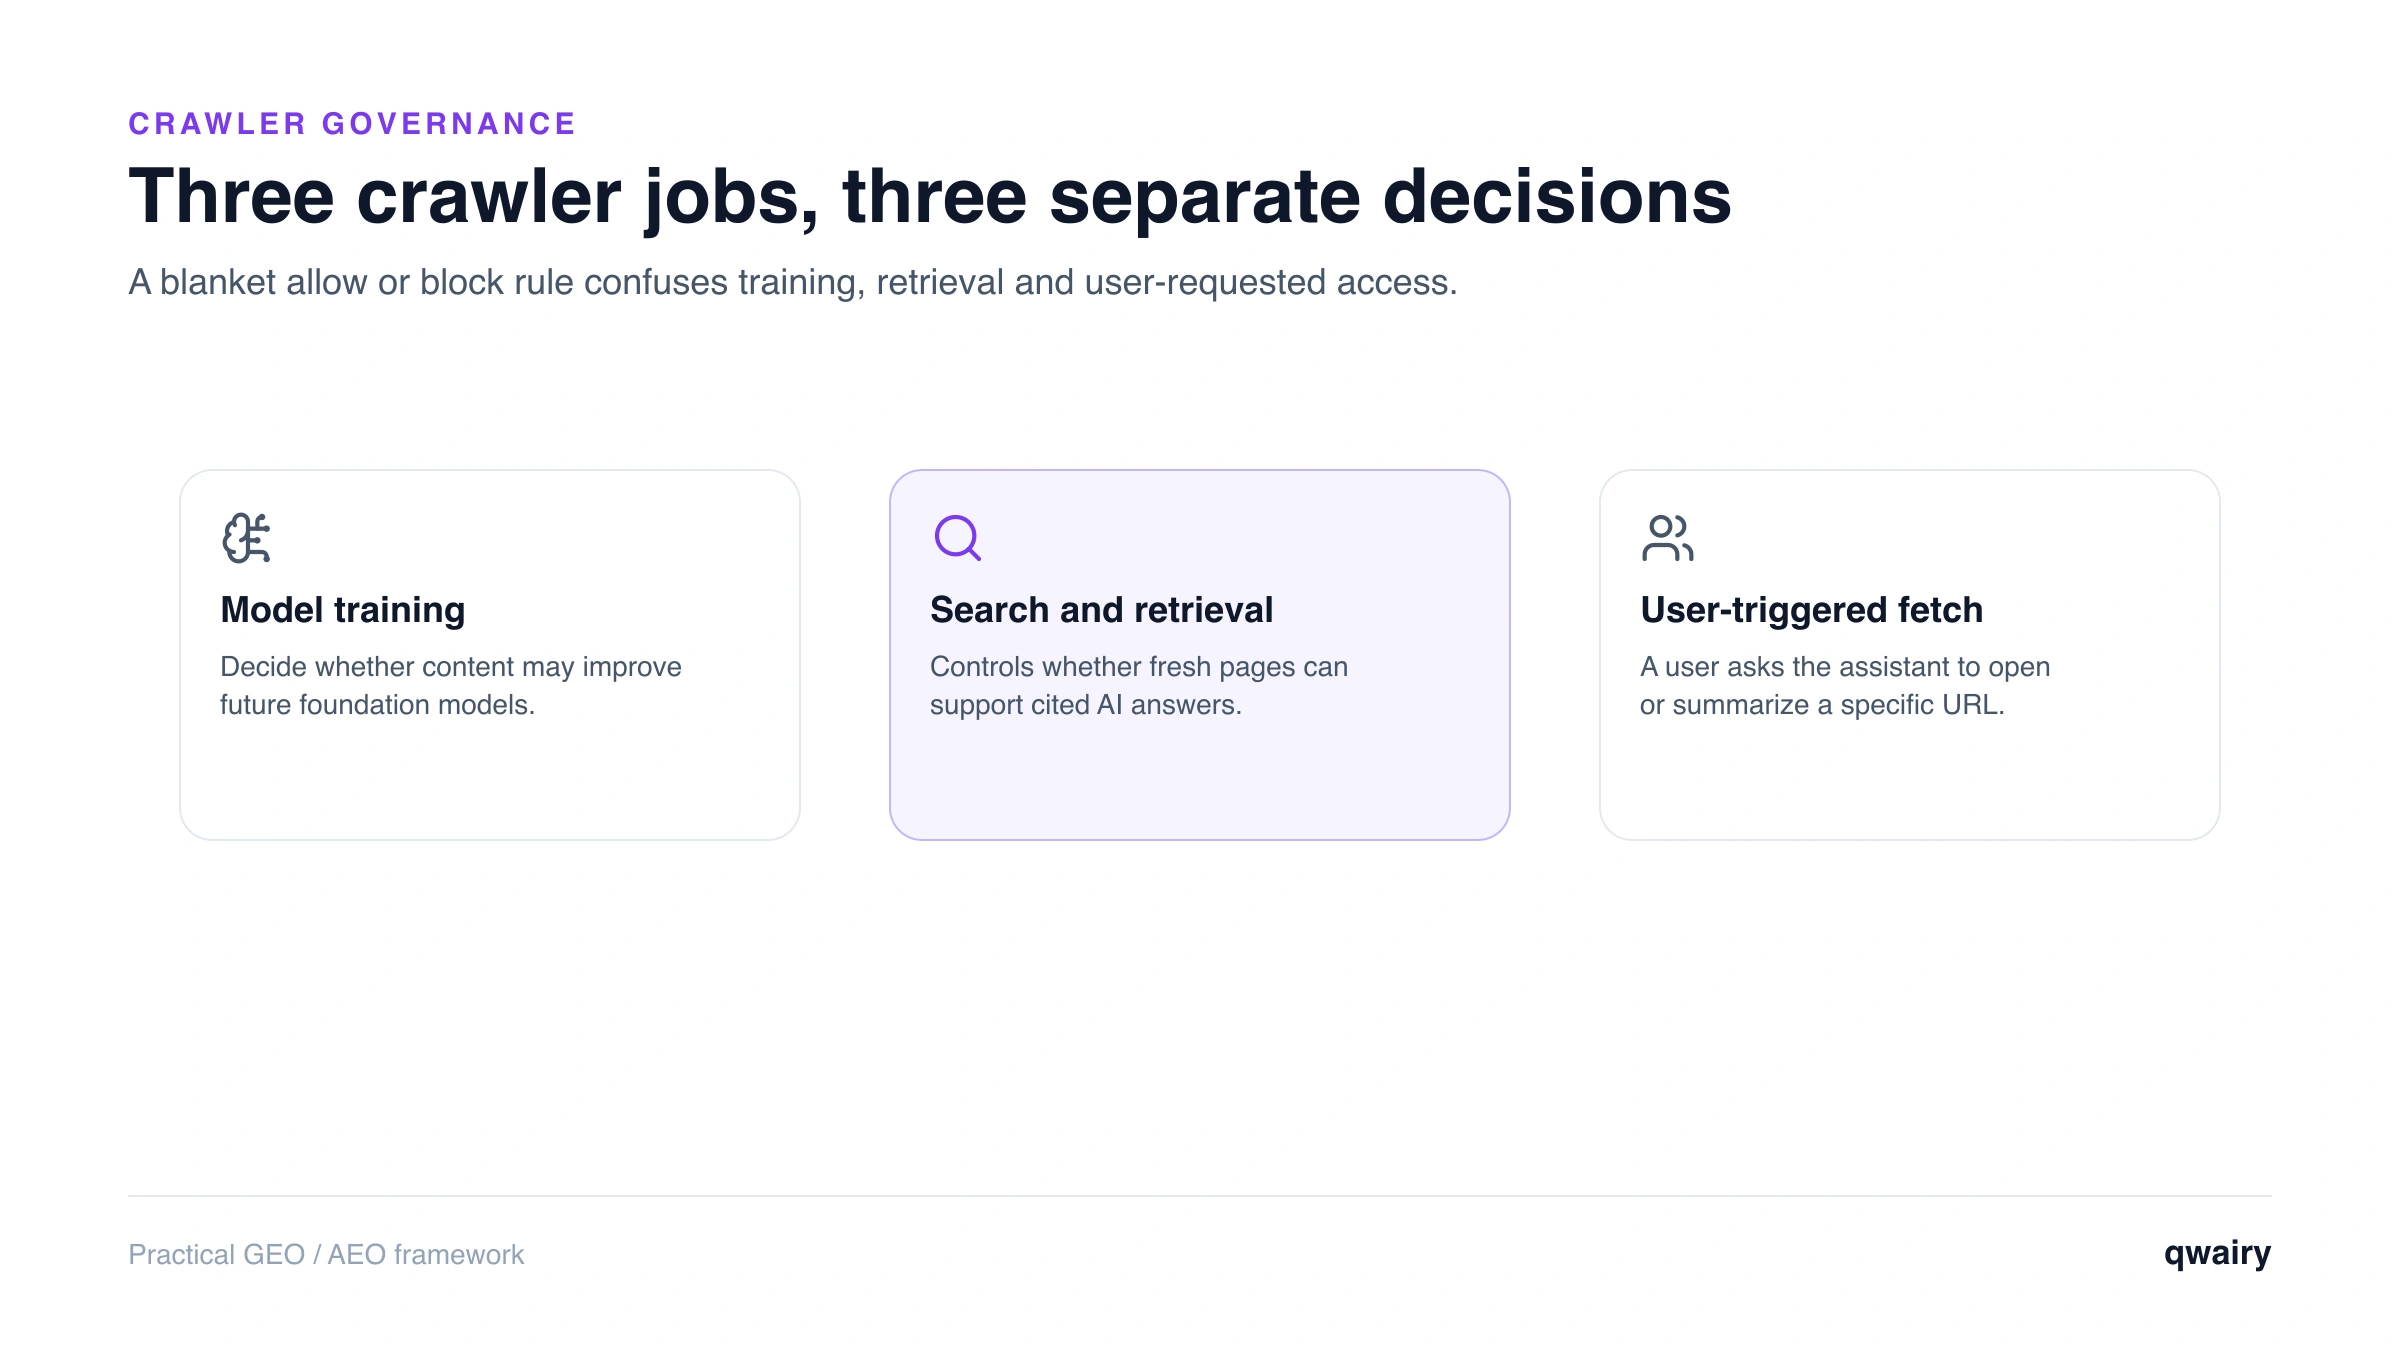
Avant d’autoriser ou de bloquer quoi que ce soit, rangez chaque crawler dans l’une des trois catégories. Cette distinction commande à elle seule tout l’arbitrage.
Rôle | Ce qu’il fait | Ce que vous coûte son blocage |
Entraînement | Collecte du contenu pour entraîner les futures versions des modèles. Alimente la mémoire « paramétrique » du modèle. | Votre contenu n’est pas utilisé pour entraîner le prochain modèle. L’effet sur le fait d’être *cité* est indirect et incertain. |
Récupération / indexation de recherche | Construit l’index en direct qu’un moteur de réponse interroge au moment de la requête, puis cite avec un lien. | Peut retirer des pages de l’index de récupération en direct de ce moteur et réduire fortement l’éligibilité à la citation ; l’effet exact varie selon la plateforme et les autres sources de découverte. |
Requête déclenchée par l’utilisateur | Récupère une page précise en temps réel parce qu’un utilisateur a interrogé l’assistant à son sujet ou a cliqué sur un lien. | L’assistant peut ne pas pouvoir ouvrir votre page pour le compte d’un utilisateur, ce qui réduit la visibilité à la demande, à forte intention. Certains agents déclenchés par l’utilisateur, dont `Perplexity-User`, ignorent en général `robots.txt`. |
Ce qu’il faut retenir : bloquer les crawlers d’entraînement est une décision de contenu et de droits ; bloquer les crawlers de récupération et ceux déclenchés par l’utilisateur est une décision de visibilité. On confond les deux, on bloque tout, et on perd une visibilité que l’on voulait pourtant garder.
Voici les user-agents qui comptent, regroupés par opérateur. Les noms sont à jour à la mi-2026 ; cette liste évolue, alors prenez-la comme un point de départ et vérifiez-la dans la documentation de chaque éditeur.
OpenAI exploite trois crawlers distincts , chacun pouvant être contrôlé indépendamment dans robots.txt :
GPTBot : entraînement. Explore le contenu public pour entraîner les futurs modèles GPT.OAI-SearchBot : récupération. Construit l’index qui alimente la recherche de ChatGPT, afin que votre site puisse apparaître et être lié dans les réponses de ChatGPT. Ce n’est pas un crawler d’entraînement.ChatGPT-User : déclenché par l’utilisateur. Récupère une page à la suite d’une action précise d’un utilisateur, sans explorer automatiquement. OpenAI indique qu’il n’est pas utilisé pour une exploration web large et automatique.Ce que cela change en pratique : vous pouvez autoriser l’inclusion dans la recherche IA (OAI-SearchBot) tout en bloquant l’entraînement (GPTBot). Ce sont deux lignes distinctes.
Un détail contre-intuitif à connaître : bloquer OAI-SearchBot ne garantit pas que vous disparaissiez de ChatGPT. OpenAI précise qu’une URL et un titre de page obtenus auprès d’un autre fournisseur de recherche peuvent quand même s’afficher. Si votre but est une véritable exclusion plutôt qu’une exploration réduite, la recommandation d’OpenAI est d’autoriser le crawler à lire la page et d’utiliser une directive noindex. Bloquer le seul crawler cumule le pire des deux mondes : aucune citation, et aucun contrôle sur ce qui est affiché.
Anthropic exploite aussi trois bots et affirme que les trois respectent robots.txt :
ClaudeBot : entraînement. Télécharge des données pour entraîner les modèles de Claude.Claude-SearchBot : récupération. Indexe et parcourt le web pour améliorer les résultats de recherche de Claude.Claude-User : déclenché par l’utilisateur. Accède à une page lorsqu’un utilisateur de Claude pose une question qui en a besoin.D’anciens tokens d’Anthropic comme anthropic-ai et Claude-Web sont apparus par le passé ; les trois ci-dessus forment l’ensemble documenté actuel. Tous les trois respectent les règles robots.txt standard et prennent en charge Crawl-delay, et les règles s’appliquent séparément à chaque nom d’hôte ou sous-domaine : une règle sur votre domaine racine ne couvre donc pas votre documentation ni votre sous-domaine de blog.
Perplexity documente deux agents :
PerplexityBot : récupération et indexation de recherche. Construit l’index auquel Perplexity se réfère et vers lequel il pointe. Perplexity indique qu’il n’est pas utilisé pour entraîner des modèles de fondation.Perplexity-User : déclenché par l’utilisateur. Visite une page précise à la suite d’une demande d’un utilisateur. Perplexity soutient qu’il s’agit d’« un agent, pas d’un bot », et qu’il n’est donc pas soumis à robots.txt.Perplexity est aussi l’exemple qui met en garde contre la confiance accordée à robots.txt seul : le 4 août 2025, Cloudflare a documenté des tests au cours desquels Perplexity a utilisé un crawler non déclaré, un user-agent de navigateur générique, des IP tournantes et plusieurs ASN après le blocage de ses crawlers déclarés. Si vous devez vraiment appliquer un blocage, combinez robots.txt avec des contrôles de bots vérifiés au niveau du CDN ou du WAF.
Googlebot : le crawler de recherche classique. Il sous-tend aussi AI Overviews et AI Mode, qui reposent sur l’index de Google Search. Bloquez Googlebot et vous sortez de Search et de ses surfaces IA.Google-Extended : un token robots.txt (et non un crawler) pour refuser que votre contenu serve à entraîner et à ancrer les modèles génératifs de Google (Gemini/Vertex AI). Point crucial : Google précise que cela n’affecte pas votre classement ni votre inclusion dans Google Search. Comme AI Overviews puise dans l’index de Search via Googlebot, bloquer Google-Extended est une décision sur l’usage pour l’entraînement, pas un moyen de sortir d’AI Overviews.Bingbot : le crawler de recherche de Bing. Microsoft Copilot s’appuie en grande partie sur l’index de Bing, si bien que le SEO Bing et l’explorabilité nourrissent la visibilité dans Copilot. Il n’existe pas de moyen simple et largement documenté de refuser l’ancrage de Copilot indépendamment de l’indexation Bing.CCBot : Common Crawl . Il n’alimente pas un assistant en particulier, mais son corpus ouvert a servi de données d’entraînement à de nombreux LLM. Le bloquer limite l’une des voies d’entraînement les plus courantes.Applebot / Applebot-Extended : respectivement le crawler de recherche d’Apple et son token de refus de l’entraînement.Meta-ExternalAgent, Amazonbot, Bytespider (ByteDance), cohere-ai et d’autres complètent la liste. Bytespider en particulier est souvent bloqué pour son exploration agressive.Lancez un audit gratuit : en quelques minutes, ChatGPT, Gemini et Perplexity répondent en direct à 8 questions d’achat sur votre marché, et vous voyez qui ils recommandent.
Il n’existe pas de réponse unique, mais il existe une mauvaise façon de décider : traiter tous les crawlers IA comme identiques. Voici comment l’arbitrage se décompose selon chaque catégorie.
GPTBot, ClaudeBot, CCBot, Google-Extended). C’est avant tout une décision de droits et de principe : voulez-vous que votre contenu figure dans le jeu d’entraînement du prochain modèle ? Le coût en visibilité est réel mais indirect et incertain. Figurer dans les données d’entraînement est une façon pour un modèle de « connaître » votre marque, mais le lien entre l’inclusion à l’entraînement et le fait d’être mis en avant ou cité reste flou, et les modèles répondent de plus en plus en récupérant des sources en direct plutôt qu’en récitant un texte mémorisé. Si votre priorité est de protéger un contenu propriétaire ou premium, bloquer ici se défend et vous coûte peu en citations au quotidien.OAI-SearchBot, PerplexityBot, Claude-SearchBot, Googlebot, Bingbot). C’est là que le blocage fait le plus mal en général. Ces crawlers construisent les index que les moteurs de réponse interrogent quand un utilisateur pose une question, et ces moteurs citent ce qu’ils récupèrent. Les bloquer supprime l’une des principales voies de découverte de vos pages et peut réduire fortement l’éligibilité à la citation, même si certaines plateformes peuvent encore afficher une URL ou un titre via un autre fournisseur. Pour presque toute marque qui veut de la visibilité dans l’IA, ces crawlers doivent rester autorisés.ChatGPT-User, Claude-User, Perplexity-User). Ils se déclenchent à des moments réels et à forte intention, lorsqu’un utilisateur interroge explicitement l’assistant à votre sujet ou au sujet d’une page. Bloquer les agents respectueux peut empêcher l’assistant d’ouvrir votre page pour cette demande. Notez que Perplexity documente que Perplexity-User ignore en général robots.txt : une application stricte exige donc des contrôles WAF ou CDN vérifiés.Deux réalités supplémentaires à garder en tête :
Disallow ne vous effacera pas des modèles entraînés sur ces données.robots.txt** est une demande, pas un mur.** Les crawlers respectueux obéissent ; l’épisode Perplexity montre que ce n’est pas le cas de tous. Un vrai blocage passe par des contrôles en périphérie ou par un WAF (de nombreux CDN proposent désormais un blocage des bots IA en un clic).Le bon modèle mental : décidez de l’accès à l’entraînement comme une question de droits sur le contenu, et de l’accès à la récupération et aux requêtes déclenchées par l’utilisateur comme une question de visibilité. Répondez-y séparément.
Passez votre objectif au crible de ces questions, dans l’ordre :
-Extended, mais laissez autorisés les crawlers de récupération et ceux déclenchés par l’utilisateur pour pouvoir toujours être cité.robots.txt) et négociez l’accès de façon délibérée. Sachez que vous échangez de la découverte contre du contrôle.Disallow sur ces chemins pour tous les crawlers, quelle que soit la réponse aux questions précédentes, IA ou non.Stratégie A : maximiser la visibilité dans l’IA, refuser uniquement l’entraînement. Les agents de récupération et ceux déclenchés par l’utilisateur restent les bienvenus ; les crawlers d’entraînement et les tokens d’entraînement sont bloqués.
# --- Autoriser les crawlers de recherche et de récupération IA (conserver les citations IA) ---
User-agent: OAI-SearchBot
Allow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /

# --- Autoriser les agents déclenchés par l’utilisateur ---
User-agent: ChatGPT-User
Allow: /

User-agent: Claude-User
Allow: /

User-agent: Perplexity-User
Allow: /

# --- Refuser l’entraînement des modèles ---
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: CCBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: Applebot-Extended
Disallow: /
Stratégie B : bloquer largement les crawlers IA. N’utilisez-la que si vous acceptez de réduire sensiblement votre visibilité dans les réponses IA. Elle n’arrêtera pas les agents qui ignorent robots.txt ; associez-la à des contrôles WAF ou CDN vérifiés si l’objectif est une application stricte.
User-agent: GPTBot
Disallow: /

User-agent: OAI-SearchBot
Disallow: /

User-agent: ChatGPT-User
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Claude-SearchBot
Disallow: /

User-agent: Claude-User
Disallow: /

User-agent: PerplexityBot
Disallow: /

User-agent: CCBot
Disallow: /

User-agent: Google-Extended
Disallow: /
Remarque : conservez vos règles User-agent : Googlebot et Bingbot existantes en mode permissif si vous voulez une présence dans Search ou dans AI Overviews/Copilot : ce sont vos bouées de sauvetage en recherche organique, pas seulement des surfaces IA.
Chaque opportunité de contenu est notée selon son potentiel IA, l’écart de marque, les sources manquantes et l’impact business, pour commencer là où ça compte.
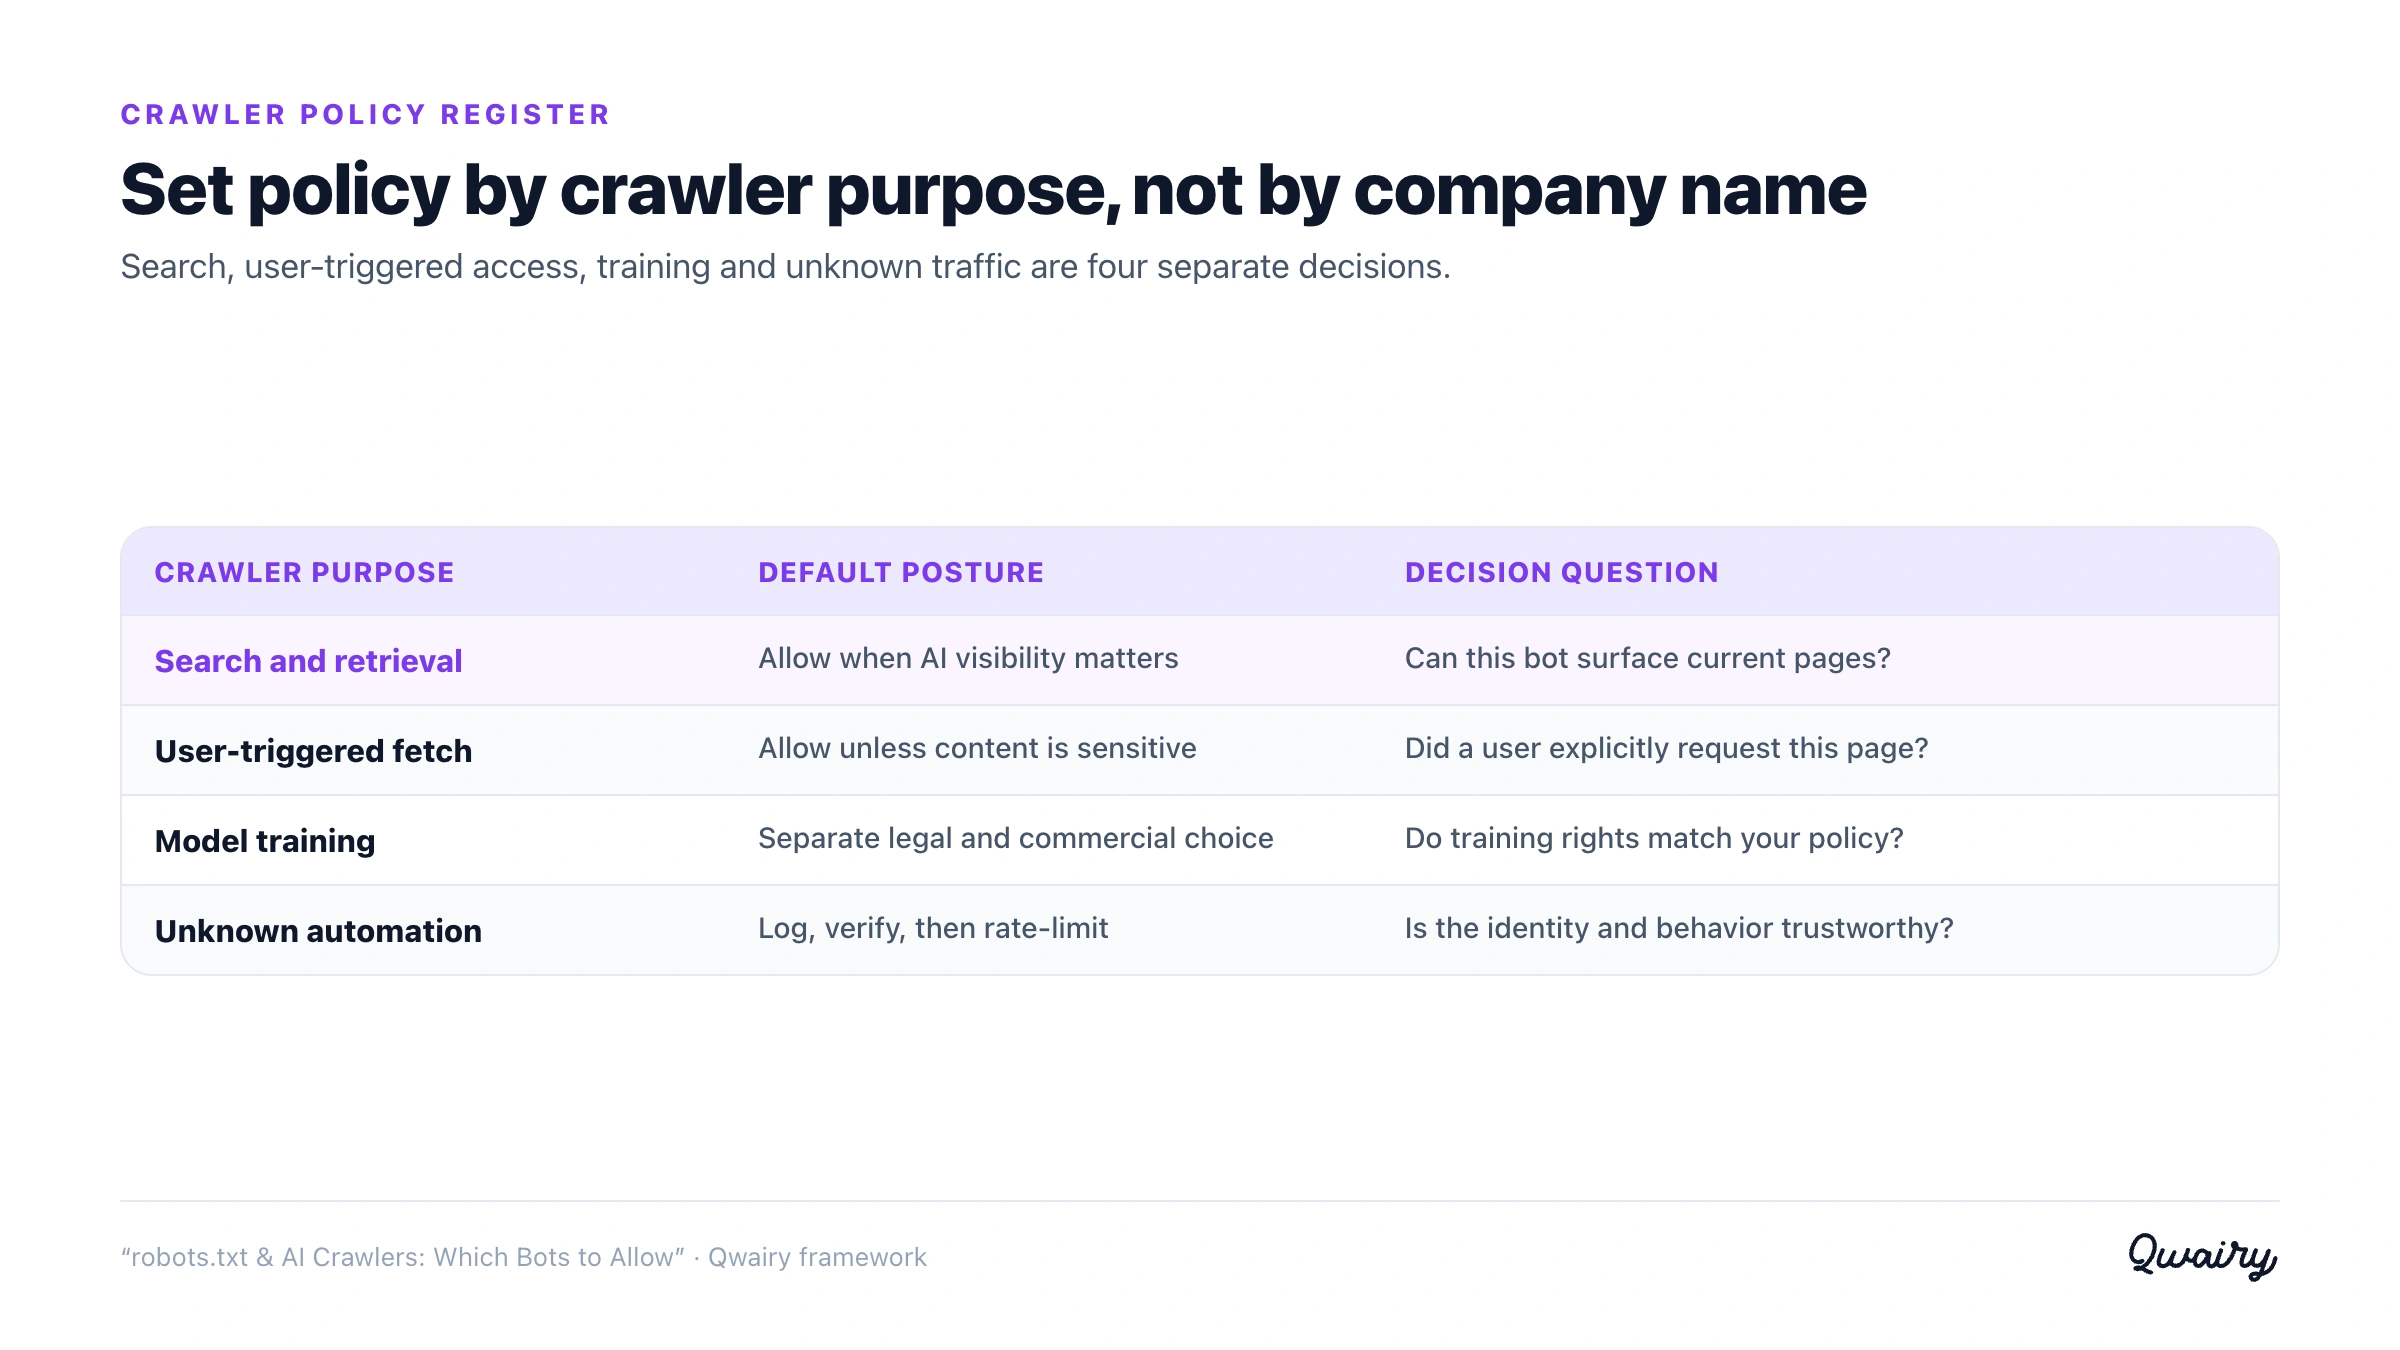
Un fichier robots.txt n’est pas une politique. C’est une surface d’application parmi d’autres pour une politique qui doit avoir un responsable, une raison et une date de révision. Utilisez un registre des crawlers IA pour qu’une décision de confidentialité ne se transforme pas par accident en panne de visibilité.
Champ | Décision requise | Preuve |
Agent et rôle | Entraînement, récupération pour la recherche, requête déclenchée par l’utilisateur ou collecte de jeux de données | Documentation du fournisseur |
Intention business | Autoriser, limiter le débit, soumettre à un défi ou bloquer | Responsable de la politique nommé et justification |
Application | robots.txt seul, ou robots.txt avec contrôle CDN/WAF | Identifiant de règle et réponse testée |
Conséquence attendue | Refus de l’entraînement, éligibilité à la citation réduite, ou aucun impact sur Search | Surface produit concernée, documentée |
Déclencheur de révision | Changement chez le fournisseur, changement de nom du bot, anomalie de trafic ou revue trimestrielle | Date de dernière révision |
Avant le déploiement, franchissez trois barrières :
Ce registre transforme la gestion des crawlers en gestion du changement réversible, au lieu d’un assemblage de directives copiées.
On ne gère pas ce qu’on ne voit pas, et robots.txt n’offre aucune boucle de retour. Pour savoir si vos règles fonctionnent, et quels bots s’intéressent vraiment à votre contenu, allez à la source de vérité : vos journaux serveur.
User-Agent sur les tokens ci-dessus : GPTBot, ClaudeBot, OAI-SearchBot, PerplexityBot, Claude-SearchBot, etc.PerplexityBot depuis une IP absente de ces listes est un signal d’alerte.Cette analyse de journaux est fastidieuse à la main, c’est pourquoi la visibilité sur les crawlers est intégrée aux plateformes de visibilité IA. Qwairy fait apparaître l’activité des crawlers IA à côté du résultat qui compte vraiment : ces explorations se traduisent-elles en citations et en mentions dans ChatGPT, Claude, Perplexity, Gemini et Google AI Overviews ? Voir « GPTBot a exploré 400 pages » à côté de « nous avons été cités dans N réponses cette semaine » est la façon de savoir si votre stratégie robots.txt vous aide ou vous coûte discrètement. Pour en savoir plus sur les fondations techniques qui permettent d’être lu et cité par l’IA, consultez le blog Qwairy.
Complétez l’audit technique : utilisez la checklist GEO technique, testez ce qui survit au rendu JavaScript et lisez le guide fondé sur des preuves consacré à llms.txt avant d’ajouter un nouveau fichier lisible par les machines.
robots.txt est un instrument contondant braqué sur un problème subtil. L’erreur que presque tout le monde commet est de traiter les « crawlers IA » comme un seul ennemi à bloquer. Ce n’est pas le cas : les crawlers d’entraînement, de récupération et les agents déclenchés par l’utilisateur font des métiers différents, et bloquer chacun a un coût différent. Bloquez l’entraînement si c’est votre position de principe, mais réfléchissez longuement avant de bloquer les agents de récupération et ceux déclenchés par l’utilisateur, car ce sont eux qui offrent à un moteur IA une voie majeure pour vous récupérer et vous citer. Faites ce choix délibérément, écrivez les règles explicitement, puis surveillez vos journaux pour confirmer que la réalité correspond à l’intention.
Pas à lui seul. GPTBot est le crawler d’entraînement d’OpenAI. Le crawler qui vous permet d’apparaître et d’être cité dans les réponses en direct de ChatGPT est OAI-SearchBot, et les récupérations déclenchées par l’utilisateur passent par ChatGPT-User. Si vous voulez refuser l’entraînement tout en restant visible dans ChatGPT, bloquez GPTBot tout en autorisant OAI-SearchBot et ChatGPT-User.
Bloquer Google-Extended ne nuira pas : Google précise que c’est un token de refus de l’entraînement et de l’ancrage, qui n’affecte ni le classement dans Search ni l’inclusion. En revanche, bloquer Googlebot y nuira à coup sûr : il alimente Google Search ainsi qu’AI Overviews et AI Mode, construits sur cet index. Gardez Googlebot autorisé, sauf si vous voulez quitter complètement Google Search.
Seulement pour les crawlers respectueux, et seulement à partir de maintenant. Un Disallow demande aux bots d’entraînement bien élevés de ne pas récupérer de nouveau contenu, mais il ne peut pas retirer votre contenu des modèles déjà entraînés, des jeux de données tiers comme Common Crawl qui contiennent déjà votre site, ni arrêter les crawlers qui ignorent robots.txt. Pour une application stricte, il faut un blocage au niveau du pare-feu/WAF ou du CDN, pas seulement robots.txt.
GPTBot est une exploration automatisée destinée à l’entraînement des modèles : il récupère méthodiquement des pages pour constituer un corpus d’entraînement. ChatGPT-User est une récupération en temps réel déclenchée par une action précise d’un utilisateur, par exemple demander à ChatGPT de lire ou de résumer une page. L’un agit en masse et en arrière-plan ; l’autre page par page et à la demande. Vous pouvez les autoriser ou les bloquer indépendamment.
Cela dépend de votre objectif. Si vous vendez l’accès à un contenu propriétaire, bloquer les crawlers d’entraînement est raisonnable et vous coûte peu en citations au quotidien. Mais bloquer les crawlers de récupération (OAI-SearchBot, PerplexityBot, Claude-SearchBot) peut retirer vos pages des voies de récupération en direct de ces moteurs et réduire sensiblement votre visibilité en citations. Pour la plupart des marques qui veulent être découvertes, la réponse est de refuser l’entraînement tout en restant ouvert à la récupération.
Les principaux, bien gérés, disent que oui : OpenAI, Anthropic et Google documentent la prise en charge de robots.txt pour leurs crawlers. Mais le respect est volontaire et il n’est pas universel : Cloudflare a rapporté en 2025 que Perplexity avait utilisé des crawlers non déclarés pour contourner des directives d’interdiction d’exploration. Considérez robots.txt comme un signal clair pour les acteurs de bonne foi, et utilisez des contrôles en périphérie ou un WAF quand vous avez besoin d’appliquer réellement un blocage.
Suivez les questions qui comptent pour votre activité, voyez quelles marques chaque réponse mentionne et quelles sources elle cite, puis travaillez sur les manques.
Offre gratuite avec 120 crédits initiaux • Sans carte bancaire
Autres articles
How to Improve Your Brand Sentiment in ChatGPT and AI Search
Being mentioned by ChatGPT is not enough if it calls your products overpriced. A step-by-step process to analyze and improve how AI assistants talk about your brand, with Nike as an example.
Stratégie GEO : 5 vérités sur la recherche IA et un cadre en 4 étapes
Cinq vérités sur la recherche IA partagées au SEO & GEO Summit de Paris, et le cadre GEO en 4 étapes de Qwairy pour être recommandé par ChatGPT ou Gemini.