Loading page

Guide du SEO d’entités à l’ère de l’IA : ce qu’est une entité, pourquoi les moteurs génératifs s’y fient, les signaux à travailler et une feuille de route.
Cela fait plus de dix ans que la recherche ne consiste plus à faire correspondre des chaînes de texte. Quand Google a lancé son Knowledge Graph en 2012, il a reformulé tout le problème autour de « des choses, pas des chaînes de caractères » : des personnes, des lieux, des produits et des organisations bien réels, reliés par des faits et des relations. Les moteurs de réponse IA ont hérité de cette vision et en ont fait tout l’enjeu. Quand ChatGPT, Perplexity, Gemini ou les AI Overviews de Google répondent à une question sur votre marché, ils ne parcourent pas une liste classée de dix liens bleus. Ils raisonnent à partir d’entités qu’ils « connaissent » déjà, décident lesquelles sont pertinentes et dignes de confiance, puis choisissent lesquelles nommer. Si votre marque n’est pas une entité clairement définie dans ce réseau de connaissances, elle n’est pas prise en compte : elle est ignorée. L’enjeu dépasse la perte d’un classement. Quand un modèle ne vous reconnaît pas comme une entité distincte, deux scénarios défavorables sont possibles : vous êtes absent de la réponse, ou le modèle vous confond avec une entreprise au nom proche et associe à votre nom les mauvais faits, les mauvais prix ou la mauvaise réputation. Ce guide est la référence sur le SEO d’entités à l’ère de l’IA. Vous y découvrirez ce qu’est réellement une entité, pourquoi les moteurs génératifs s’appuient autant sur les entités, les signaux concrets qui rendent votre marque reconnaissable et une feuille de route pas à pas pour bâtir votre autorité d’entité, ainsi que la manière de mesurer si tout cela fonctionne.
Une entité est une chose identifiable de façon unique, et non un mot-clé. Un mot-clé est une chaîne de caractères. Une entité est le concept qui se cache derrière, avec ses propres attributs et ses propres relations avec d’autres entités. « Apple » en tant que chaîne de caractères est ambigu ; le fruit et l’entreprise sont deux entités distinctes, chacune étant un nœud séparé dans un graphe de connaissances, auquel sont rattachés des faits différents. Les entités ont trois propriétés qui comptent pour l’IA :
Voici la différence concrète :
Ancien modèle (chaînes de caractères) | Modèle par entités (choses) |
Faire correspondre le texte de la requête au texte de la page | Résoudre la requête vers un concept |
Classer des documents selon des signaux de pertinence | Raisonner à partir de faits et de relations |
« 10 liens bleus » que l’utilisateur doit trier | Une réponse synthétisée qui nomme des entités précises |
Densité de mots-clés, correspondance exacte | Cohérence, désambiguïsation, autorité |
Pour une marque, devenir une « entité » signifie que les systèmes qui alimentent les réponses de l’IA détiennent une fiche fiable, correcte et distincte de ce que vous êtes, séparée de toutes les autres réalités qui portent un nom proche du vôtre.
Les moteurs génératifs utilisent les entités pour rester ancrés dans des faits, lever les ambiguïtés et décider de ce qui est assez fiable pour être cité. Comprendre ces trois mécanismes vous indique exactement ce qu’il faut optimiser.
La plupart des moteurs de réponse IA ne se fient pas à leur seule mémoire. Ils récupèrent des documents au moment de la requête (génération augmentée par récupération, ou RAG) et synthétisent une réponse à partir de ce qu’ils ramènent. Les systèmes de récupération résolvent de plus en plus souvent une requête vers des entités d’abord, puis vont chercher les sources les plus fiables sur ces entités. Si votre marque est une entité bien formée, associée à des sources faisant autorité, vous avez beaucoup plus de chances d’être récupéré, et c’est le contenu récupéré qui est cité.
Une partie de ce qu’un modèle « sait » est inscrite dans ses poids lors de l’entraînement. Plus votre marque apparaît de façon cohérente sur le web avec les mêmes faits stables, plus ces faits sont encodés de façon fiable, et plus le modèle vous mentionnera spontanément avec assurance. Des mentions incohérentes ou rares produisent une représentation floue, peu fiable, que le modèle hésite à utiliser.
Les entités sont le moyen par lequel un système résout une ambiguïté. Si « Acme » peut désigner quatre entreprises, le modèle s’appuie sur des signaux d’entité (identifiants structurés, nom cohérent, références croisées faisant autorité) pour choisir la bonne. Des signaux d’entité faibles expliquent précisément pourquoi les modèles confient parfois votre trafic (et votre réputation) à un homonyme. Ce mode de défaillance est assez courant pour avoir son propre guide : la désambiguïsation d’entités pour l’IA. Les travaux universitaires sur l’optimisation pour ces systèmes, notamment l’article GEO : Generative Engine Optimization (publié pour la première fois sur arXiv en 2023 et présenté à KDD 2024), ont montré que la visibilité d’un contenu dans les moteurs génératifs réagit à des signaux comme les citations, les verbatims et un cadrage faisant autorité, plutôt qu’aux tactiques classiques centrées sur les mots-clés. C’est une histoire d’entités et d’autorité, pas de densité de mots-clés. Considérez les chiffres de gain par tactique de cet article comme des ordres de grandeur, et non comme des garanties pour votre niche.
Lancez un audit gratuit : en quelques minutes, ChatGPT, Gemini et Perplexity répondent en direct à 8 questions d’achat sur votre marché, et vous voyez qui ils recommandent.
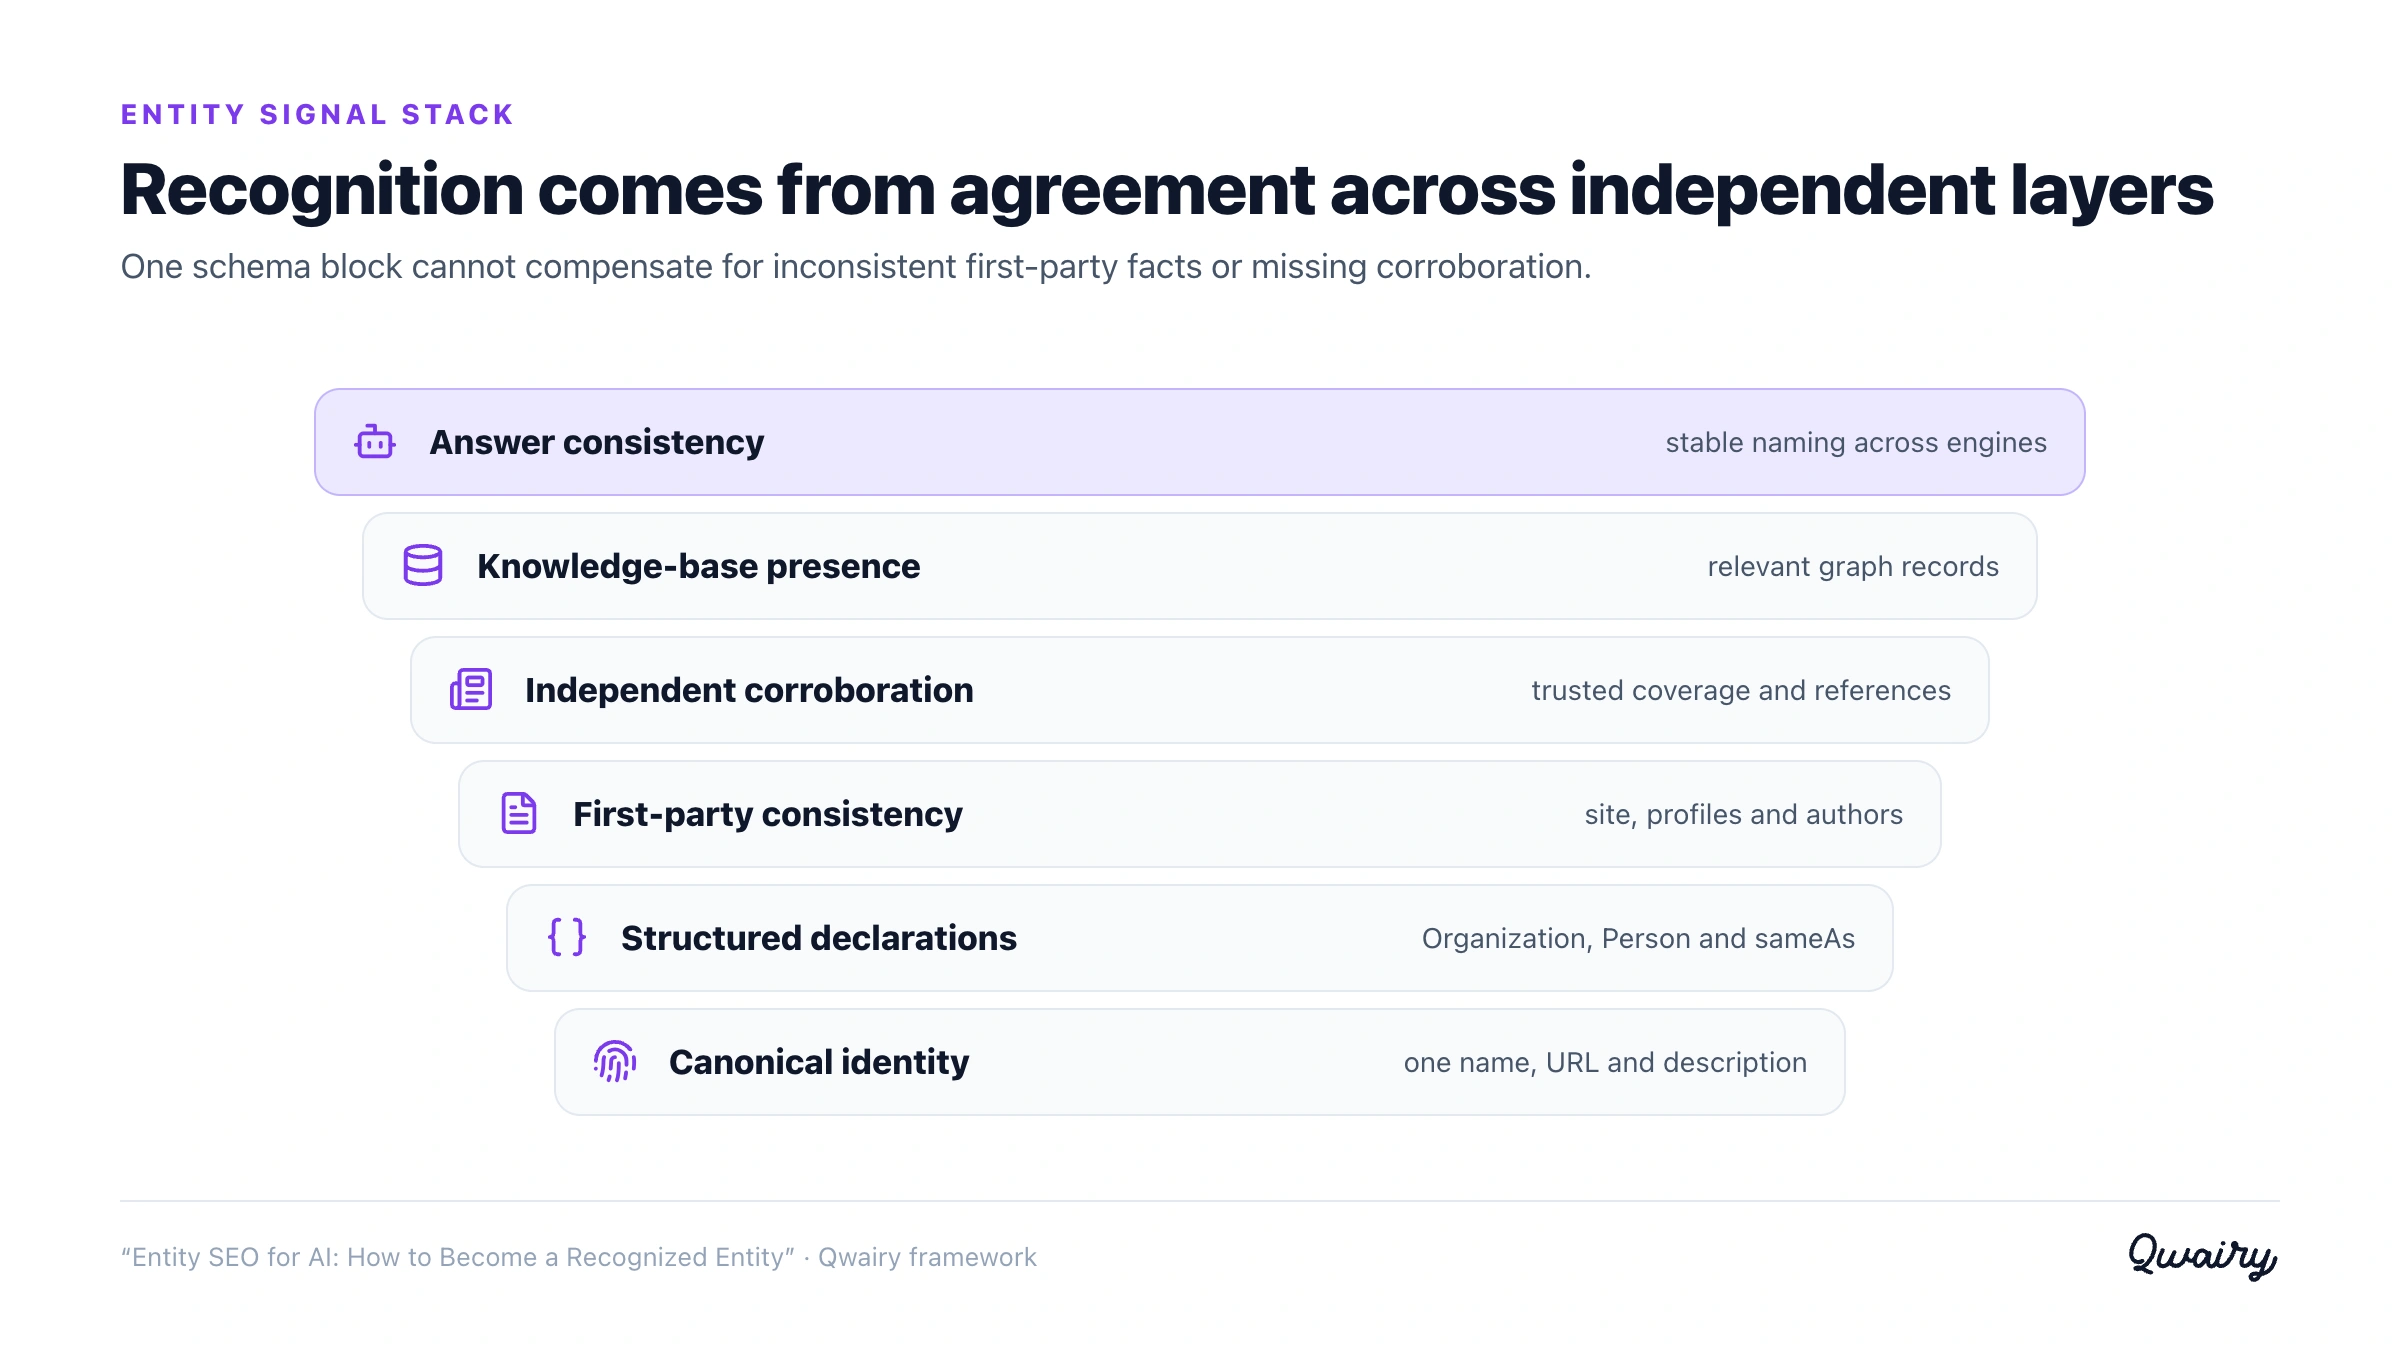
Vous établissez une entité comme un bibliothécaire catalogue un livre : une identité cohérente, des faits vérifiables et des références croisées venant de sources de confiance. Voici les leviers que vous maîtrisez.
Choisissez un nom de marque canonique et utilisez-le à l’identique partout : sur votre site, vos profils sociaux, les annuaires, la presse et vos données structurées. La discipline classique du SEO local, qui consiste à garder un NAP (nom, adresse, téléphone) cohérent, se généralise ici : chaque incohérence (Acme, Acme Inc. ou Acme.io) fragmente votre entité en morceaux flous et affaiblit la confiance du modèle. La cohérence est le signal d’entité le moins coûteux et le plus efficace.
Les données structurées permettent de dire aux machines ce que vous êtes, au lieu d’espérer qu’elles le déduisent. Au minimum, implémentez le schema Organization sur votre site, avec :
name, legalName, url et logosameAs : un tableau d’URL qui pointent vers vos profils de référence (LinkedIn, Crunchbase, votre élément Wikidata, vos comptes officiels sur les réseaux sociaux). La définition de la propriété sameAs décrit comment des URL peuvent identifier une même entité, ce qui en fait l’un des signaux de désambiguïsation les plus directs que vous puissiez envoyer.Person pour les fondateurs et auteurs nommés, et le schema Article pour les contenus éditoriaux.Savoir quels types de schema comptent pour les citations par l’IA est un sujet de fond à part entière : le guide JSON-LD et schema pour les citations par l’IA distingue les signaux d’identité lisibles par les machines qui sont utiles des promesses de citation sans fondement. Ici, le propos est plus restreint : le schema est le moyen d’affirmer l’identité, les faits et les références croisées de votre entité de façon lisible par les machines.
Une entité se définit en grande partie par ce que les autres en disent, et pas seulement par ce que vous dites de vous-même. Être mentionné, et idéalement cité, par des sources que l’IA juge déjà fiables (publications reconnues, bases de données sectorielles, communautés respectées) produit deux effets : cela renforce les faits sur votre entité et cela vous vaut les citations hors site que favorisent les systèmes de récupération. C’est là que le SEO d’entités rejoint les relations presse digitales et l’accent mis par Google sur l’E-E-A-T , c’est-à-dire l’expérience, l’expertise, l’autorité et la fiabilité démontrées.
Wikidata et Wikipedia pèsent bien plus que leur trafic ne le laisse penser, parce qu’ils sont structurés, sous licence ouverte, très référencés entre eux et largement utilisés comme données d’entraînement et d’ancrage. Un élément Wikidata donne à votre entité un identifiant canonique qui relie entre elles vos références sameAs ; un article Wikipedia (lorsque la notoriété le justifie vraiment) est une source d’ancrage solide. Les deux doivent être obtenus honnêtement, selon les règles de notoriété et de sourçage propres à chaque plateforme, et c’est assez important pour que le guide Wikipedia et Wikidata pour la visibilité IA détaille la démarche conforme aux règles. Le degré auquel chaque moteur s’appuie sur Wikipedia et Wikidata varie et évolue avec le temps.
Votre propre site est la source de vérité principale sur votre entité. Une page « À propos » claire qui dit qui vous êtes et ce que vous faites, un maillage interne cohérent, une page auteurs ou équipe, et des pages autonomes qui répondent chacune complètement à une question aident les systèmes de récupération à se faire une image fiable. Structurer l’ensemble de votre site autour de cet objectif est le sujet de Construire le graphe de connaissances de votre marque pour la visibilité IA.
Traitez l’autorité d’entité comme un projet avec une séquence, et non comme une tâche ponctuelle. Suivez ces étapes dans l’ordre : chacune rend la suivante plus efficace.
sameAs avec tous les profils de référence que vous possédez. Validez avec le Rich Results Test de Google et le validateur Schema.org .sameAs désigne.sameAs renseignéConnectez vos logs serveur ou CDN pour voir quelles pages les crawlers IA connus demandent, à quelle fréquence, et comment cela évolue.
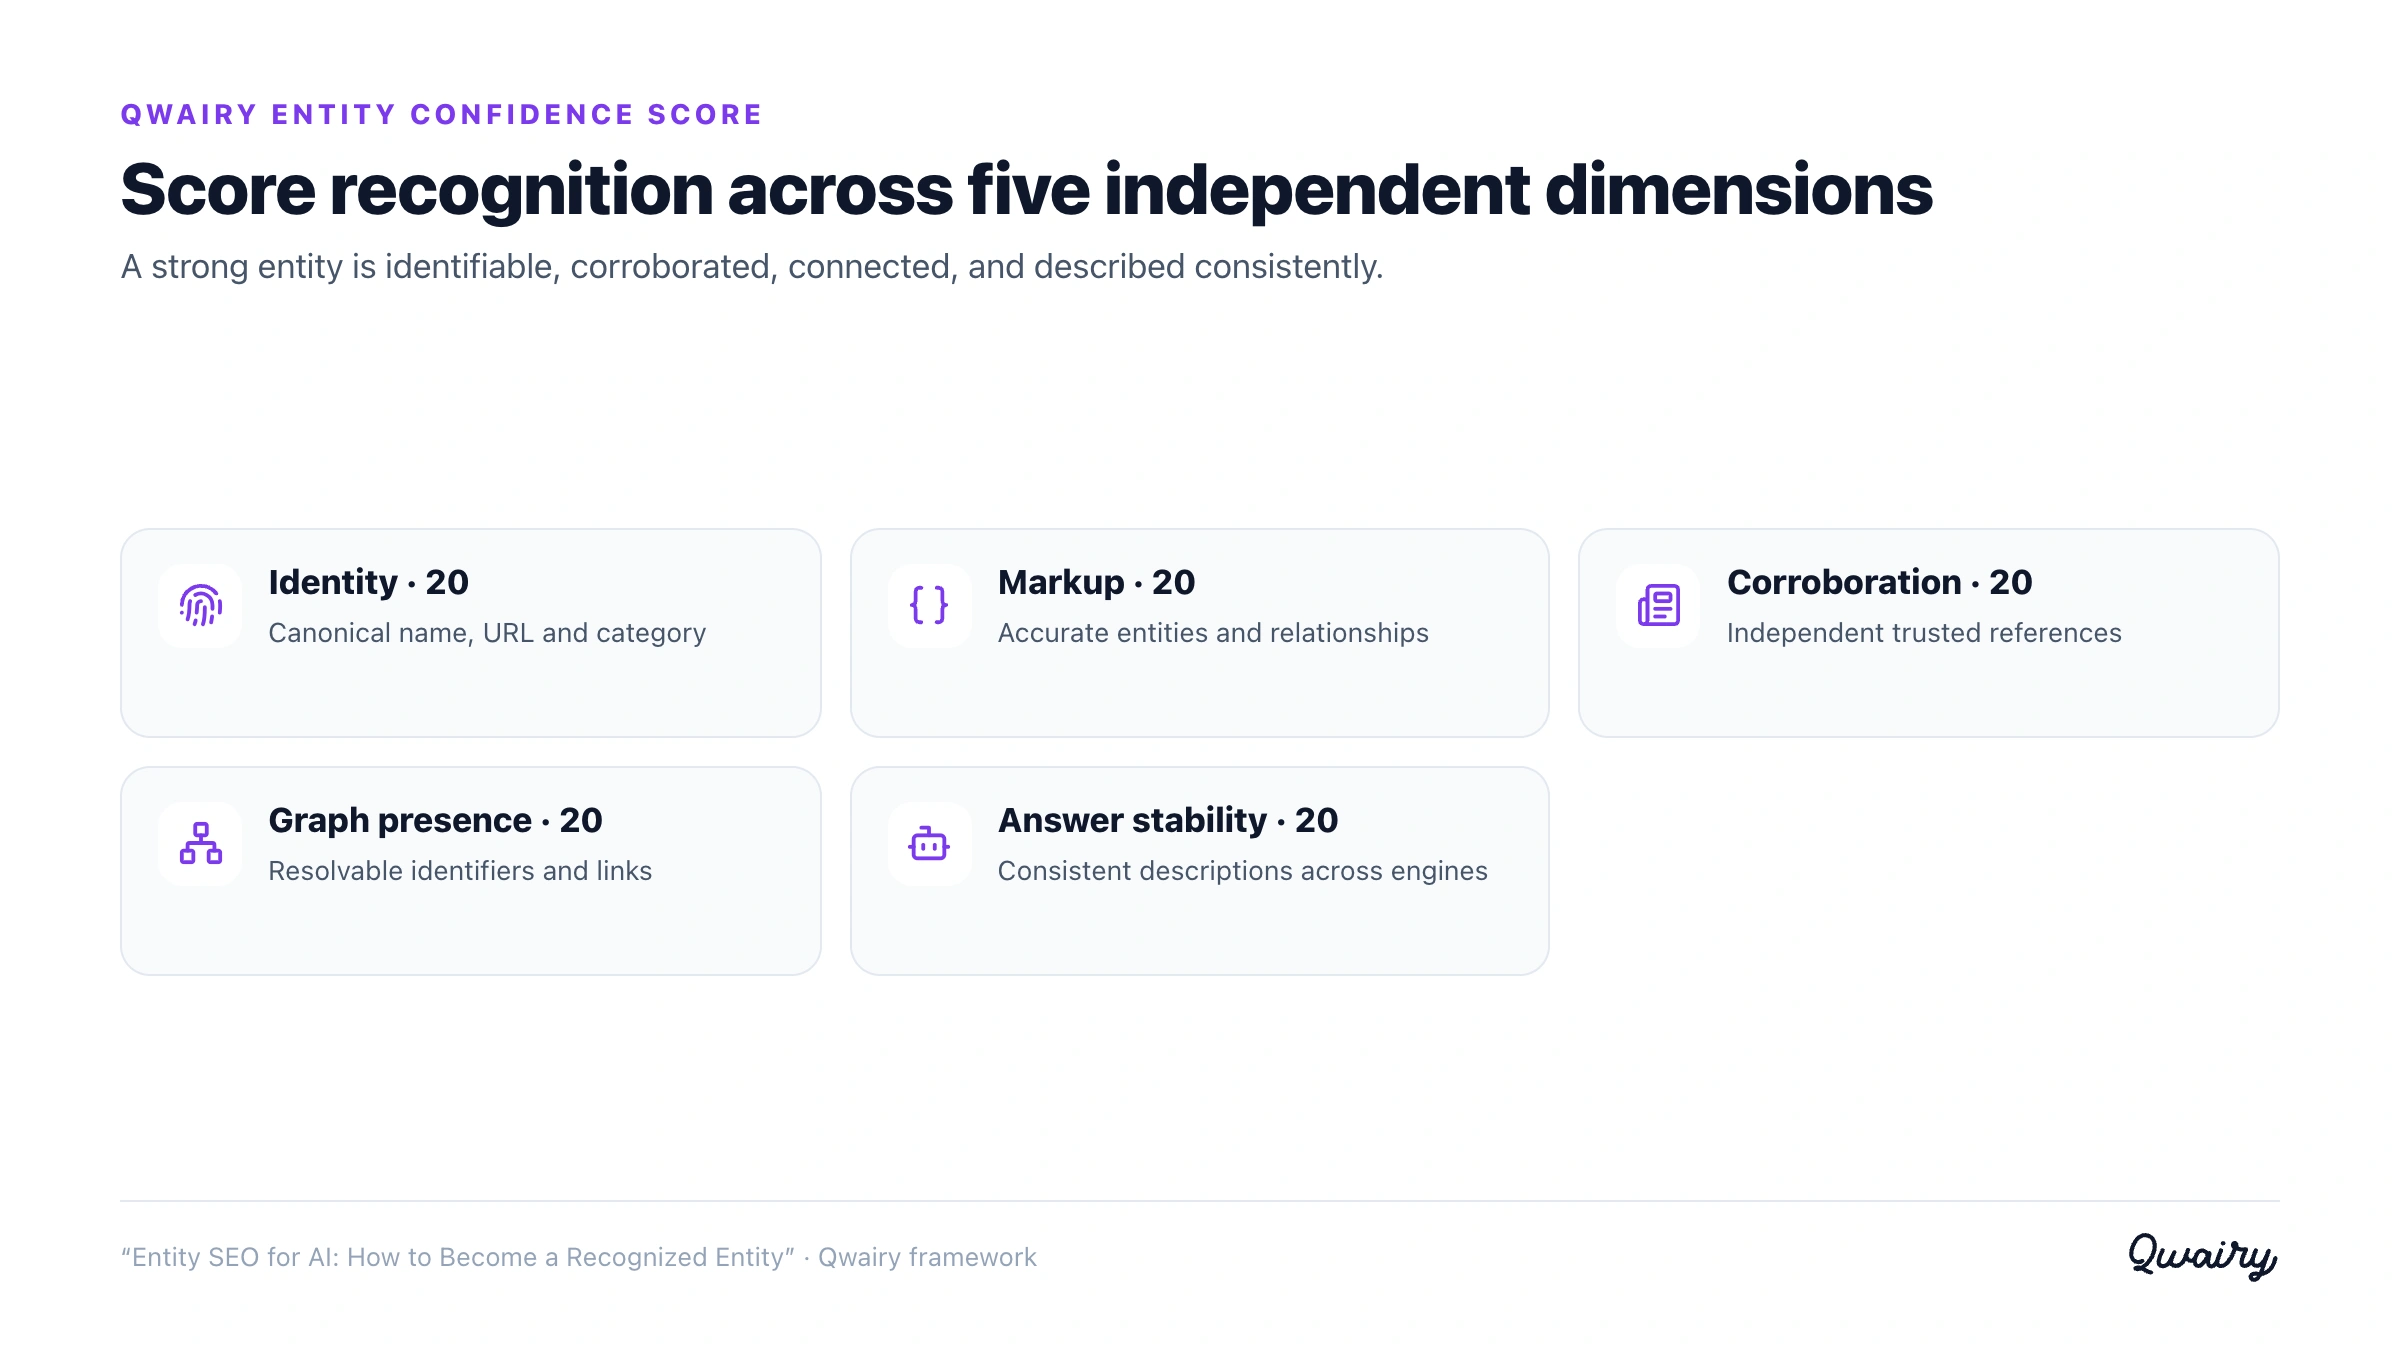
Le SEO d’entités devient actionnable quand la confiance est mesurable. Évaluez la marque sur cinq dimensions, valant chacune 20 points.
Dimension | Référentiel pour 20 points |
Cohérence de l’identité | Le nom canonique, les alias, la catégorie, l’URL, le logo, la localisation et la description principale concordent sur toutes les surfaces officielles. |
Déclaration par la marque | Les pages À propos, auteur, produit et localisation exposent l’entité dans le texte visible et dans du JSON-LD valide avec des identifiants stables. |
Corroboration indépendante | Des sources tierces pertinentes confirment les faits importants sans reprendre les mots de la marque. |
Alignement des sources de connaissances | Les fiches éligibles de Wikidata, Wikipedia, des registres, des sites d’avis et des référentiels sectoriels pointent vers la bonne entité et ses faits à jour. |
Cohérence des réponses | Les prompts IA prioritaires identifient la bonne marque, la bonne catégorie, les bons produits, les bonnes personnes et les bonnes relations, d’un moteur à l’autre. |
Appuyez chaque point sur des preuves. De 85 à 100, la base d’entité est solide. De 70 à 84, l’entité est reconnue mais reste exposée à l’omission ou à la confusion. En dessous de 70, l’optimisation du contenu est prématurée : corrigez d’abord l’identité et la corroboration. Le score évite aussi la cannibalisation au sein de votre propre programme d’entité. Cet article traite de la reconnaissance et de la confiance ; le guide de désambiguïsation traite des conflits avec des homonymes ; le guide du graphe de connaissances traite du modèle de données maintenu dans le temps.
Si vous ne voyez pas comment les moteurs d’IA vous décrivent aujourd’hui, vous optimisez à l’aveugle. Le travail sur les entités a une boucle de retour longue, donc la mesure compte plus que d’habitude. Suivez quelques éléments :
C’est précisément ce qu’une plateforme comme Qwairy est conçue pour mesurer : elle suit la façon dont votre marque apparaît dans ChatGPT, Claude, Perplexity, Gemini et les AI Overviews de Google, avec la visibilité et la part de citations, les sources qui alimentent ces réponses, les comparaisons avec les concurrents, ainsi que le sentiment et les attributs que les modèles associent à votre entité. « Devenir une entité reconnue » cesse ainsi d’être un acte de foi : vous pouvez établir un point de départ, agir, puis en prouver l’effet. Vous pouvez approfondir les tactiques connexes sur le blog Qwairy.
Passez de la stratégie d’entité à la mise en œuvre : corrigez les collisions de noms avec le playbook de désambiguïsation d’entités, construisez un graphe de connaissances de marque maintenu dans le temps, et évaluez Wikipedia et Wikidata sans contourner les règles de notoriété.
Les entités sont la langue dans laquelle pensent les moteurs de réponse IA. Votre objectif n’est pas de faire grimper un mot-clé dans un classement : c’est de devenir quelque chose que les modèles connaissent, une entité distincte, correctement décrite et bien recoupée, qu’ils peuvent récupérer, en laquelle ils peuvent avoir confiance et qu’ils peuvent nommer avec assurance. Alignez votre identité canonique, vos données structurées, vos mentions faisant autorité et votre présence dans les graphes de connaissances, puis mesurez comment les moteurs vous décrivent réellement et comblez les écarts. Vous cesserez alors d’être une chaîne de caractères que les modèles négligent pour devenir une entité qu’ils recommandent.
Le SEO d’entités consiste à établir votre marque, vos équipes et vos produits comme des « entités » clairement définies et identifiables de façon unique, que les systèmes de recherche et d’IA reconnaissent, au lieu d’optimiser pour des chaînes de mots-clés. Il repose sur une identité cohérente, des données structurées, des références croisées faisant autorité et une présence dans les graphes de connaissances, pour que les machines détiennent une fiche fiable et correcte de ce que vous êtes.
Le SEO traditionnel optimise surtout des documents pour qu’ils se classent sur des chaînes de requête. Le SEO d’entités optimise la représentation de votre marque dans le graphe des choses que le web connaît : ses faits, ses relations et ses identifiants. Les deux sont complémentaires : de solides bases SEO aident toujours les moteurs d’IA à vous trouver et à vous faire confiance, mais ce sont les signaux d’entité qui permettent à un modèle de vous nommer avec assurance dans une réponse synthétisée.
Non. Un nom cohérent, les schemas Organization et Person avec un sameAs renseigné, des profils revendiqués et des mentions tierces faisant autorité peuvent établir une entité solide sans Wikipedia. Wikipedia et Wikidata aident beaucoup, mais seulement si vous remplissez réellement leurs critères de notoriété et de sourçage : consultez le guide dédié pour obtenir une présence sur Wikipedia et Wikidata.
Commencez par le schema Organization (avec logo et un sameAs bien renseigné), ajoutez le schema Person pour les fondateurs et auteurs nommés, et utilisez le schema Article sur les contenus éditoriaux. sameAs est particulièrement important, car il indique explicitement aux machines que plusieurs profils externes désignent une même entité, ce qui facilite la désambiguïsation.
En général parce que vos signaux d’entité sont faibles ou incohérents : le modèle ne peut pas vous distinguer de façon fiable d’une réalité au nom proche. Parmi les remèdes : un nom canonique unique utilisé partout, des références croisées sameAs, un élément Wikidata et un contenu faisant autorité qui fixe vos faits. Le guide de la désambiguïsation d’entités détaille le remède complet.
Demandez aux principaux moteurs d’IA de décrire votre marque et vérifiez l’exactitude et l’assurance de leurs réponses, surveillez les confusions avec des homonymes, et suivez la fréquence à laquelle les modèles vous citent (et les sources qu’ils utilisent) quand ils répondent à des questions de votre catégorie. Des outils comme Qwairy surveillent tout cela sur plusieurs moteurs, pour que vous puissiez établir une référence de départ sur la reconnaissance de l’entité, la part de citations et le sentiment, puis mesurer leur évolution dans le temps.
Suivez les questions qui comptent pour votre activité, voyez quelles marques chaque réponse mentionne et quelles sources elle cite, puis travaillez sur les manques.
Offre gratuite avec 120 crédits initiaux • Sans carte bancaire
Autres articles
How to Improve Your Brand Sentiment in ChatGPT and AI Search
Being mentioned by ChatGPT is not enough if it calls your products overpriced. A step-by-step process to analyze and improve how AI assistants talk about your brand, with Nike as an example.
Stratégie GEO : 5 vérités sur la recherche IA et un cadre en 4 étapes
Cinq vérités sur la recherche IA partagées au SEO & GEO Summit de Paris, et le cadre GEO en 4 étapes de Qwairy pour être recommandé par ChatGPT ou Gemini.