Loading page

La plupart des crawlers IA lisent le HTML brut sans exécuter votre JavaScript : le contenu côté client leur échappe. Testez-le et corrigez-le (SSR, SSG).
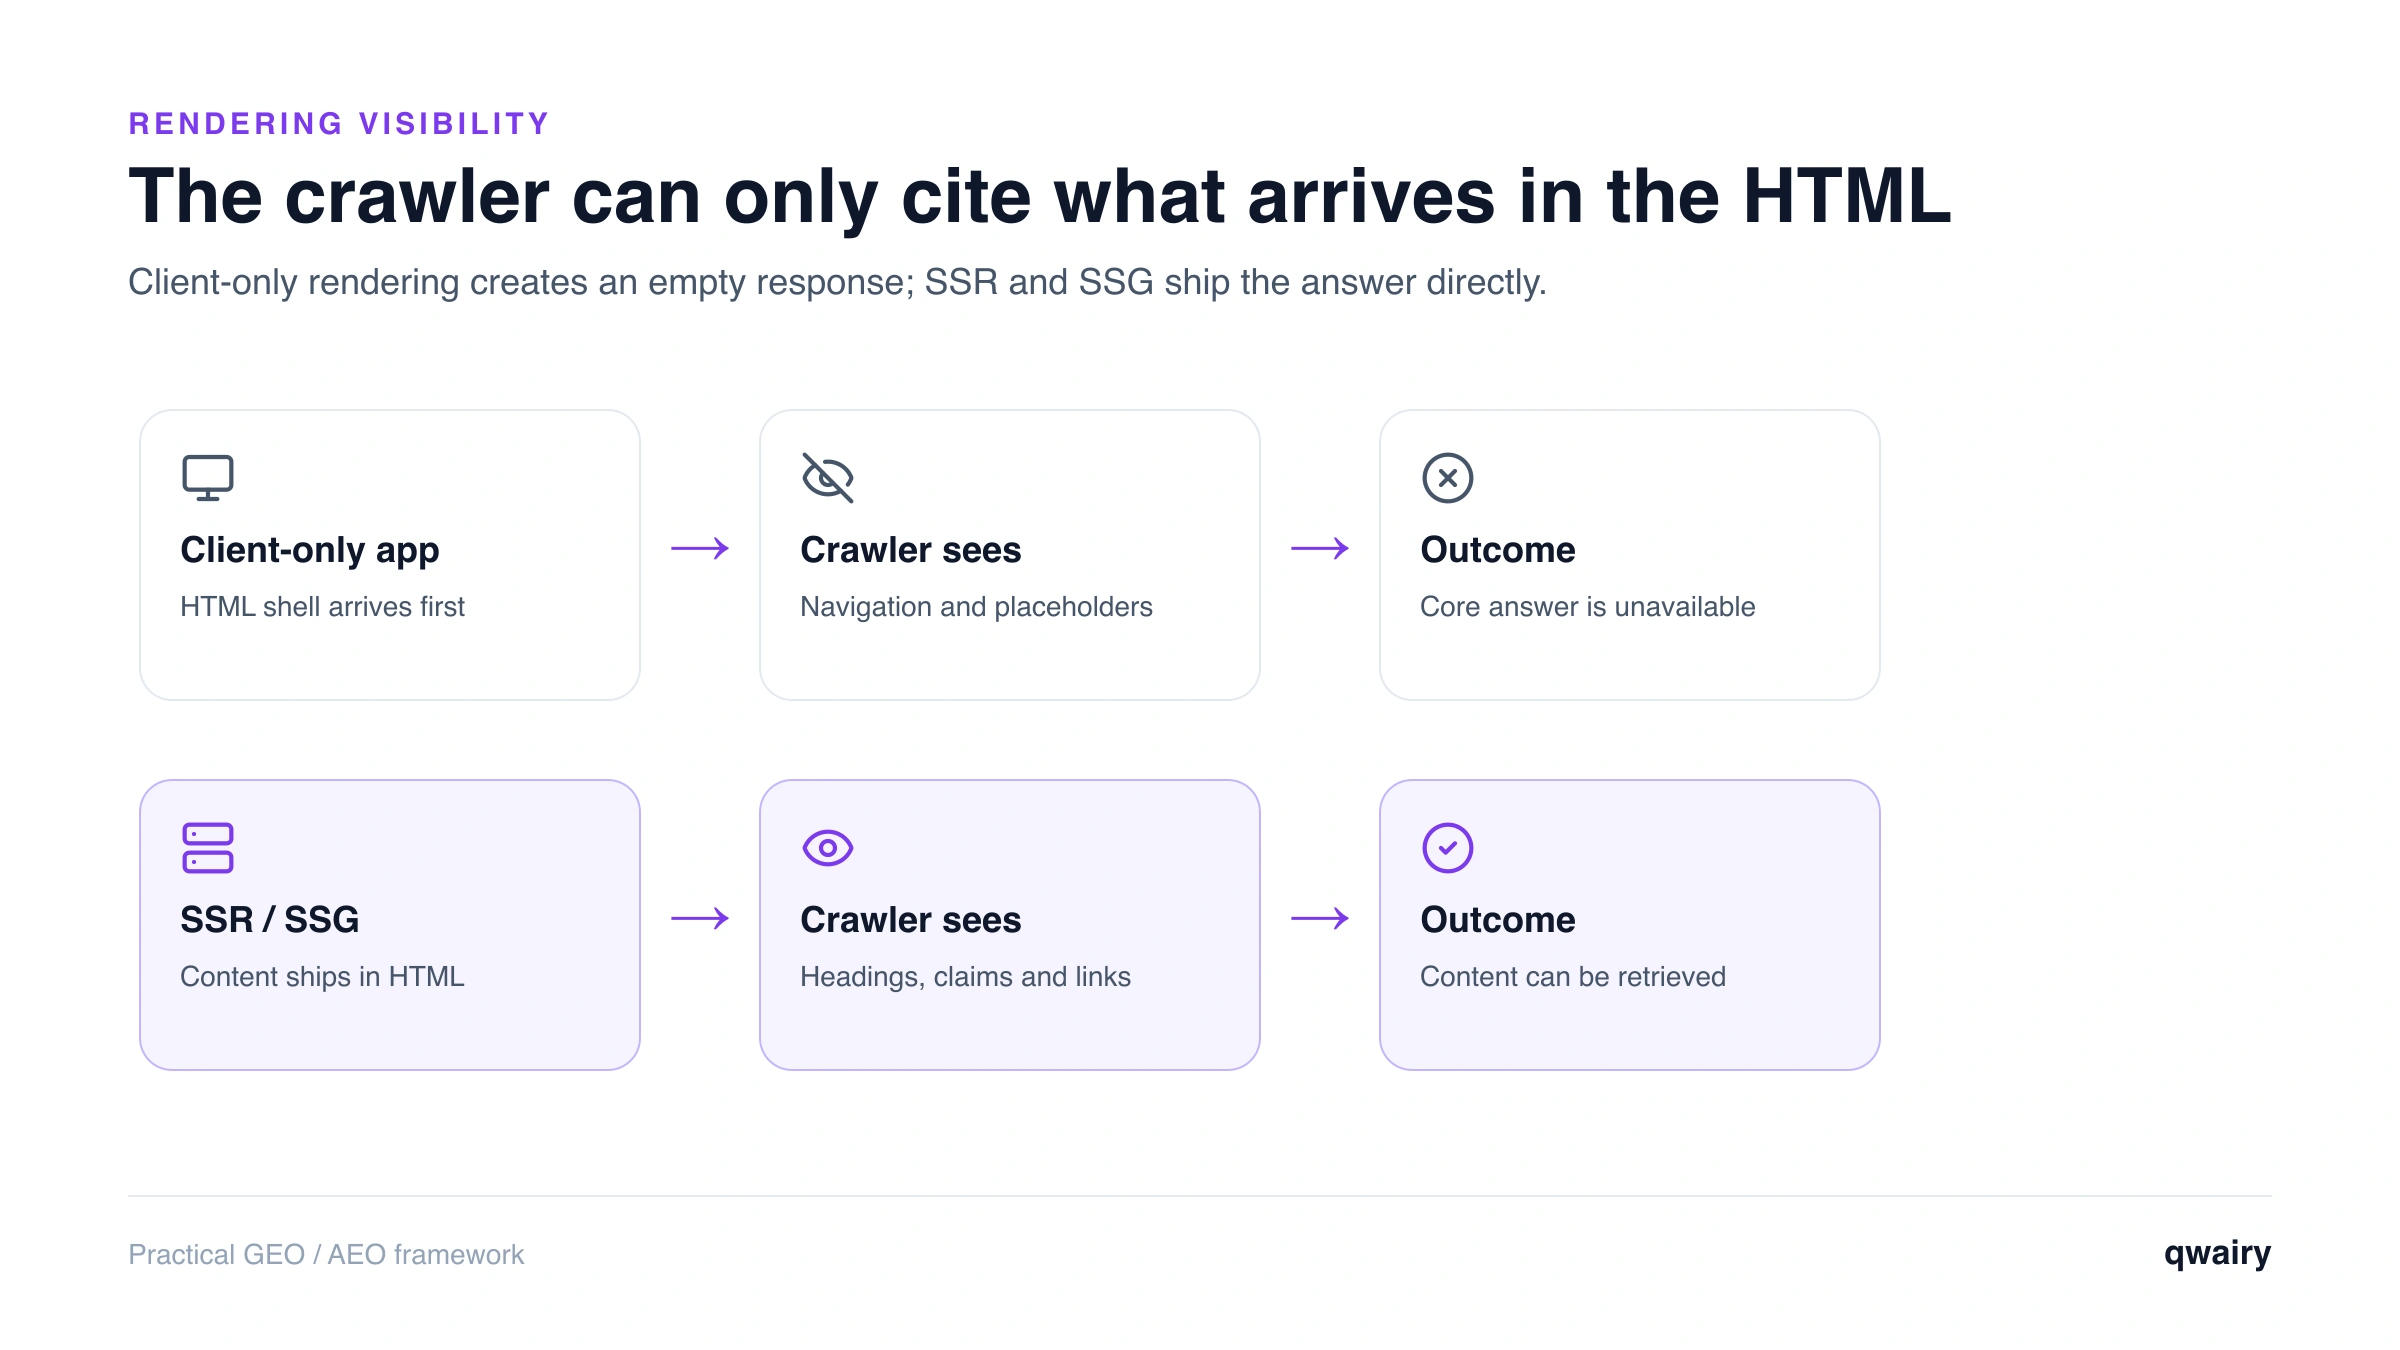
Le problème de fond tient à un décalage entre la façon dont votre site livre le contenu et celle dont les crawlers IA le consomment. Une application monopage (SPA) moderne construite avec React, Vue ou Angular expédie souvent un document HTML presque vide, accompagné d’un paquet de JavaScript. Le navigateur exécute ce JavaScript, appelle vos API et affiche le contenu. Un humain voit une page complète. Un crawler qui n’exécute pas le JavaScript voit la coquille vide qu’on lui a remise. Les moteurs de recherche ont appris à contourner le problème en rendant les pages. Google procède en deux passes : il explore le HTML brut, puis met la page en file d’attente de rendu dans une instance Chromium headless avant d’indexer le DOM final (Google Search Central : les bases du SEO JavaScript ). C’est plus lent et plus coûteux que de lire du HTML statique, mais le contenu côté client finit par être indexé. La plupart des crawlers IA ne le font pas. Ils se comportent comme un simple client HTTP : demander l’URL, lire le HTML renvoyé, passer à la suite. L’analyse du trafic des crawlers IA menée par Vercel a montré que les principaux bots d’IA, dont GPTBot d’OpenAI et ClaudeBot d’Anthropic, récupéraient les fichiers JavaScript sans les exécuter : un contenu qui n’existe qu’après le rendu côté client leur était donc, en pratique, invisible (Vercel : The rise of the AI crawler ). Les comportements peuvent évoluer ; considérez donc ce constat comme la référence actuelle plutôt que comme une loi permanente, et refaites des tests régulièrement. La règle pratique est brutale : si les mots ne sont pas dans la réponse HTML brute, ils n’existent pas pour ces systèmes.
Google AI Overviews et Gemini constituent une exception partielle, car ils s’appuient sur l’index web existant de Google. Un contenu que Google a déjà rendu et indexé peut apparaître dans un AI Overview même s’il a été construit côté client, puisque le gros du rendu a eu lieu plus tôt dans la chaîne de Google. Ne faites pas de cela une stratégie. ChatGPT, Perplexity, Claude et Copilot disposent chacun de leur propre récupération et n’héritent pas de l’index rendu de Google. N’optimiser que pour le seul moteur qui rend vous laisse invisible sur tous les autres. Considérer le HTML brut comme la source de vérité est le choix le plus sûr par défaut, quel que soit le moteur.
Il est utile de séparer la chaîne en étapes, car chacune peut échouer indépendamment :
Le rendu côté client casse discrètement l’étape 2. Et quand l’étape 2 échoue, l’étape 3 n’a jamais l’occasion de se produire : le bot vous a bien exploré, n’a rien vu qui vaille la peine d’être cité, et est passé à autre chose. Vos logs serveur montrent la visite ; votre visibilité ne montre rien.
Lancez un audit gratuit : en quelques minutes, ChatGPT, Gemini et Perplexity répondent en direct à 8 questions d’achat sur votre marché, et vous voyez qui ils recommandent.
La prise en charge du rendu se répartit grosso modo entre « moteurs de recherche » et « crawlers natifs de l’IA », mais la carte évolue sans cesse : vérifiez avant de parier dessus. Le tableau général en 2026 :
Crawler / user-agent | Opérateur | Exécute le JavaScript ? |
Googlebot | Google | Oui (rendu en deux passes) |
Bingbot | Microsoft | Oui, au moins en partie |
GPTBot / OAI-SearchBot | OpenAI | Non |
ClaudeBot / Claude-Web | Anthropic | Non |
PerplexityBot | Perplexity | Non |
Google-Extended | Google | Ce n’est pas un crawler : c’est un jeton de refus d’entraînement, sans moteur de rendu distinct |
Deux nuances méritent d’être retenues :
L’hypothèse de travail la plus sûre : écrivez pour un crawler qui lit le HTML brut et n’exécute rien. Si votre contenu passe ce test, il passe partout.
Il n’y a pas besoin d’outil spécial pour détecter le problème : il suffit de regarder le HTML que le serveur renvoie réellement, et non la page que votre navigateur affiche. Appliquez ces vérifications à toute page qui compte pour vous.
view-source: sur l’URL (ou appuyez sur Ctrl/Cmd+U). Vous voyez le HTML tel qu’il est livré, avant l’exécution du JavaScript. Cherchez-y une phrase distinctive de votre contenu principal. Si elle n’y est pas, elle n’y est pas non plus pour un crawler sans rendu.curl -A "GPTBot" https://yourdomain.com/page et lisez la sortie. curl n’exécute jamais de JavaScript : il approxime donc ce que reçoit un bot d’IA sans rendu. Un <div id="root"></div> vide, sans aucun texte, est la preuve flagrante.Commencez par vos pages de plus forte valeur : pages produit, guides piliers, pages de comparaison, tout ce que vous voulez voir cité. Si le HTML brut est maigre, vous avez trouvé votre problème d’invisibilité.
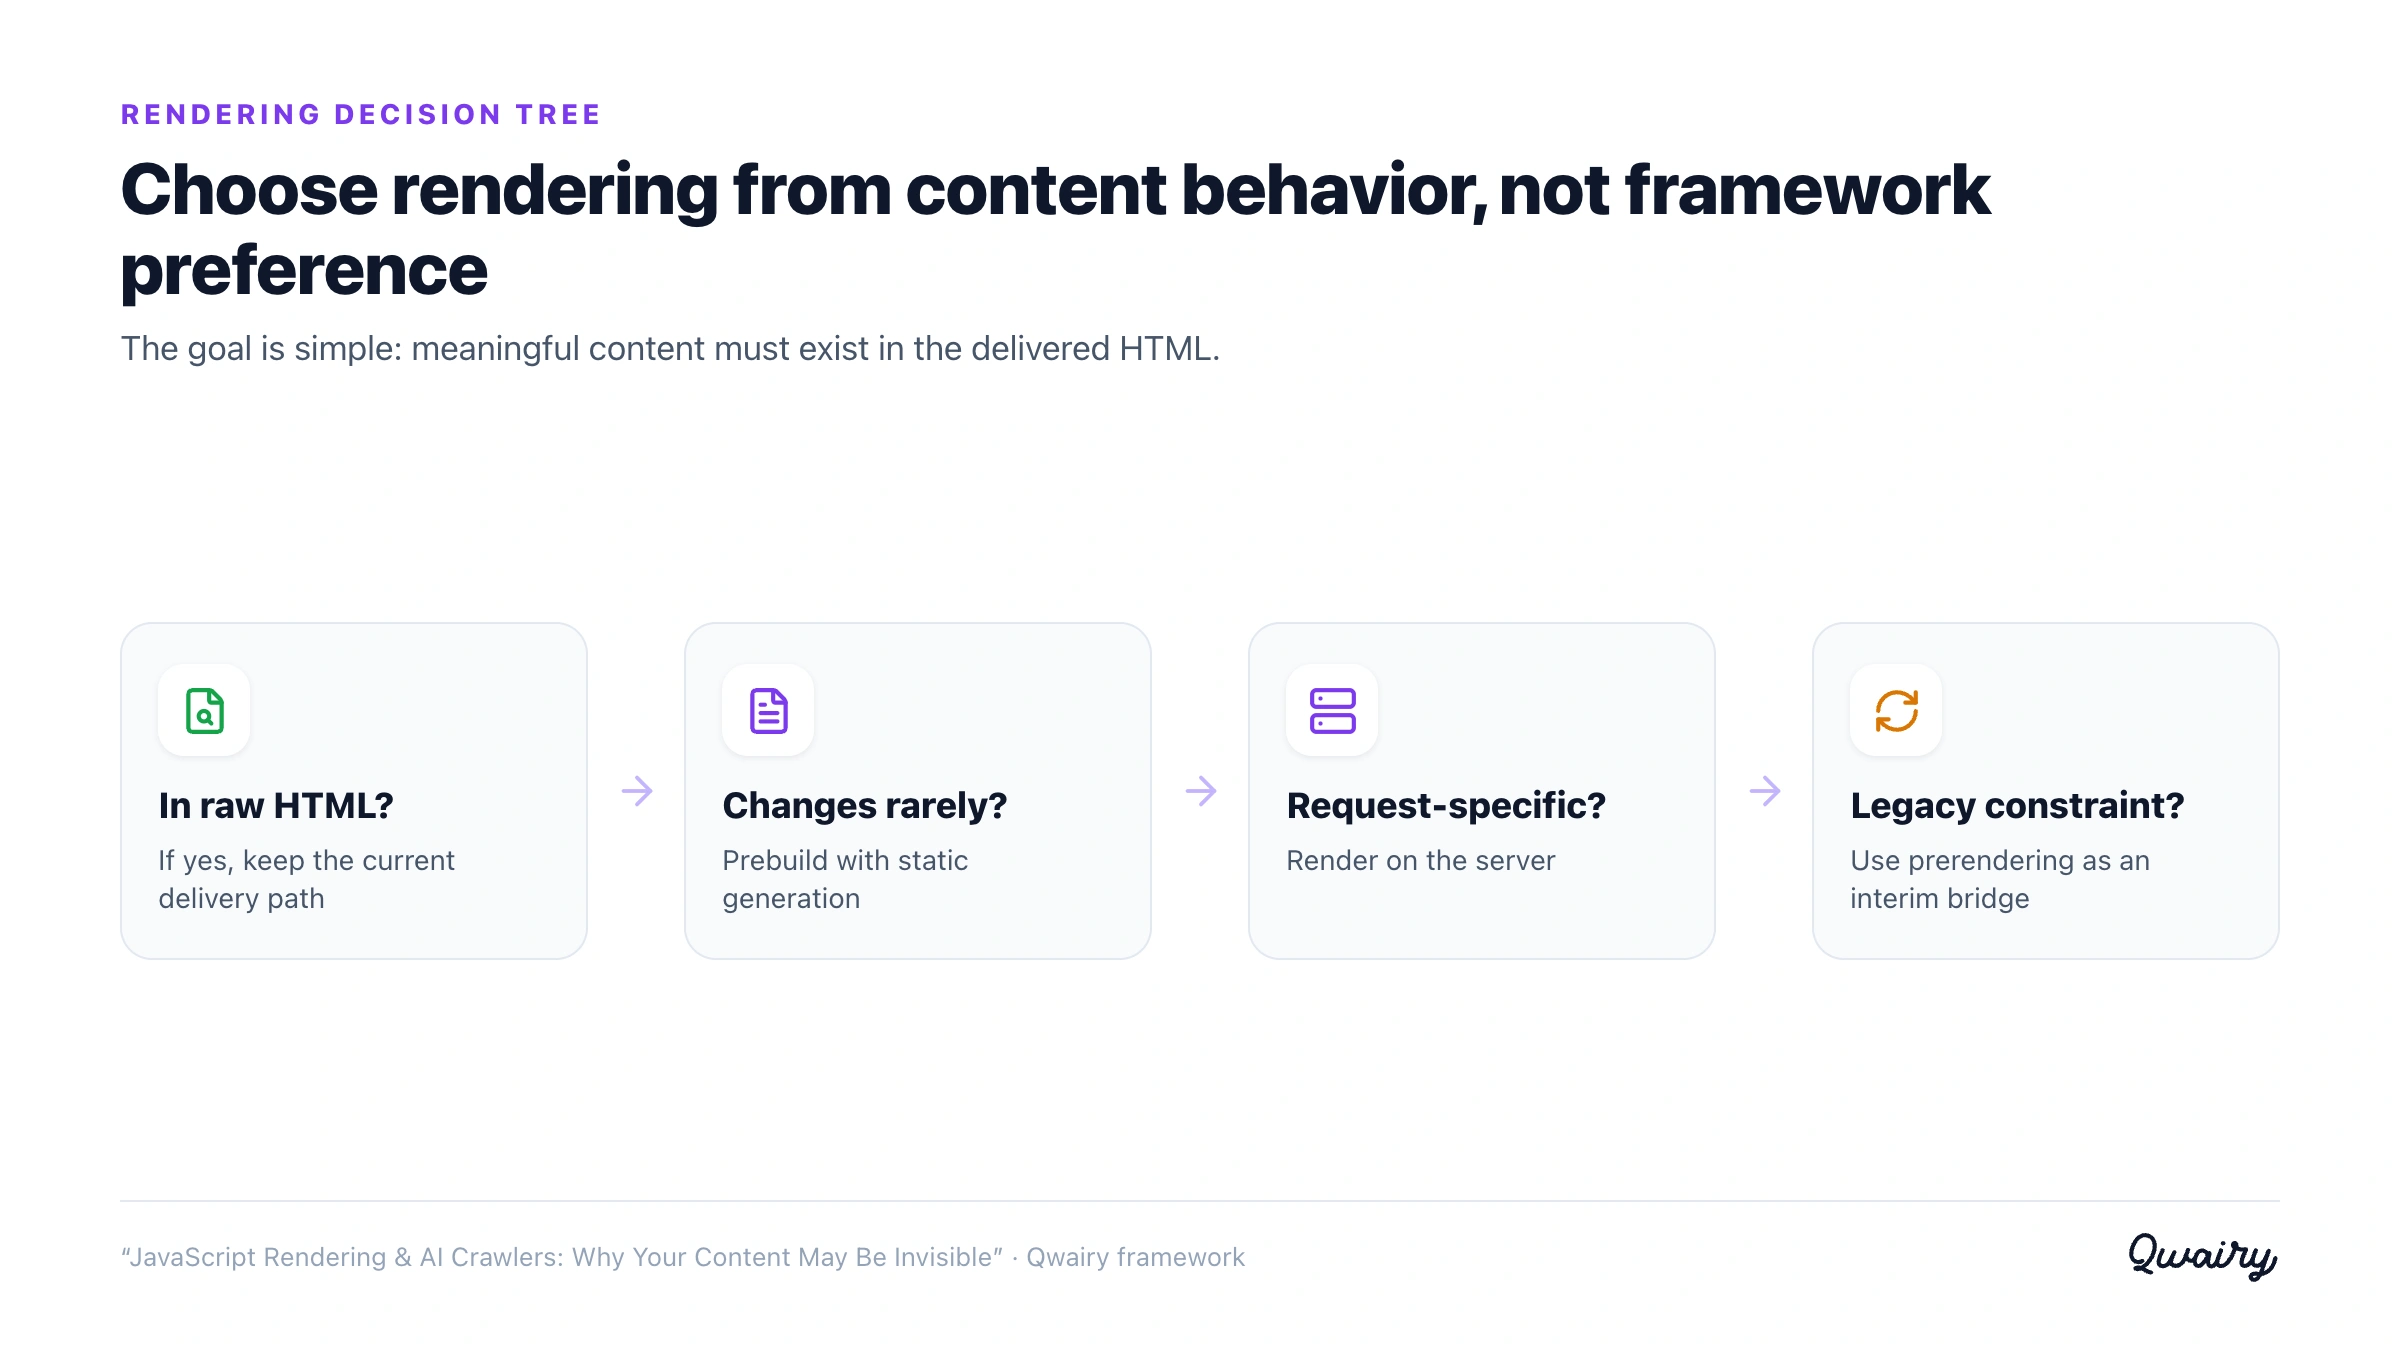
La solution repose toujours sur la même idée : livrer du HTML signifiant dès la première réponse au lieu de l’assembler dans le navigateur. La manière d’y parvenir dépend de votre stack et du caractère dynamique du contenu.
Le SSR construit le HTML complet sur le serveur à chaque requête, puis l’hydrate dans le navigateur. Des frameworks comme Next.js, Nuxt, Remix et SvelteKit en font la voie par défaut. Le crawler reçoit un document complet ; l’utilisateur obtient toujours une application interactive après l’hydratation. C’est l’option la plus robuste pour un contenu qui change à chaque requête ou à chaque utilisateur, et le choix par défaut le plus sûr pour tout ce que vous voulez faire lire par les moteurs d’IA.
Vérifiez les règles de votre robots.txt, votre llms.txt et votre sitemap pour les crawlers IA avant de réécrire la moindre page.
Le SSG génère les pages en HTML statique au moment du build et les sert sous forme de fichiers plats. Pour un contenu qui ne change pas à chaque requête (articles de blog, documentation, pages marketing et de comparaison), le SSG fournit du HTML entièrement formé, avec le moins de complexité à l’exécution et les meilleures performances. Si votre contenu citable est surtout éditorial, c’est souvent la correction la plus simple et la plus durable.
Le prérendu sert aux bots un instantané HTML préconstruit, tandis que les humains conservent l’application côté client. Des services et des outils auto-hébergés (par exemple un middleware de type Prerender ou une couche d’instantanés via Chromium headless) interceptent les requêtes des crawlers, rendent la page une fois et renvoient le résultat statique. Considérez-le comme un pont, pas comme une destination. Il ajoute une pièce mobile qui peut se désynchroniser de la page réelle, et Google présente depuis longtemps le rendu dynamique comme un contournement plutôt que comme une recommandation (Google Search Central : rendu dynamique ). Si vous êtes déjà sur un framework moderne, migrer vos routes clés vers le SSR ou le SSG est généralement plus propre que d’entretenir indéfiniment une couche d’instantanés.
L’objectif n’est pas de « tout passer en SSR ». C’est de s’assurer que chaque page qui porte une réponse livre cette réponse dès le premier octet de HTML.
Livrer du SSR est une hypothèse ; ce sont les citations qui font la preuve. Après avoir changé le rendu d’une page, surveillez deux choses : si les crawlers IA atteignent la page, et si votre marque commence à apparaître dans les réponses IA qui s’appuient dessus. Les logs serveur et l’analyse des crawlers vous renseignent sur la première moitié : quels user-agents d’IA visitent quelles URL, à quelle fréquence, et s’ils reçoivent du vrai HTML. La seconde moitié concerne la visibilité : ChatGPT, Perplexity, Gemini et Claude font-ils maintenant remonter et citent-ils la page pour les prompts qui vous importent ? C’est l’écart que Qwairy est conçu pour combler. L’outil suit la façon dont votre marque apparaît et est citée dans les principaux moteurs d’IA, montre les sources et les pages dans lesquelles les modèles puisent réellement, et met en évidence les requêtes de crawlers observées. Vérifiez séparément la réponse HTML reçue par le robot pour examiner le contenu rendu. Quand une correction fonctionne, vous voyez apparaître des citations ; quand une page reste invisible, vous savez qu’il faut regarder le rendu en premier. Il existe aussi un point d’accès MCP pensé pour les agents, si vous préférez interroger ces données depuis vos propres outils.
Terminez la correction du rendu : appliquez la checklist technique du GEO, alignez l’accès des bots avec le guide du robots.txt et des crawlers IA et renforcez la découverte grâce à l’architecture de site pour l’IA.
Le rendu côté client était une décision d’expérience utilisateur devenue discrètement une décision de visibilité. Les visiteurs humains ne l’ont jamais remarqué, si bien que le coût est resté caché, jusqu’au jour où les assistants IA sont devenus une surface de découverte majeure et ont commencé à ignorer toute page dont le contenu ne vit que dans le JavaScript. Le remède est à l’ancienne et fiable : mettre vos mots dans le HTML. Rendre sur le serveur ou au moment du build, tester ce que les bots sans rendu reçoivent réellement, et confirmer la correction avec de vraies citations plutôt qu’avec des suppositions. Faites cela, et les pages que vous avez tant travaillé à optimiser deviennent enfin lisibles par les moteurs qui décident de ce qu’ils recommandent.
En règle générale, non. Les analyses publiques du trafic des crawlers IA ont montré que les principaux bots d’IA récupèrent les fichiers JavaScript mais ne les exécutent pas : un contenu qui n’apparaît qu’après le rendu côté client leur est donc invisible. Googlebot est l’exception notable, car il rend les pages en deux passes. Comme le comportement des crawlers évolue, refaites des tests régulièrement plutôt que de supposer que le comportement actuel est permanent.
L’index rendu de Google peut alimenter Google AI Overviews et Gemini, mais ChatGPT, Perplexity, Claude et Copilot disposent de leur propre récupération et n’héritent pas du rendu de Google. N’optimiser que pour le seul moteur qui rend vous laisse invisible sur les autres. Servir par défaut du HTML explorable couvre tous les moteurs à la fois.
Ouvrez view-source: sur la page (ou appuyez sur Ctrl/Cmd+U) et cherchez une phrase de votre contenu principal. Si le texte n’est pas dans la source brute mais apparaît dans la page affichée, c’est du JavaScript qui le rend. Vous pouvez le confirmer en récupérant l’URL avec curl, qui n’exécute jamais de JavaScript, ou en désactivant le JavaScript dans les DevTools de votre navigateur puis en rechargeant la page.
Bien fait, cela aide généralement les deux. Le SSR et le SSG livrent du HTML signifiant plus vite, ce qui améliore le temps de chargement perçu et donne à chaque crawler, de recherche comme d’IA, le contenu complet dès la première requête. Les frameworks modernes hydratent la page en application pleinement interactive après le chargement du HTML initial : les utilisateurs conservent donc l’expérience d’une SPA.
C’est un bon pont, pas un point d’arrivée idéal. Le prérendu sert aux crawlers un instantané préconstruit tandis que les utilisateurs obtiennent l’application côté client, ce qui règle rapidement la visibilité. Mais l’instantané peut se désynchroniser de la page réelle et ajoute une infrastructure à maintenir : si vous pouvez migrer vos routes clés vers le SSR ou le SSG, c’est en général plus propre et plus durable.
En partie. Copilot s’appuie sur Bing, et Bing exécute le JavaScript au moins dans une certaine mesure : un contenu rendu côté client que Bing a indexé peut donc quand même atteindre Copilot. Un bon SEO Bing est ainsi une voie utile vers la visibilité dans Copilot, mais cela n’aide pas ChatGPT, Perplexity ni Claude, raison pour laquelle du HTML brut explorable reste la base la plus sûre.
Suivez les questions qui comptent pour votre activité, voyez quelles marques chaque réponse mentionne et quelles sources elle cite, puis travaillez sur les manques.
Offre gratuite avec 120 crédits initiaux • Sans carte bancaire
Autres articles
How to Improve Your Brand Sentiment in ChatGPT and AI Search
Being mentioned by ChatGPT is not enough if it calls your products overpriced. A step-by-step process to analyze and improve how AI assistants talk about your brand, with Nike as an example.
Stratégie GEO : 5 vérités sur la recherche IA et un cadre en 4 étapes
Cinq vérités sur la recherche IA partagées au SEO & GEO Summit de Paris, et le cadre GEO en 4 étapes de Qwairy pour être recommandé par ChatGPT ou Gemini.