Loading page

Le socle technique pour être cité par les moteurs d’IA : accès des crawlers, rendu, qualité du HTML, données structurées et découverte. Une checklist priorisée.
Les moteurs génératifs sont la nouvelle couche de découverte. Quand quelqu’un interroge ChatGPT, Perplexity, Google AI Overviews ou Gemini sur votre catégorie, le modèle construit sa réponse à partir des pages qu’il peut atteindre, lire et juger fiables. Si votre site est difficile à récupérer ou à analyser, vous perdez avant même que le classement commence.
La plupart des conseils GEO se concentrent sur le contenu et l’autorité. Les deux comptent, mais ils reposent sur un socle technique qui détermine si un système d’IA peut seulement ingérer vos pages. Un excellent contenu enfoui derrière du JavaScript côté client, des crawlers bloqués ou un balisage cassé n’entre jamais dans l’ensemble des réponses. On ne peut pas être cité pour ce que le modèle n’a jamais vu.
Voici la checklist de référence pour le versant technique du Generative Engine Optimization (GEO). Elle couvre la plomberie : accès des crawlers, rendu, qualité du HTML, données structurées, signaux de découverte et la convention émergente llms.txt.
À la fin, vous disposerez d’une checklist concrète et priorisée, applicable à n’importe quel site, avec des renvois vers des guides plus approfondis pour chaque couche. Rendons vos pages explorables et citables.
Le GEO technique partage ses bases avec le SEO technique, mais ses consommateurs sont différents, et moins indulgents. L’infrastructure de Google a passé vingt ans à apprendre à rendre le JavaScript, à suivre des redirections tortueuses et à reconstituer l’intention à partir de pages imparfaites. La plupart des crawlers IA sont bien plus littéraux. Trois différences redéfinissent vos priorités :
Si les fondations sont mauvaises, toutes les tactiques en aval (E-E-A-T, fraîcheur, citations hors de votre site) sont des efforts perdus.
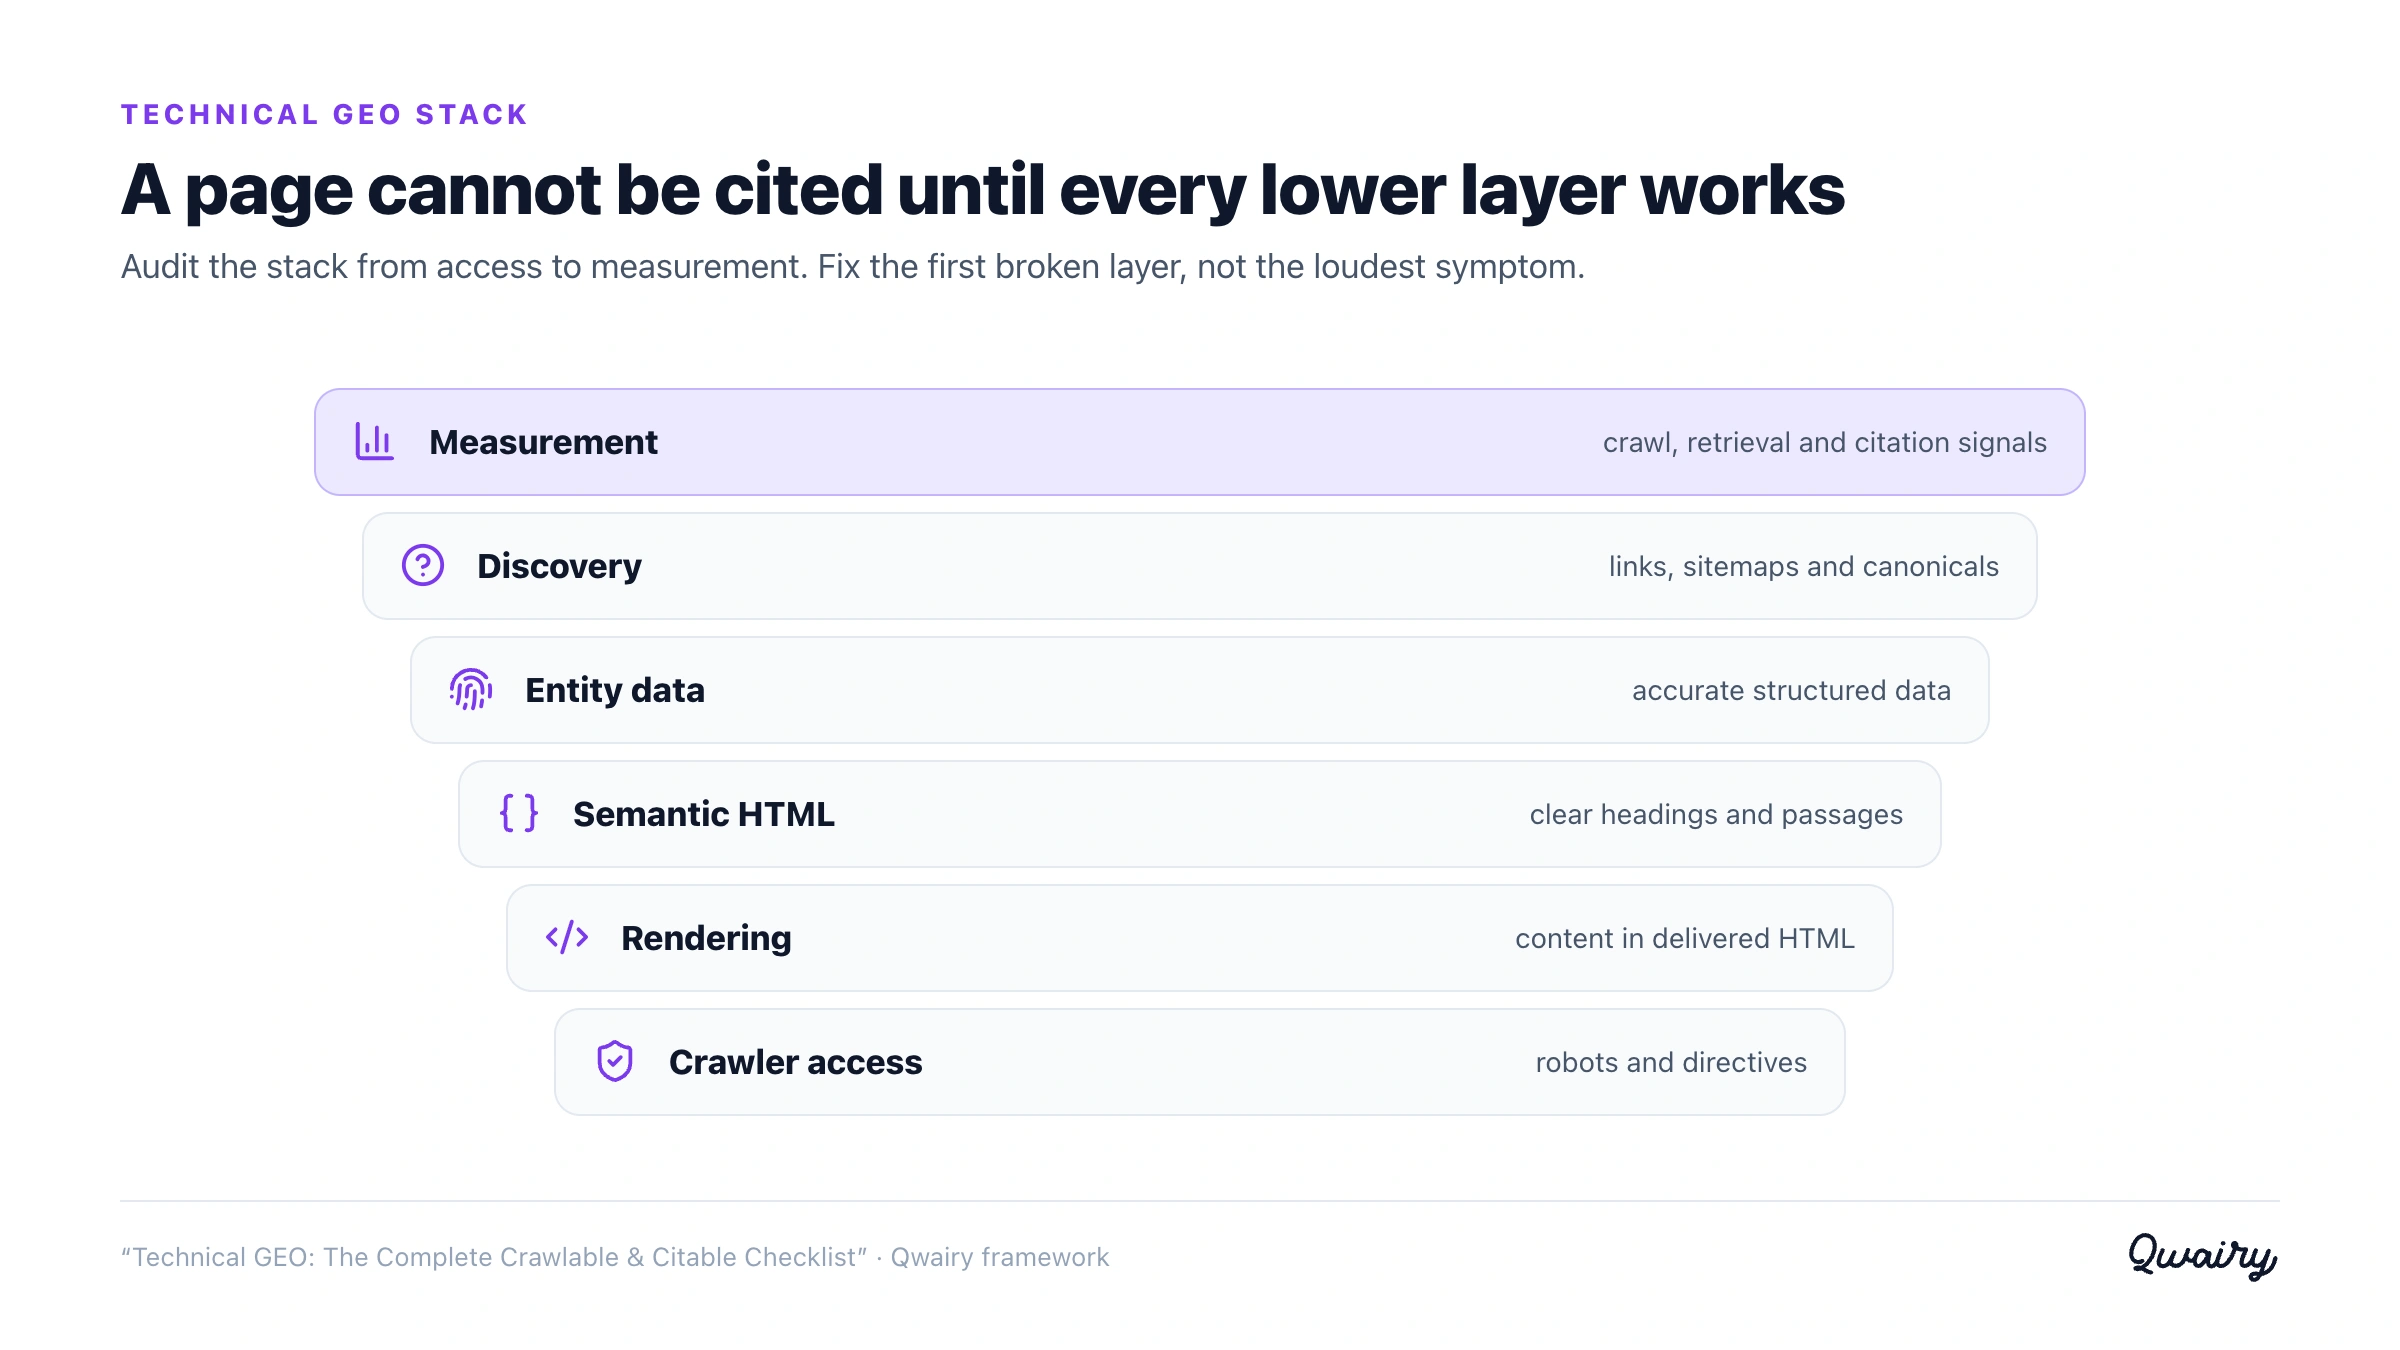
Utilisez ce tableau comme audit d’un coup d’œil ; les sections suivantes développent chaque ligne. Procédez de haut en bas : les problèmes d’accès rendent tout le reste caduc.
# | Couche | Ce qu’il faut vérifier | Guide approfondi |
1 | Accès des crawlers | Les user-agents d’IA ne sont bloqués ni dans `robots.txt` ni au niveau du WAF/CDN | |
2 | Rendu | Le contenu principal existe dans le HTML brut, pas seulement après l’exécution du JS | |
3 | HTML et vitesse | Balisage sémantique propre, réponses rapides, pas d’erreurs masquées | Ce guide |
4 | Données structurées | Balisage d’entité Organization, Article, Author, `sameAs` | |
5 | Découverte | Sitemaps XML, maillage interne, canoniques corrects | |
6 | `llms.txt` | Fichier-guide facultatif, avec des attentes réalistes |
Lancez un audit gratuit : en quelques minutes, ChatGPT, Gemini et Perplexity répondent en direct à 8 questions d’achat sur votre marché, et vous voyez qui ils recommandent.
Si les bots ne peuvent pas récupérer vos pages, rien d’autre dans cette liste n’a d’importance. Le premier audit porte toujours sur l’accès, et il a deux points de défaillance : votre robots.txt et vos règles en périphérie (CDN/WAF).
Les principaux user-agents d’IA sont documentés publiquement. La documentation des crawlers d’OpenAI distingue GPTBot, OAI-SearchBot et ChatGPT-User, respectivement pour l’entraînement, la recherche et les requêtes déclenchées par l’utilisateur. La documentation des crawlers d’Anthropic couvre ClaudeBot, Claude-SearchBot et Claude-User, y compris la façon d’autoriser ou de bloquer chaque agent. La documentation des crawlers de Perplexity couvre PerplexityBot et Perplexity-User pour l’indexation et les requêtes initiées par l’utilisateur. La documentation des crawlers de Google définit Google-Extended comme un jeton de contrôle pour l’entraînement de Gemini et de Vertex AI, sans effet sur l’indexation dans Search.
La nuance que la plupart des équipes manquent : bloquer les crawlers d’entraînement n’est pas gratuit. Pour les moteurs qui récupèrent en direct, être accessible est une condition préalable pour être cité. Interdire tous les bots d’IA pour protéger votre contenu peut aussi vous retirer des réponses que voient vos acheteurs. Décidez délibérément, agent par agent.
Une posture minimale et permissive ressemble à ceci :
User-agent: GPTBot
Allow: /

User-agent: OAI-SearchBot
Allow: /

User-agent: ClaudeBot
Allow: /

User-agent: PerplexityBot
Allow: /

Sitemap: https://www.example.com/sitemap.xml
Vérifiez ensuite en périphérie. Cloudflare, Akamai et les fournisseurs similaires proposent de plus en plus souvent un blocage des bots d’IA par défaut ou des règles gérées : un bot autorisé dans robots.txt peut donc quand même recevoir un 403 en amont. Examinez les vrais logs serveur, pas seulement le fichier. Le détail agent par agent se trouve dans Crawlers IA et robots.txt : lesquels autoriser ou bloquer.
Partez du principe que le crawler voit votre HTML brut, et rien de plus. Googlebot rend le JavaScript dans un second temps, mais de nombreux crawlers IA ne le font pas : l’analyse de Vercel sur le comportement des crawlers IA a constaté que les crawlers de ChatGPT et de Claude récupéraient les fichiers JavaScript sans les exécuter . Si votre titre, votre texte principal ou vos faits clés n’apparaissent qu’après l’hydratation d’un framework côté client, ces crawlers reçoivent une coquille vide. La solution consiste à servir un HTML significatif dès la première réponse :
Pour tester ce qu’un bot voit réellement, désactivez JavaScript dans votre navigateur, utilisez curl pour récupérer le HTML brut, ou consultez la fonction « afficher le HTML exploré » de l’inspection d’URL de Google. Si votre contenu principal manque dans cette source, il manque aussi pour l’IA. Le guide complet se trouve dans Rendu JavaScript et crawlers IA : pourquoi votre contenu peut être invisible.
La qualité de l’extraction suit la qualité du HTML. Un modèle qui cherche un passage citable s’en sort bien mieux avec un document clair qu’avec un fouillis de <div> imbriqués. Donnez-lui une structure à laquelle s’accrocher :
<h1> descriptif, puis une hiérarchie <h2>/<h3> logique qui reflète les questions auxquelles la page répond.<article>, <section>, <table>, <ul>) plutôt que des conteneurs génériques mis en forme.alt descriptif et des légendes, pour que les contenus non textuels restent lisibles.La vitesse et la fiabilité comptent aussi. Les crawlers qui disposent d’un budget limité abandonnent les réponses lentes, et des erreurs 5xx intermittentes ou des « soft 404 » (un statut 200 sur une page vide ou en erreur) peuvent discrètement faire sortir des pages de la sélection. Servez des réponses rapides et stables, avec les bons codes de statut. Surveillez les vraies 404 et les chaînes de redirections : chaque saut est une occasion, pour un crawler, de renoncer.
Vérifiez les règles de votre robots.txt, votre llms.txt et votre sitemap pour les crawlers IA avant de réécrire la moindre page.
Les données structurées transforment une page en faits auxquels un modèle peut se fier et qu’il peut attribuer. Le balisage schema.org ne garantit pas une citation, mais il lève l’ambiguïté sur qui vous êtes et sur la nature d’une page, ce dont les moteurs génératifs ont précisément besoin pour attribuer une affirmation à la bonne entité. Priorisez le balisage qui établit l’identité et le type de contenu :
sameAs vers vos profils officiels, qui rattachent votre marque à une entité unique et cohérente.author clair, datePublished et dateModified, pour signaler la fraîcheur et la paternité.sameAs afin de renforcer l’expertise (E-E-A-T).Validez tout avec le test des résultats enrichis de Google et le Schema Markup Validator : un JSON-LD invalide est pire que pas de JSON-LD. Pour le détail complet centré sur les entités (et sa différence avec le balisage FAQPage/HowTo propre à l’AEO), consultez Schema markup pour l’AEO : guide pratique du JSON-LD pour la recherche IA.
Les crawlers ont toujours besoin d’une carte et d’un ensemble d’URL propre. Trois signaux font l’essentiel du travail :
robots.txt. C’est le moyen le moins coûteux de faire remonter les pages nouvelles et mises à jour.L’architecture est un levier de citabilité, pas seulement d’exploration : une page bien reliée et autonome est plus facile à récupérer et à citer. Allez plus loin dans Architecture de site pour l’IA : rendre chaque page apte à répondre.
llms.txt est une proposition, pas un facteur de classement établi. La convention llms.txt suggère un fichier Markdown à la racine de votre site qui oriente les modèles vers vos contenus les plus importants et les plus propres. Il coûte peu et ne présente aucun risque à ajouter.
Soyons honnêtes sur son adoption, cependant : aucun grand moteur d’IA n’a confirmé publiquement qu’il utilise llms.txt pour classer ou citer des pages, et des voix influentes du search se sont montrées sceptiques à l’idée d’en faire un incontournable. Traitez-le comme une expérience peu coûteuse qui peut aider la découverte, pas comme un substitut à un HTML explorable et à des données structurées. Le raisonnement fondé sur les preuves est exposé dans llms.txt expliqué : faut-il vraiment l’ajouter à votre site ?.
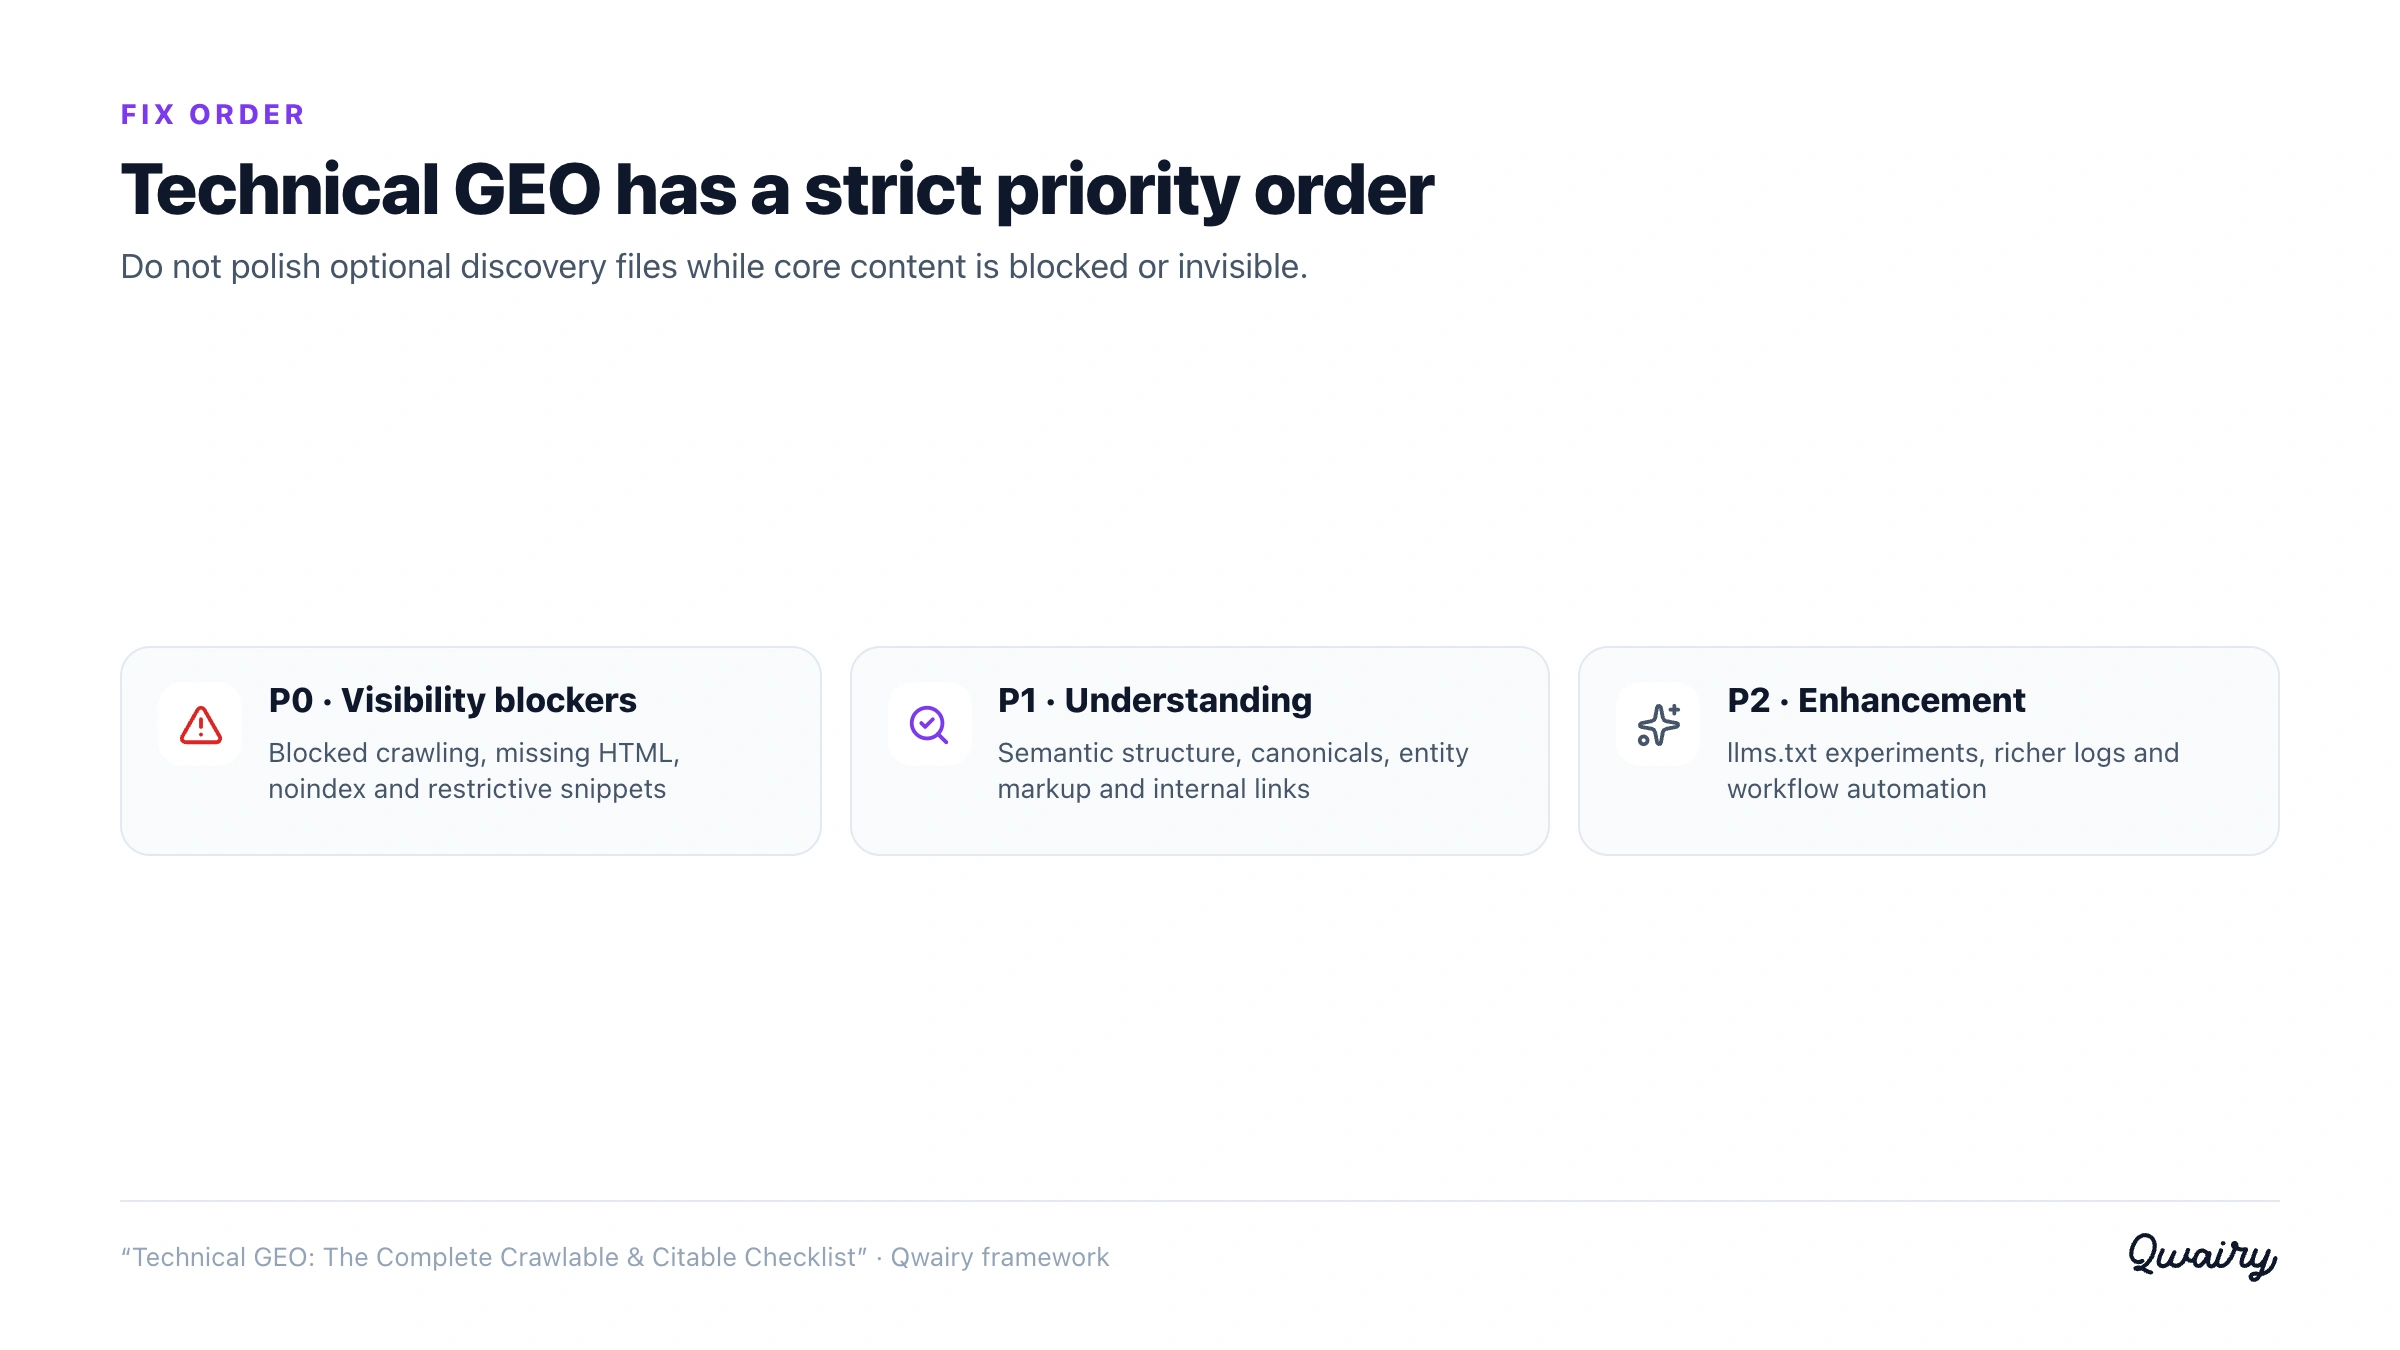
Suivez la checklist dans l’ordre : l’accès d’abord, la finition en dernier. Voici un passage reproductible :
robots.txt, vérifiez que les user-agents d’IA ne sont pas interdits, puis contrôlez les logs serveur et les règles en périphérie pour repérer d’éventuels 403 silencieux.curl. Le contenu principal est-il dans le HTML brut ?<h1> propre, d’une structure sémantique, de codes de statut corrects et de réponses rapides et stables.sameAs aboutissent.Cette dernière étape est celle où la mesure boucle la boucle. Qwairy suit votre visibilité et vos citations dans ChatGPT, Claude, Perplexity, Gemini et Google AI Overviews, surveille l’activité des crawlers IA sur votre site et fait ressortir les sources dont s’inspirent les moteurs, pour que vous sachiez si une correction technique vous a réellement fait entrer dans davantage de réponses. Corriger l’explorabilité ne vaut que si l’on en voit le résultat ; c’est la couche de mesure que fournit Qwairy.
Approfondissez la pile technique : configurez les crawlers IA dans robots.txt, testez le rendu JavaScript pour les crawlers IA, améliorez l’architecture de site pour la récupération par l’IA, et traitez llms.txt comme une expérience facultative plutôt que comme un raccourci de classement.
Le GEO technique n’a rien de glamour, et c’est précisément ce qui en fait un avantage. Pendant que vos concurrents courent après le volume de contenu, un site que les crawlers IA peuvent atteindre, rendre sans JavaScript, analyser comme du HTML propre et comprendre comme une entité cohérente se retrouve dans des réponses où les autres n’entrent jamais. Appliquez la checklist en six couches, corrigez l’accès en premier, et mesurez si chaque changement vous vaut davantage de citations. Les fondations se capitalisent : chaque tactique annexe fonctionne mieux dès que la plomberie est en ordre.
Le GEO technique est l’ensemble des pratiques techniques qui rendent un site web atteignable, lisible et interprétable par les crawlers et les modèles derrière les moteurs génératifs comme ChatGPT, Perplexity et Google AI Overviews. Il couvre l’accès des crawlers, le rendu, la qualité du HTML, les données structurées et les signaux de découverte : le socle sur lequel reposent le contenu et l’autorité.
Ils partagent des fondations, mais les consommateurs du GEO sont plus stricts. Au lieu d’un bot de recherche dominant, vous faites face à de nombreux crawlers IA aux finalités différentes, dont plusieurs n’exécutent pas JavaScript. Le GEO optimise aussi l’extraction propre de passages et l’attribution aux entités, pas seulement le classement : la structure et les réponses autonomes comptent donc davantage.
Seulement de façon délibérée. Bloquer les crawlers d’entraînement peut protéger le contenu, mais pour les moteurs qui récupèrent en direct, être accessible est une condition préalable pour être cité : un blocage général peut donc vous retirer discrètement des réponses IA que voient vos acheteurs. Décidez agent par agent plutôt que de tout interdire.
Souvent non. Googlebot rend le JavaScript dans un second temps, mais plusieurs crawlers IA récupèrent le HTML brut et n’exécutent que peu ou pas de JS ; un contenu rendu côté client peut donc leur être invisible. Servir du HTML rendu côté serveur ou statique, avec votre contenu principal dans la première réponse, est le choix par défaut le plus sûr.
Non. Le balisage schema ne force pas une citation, mais il lève l’ambiguïté sur votre identité et sur le type de votre contenu, ce qui aide les moteurs à attribuer les affirmations à la bonne entité. Priorisez les balisages Organization, Article, Author et sameAs, et validez-les toujours : un JSON-LD invalide peut faire plus de tort que son absence.
Suivez deux choses : l’activité des crawlers sur votre site (quels bots consultent quelles pages) et votre présence réelle dans les réponses IA (citations et part de voix sur les moteurs). Une plateforme comme Qwairy surveille les deux, pour que vous puissiez relier un changement technique à une évolution mesurable de la fréquence à laquelle les moteurs vous citent.
Suivez les questions qui comptent pour votre activité, voyez quelles marques chaque réponse mentionne et quelles sources elle cite, puis travaillez sur les manques.
Offre gratuite avec 120 crédits initiaux • Sans carte bancaire
Autres articles
How to Improve Your Brand Sentiment in ChatGPT and AI Search
Being mentioned by ChatGPT is not enough if it calls your products overpriced. A step-by-step process to analyze and improve how AI assistants talk about your brand, with Nike as an example.
Stratégie GEO : 5 vérités sur la recherche IA et un cadre en 4 étapes
Cinq vérités sur la recherche IA partagées au SEO & GEO Summit de Paris, et le cadre GEO en 4 étapes de Qwairy pour être recommandé par ChatGPT ou Gemini.