Loading page

Qu’est-ce que llms.txt, qui le prend en charge, et améliore-t-il votre visibilité IA ? Un guide honnête, avec les étapes de création et des attentes réalistes.
Tous les quelques mois, un nouveau fichier « adapté à l’IA » promet d’être celui qui fera lire, comprendre et citer votre site par ChatGPT, Perplexity et les réponses IA de Google. En ce moment, ce fichier s’appelle llms.txt : une proposition de standard en markdown qui donne aux grands modèles de langage une carte claire et soignée de vos contenus les plus importants. L’argument séduit : un seul fichier à la racine de votre site, et soudain les moteurs d’IA « comprennent » votre site. La réalité est plus nuancée. llms.txt est une proposition réelle et bien pensée, mais son adoption du côté qui compte le plus, celui des fournisseurs d’IA eux-mêmes, reste mince. La vraie question n’est donc pas « llms.txt est-il une bonne idée ? », mais « devez-vous y consacrer un après-midi, et que pouvez-vous honnêtement en attendre ? » Cet article vous donne une réponse franche : ce qu’est vraiment llms.txt, le problème qu’il cherche à résoudre, qui le prend en charge aujourd’hui (et qui ne le fait pas), une marche à suivre pour en créer un, et un regard lucide sur l’écart entre l’effet d’annonce et le gain réel.
llms.txt est une proposition de standard pour un fichier markdown, placé à la racine de votre domaine, qui donne aux modèles de langage un guide concis et soigné de votre site. Il a été présenté en septembre 2024 par Jeremy Howard, cofondateur d’Answer.AI , et la spécification se trouve sur llmstxt.org . L’idée de départ est simple. Une page HTML brute est bruyante : navigation, publicités, bandeaux de cookies, scripts, éléments répétitifs. Les modèles de langage travaillent avec des fenêtres de contexte limitées ; leur fournir la page rendue en entier est donc un gaspillage, et une source d’erreurs. llms.txt se veut un sommaire choisi à la main, en markdown propre : voici mes pages clés, voici ce que chacune couvre, voici où en lire davantage. Il est important de situer llms.txt par rapport aux deux fichiers que tout le monde connaît déjà :
Fichier | Rôle | Qui le lit aujourd’hui |
`robots.txt` | Permissions : quels crawlers peuvent accéder à quoi | Largement respecté par les crawlers des moteurs de recherche et de l’IA |
`sitemap.xml` | Découverte : une liste de toutes les URL, lisible par les machines | Largement utilisé par les moteurs de recherche |
`llms.txt` | Curation : un guide des contenus clés, choisi par des humains et adapté aux LLM | Proposition ; support côté consommateurs encore limité |
La distinction compte : robots.txt concerne la permission, sitemap.xml la découverte, et llms.txt la compréhension. Il n’accorde ni ne refuse l’accès, et il n’a pas vocation à lister toutes les URL : c’est une présélection éditoriale.
La spécification définit une structure markdown légère et prévisible, facile à écrire à la main. Elle s’ouvre sur un H1 avec le nom du site, un résumé facultatif en citation, puis des sections H2 contenant des listes de liens accompagnés de courtes descriptions : Un exemple complet, prêt à copier, figure à la fin de cet article. Il reprend le nom du site, le résumé et les sections de liens. Il existe aussi une convention complémentaire, llms-full.txt, qui intègre le contenu même de ces pages dans un seul long fichier markdown. C’est utile lorsqu’un outil veut le texte complet en une seule requête plutôt que de suivre les liens.
llms.txt existe parce que le HTML est un mauvais format de livraison pour des machines qui lisent en tokens, pas en pixels. Lorsqu’un système d’IA essaie de comprendre une page, il doit écarter la mise en page, les scripts et le bruit pour trouver l’essentiel, et il le fait souvent de façon imparfaite, surtout sur les sites qui reposent beaucoup sur JavaScript. Un condensé markdown soigné contourne ce travail. Il dit en substance : ne devinez pas ce qui compte sur mon site, voici la présélection, déjà nettoyée. Pour les produits riches en documentation, les outils pour développeurs et les bases de connaissances, c’est réellement précieux, en particulier pour les systèmes de génération augmentée par récupération (RAG) et les assistants de code IA que vous-même ou vos partenaires pointez directement vers le fichier. Ce dernier point résume honnêtement la valeur de llms.txt aujourd’hui : il est le plus clairement utile dans les contextes où quelqu’un choisit délibérément de le consommer : un pipeline RAG interne, un agent que vous avez construit, une plateforme de documentation qui l’ingère. Il est bien moins éprouvé comme signal passif que les moteurs d’IA publics détecteraient d’eux-mêmes.
Lancez un audit gratuit : en quelques minutes, ChatGPT, Gemini et Perplexity répondent en direct à 8 questions d’achat sur votre marché, et vous voyez qui ils recommandent.
llms.txt est passé d’une proposition de niche à une convention émergente, mais ce n’est pas la même chose qu’une récupération confirmée par les grands moteurs de réponse. La spécification d’origine se décrit toujours comme une proposition pour aider les LLM à utiliser un site au moment de l’inférence. Le support côté éditeurs est significatif :
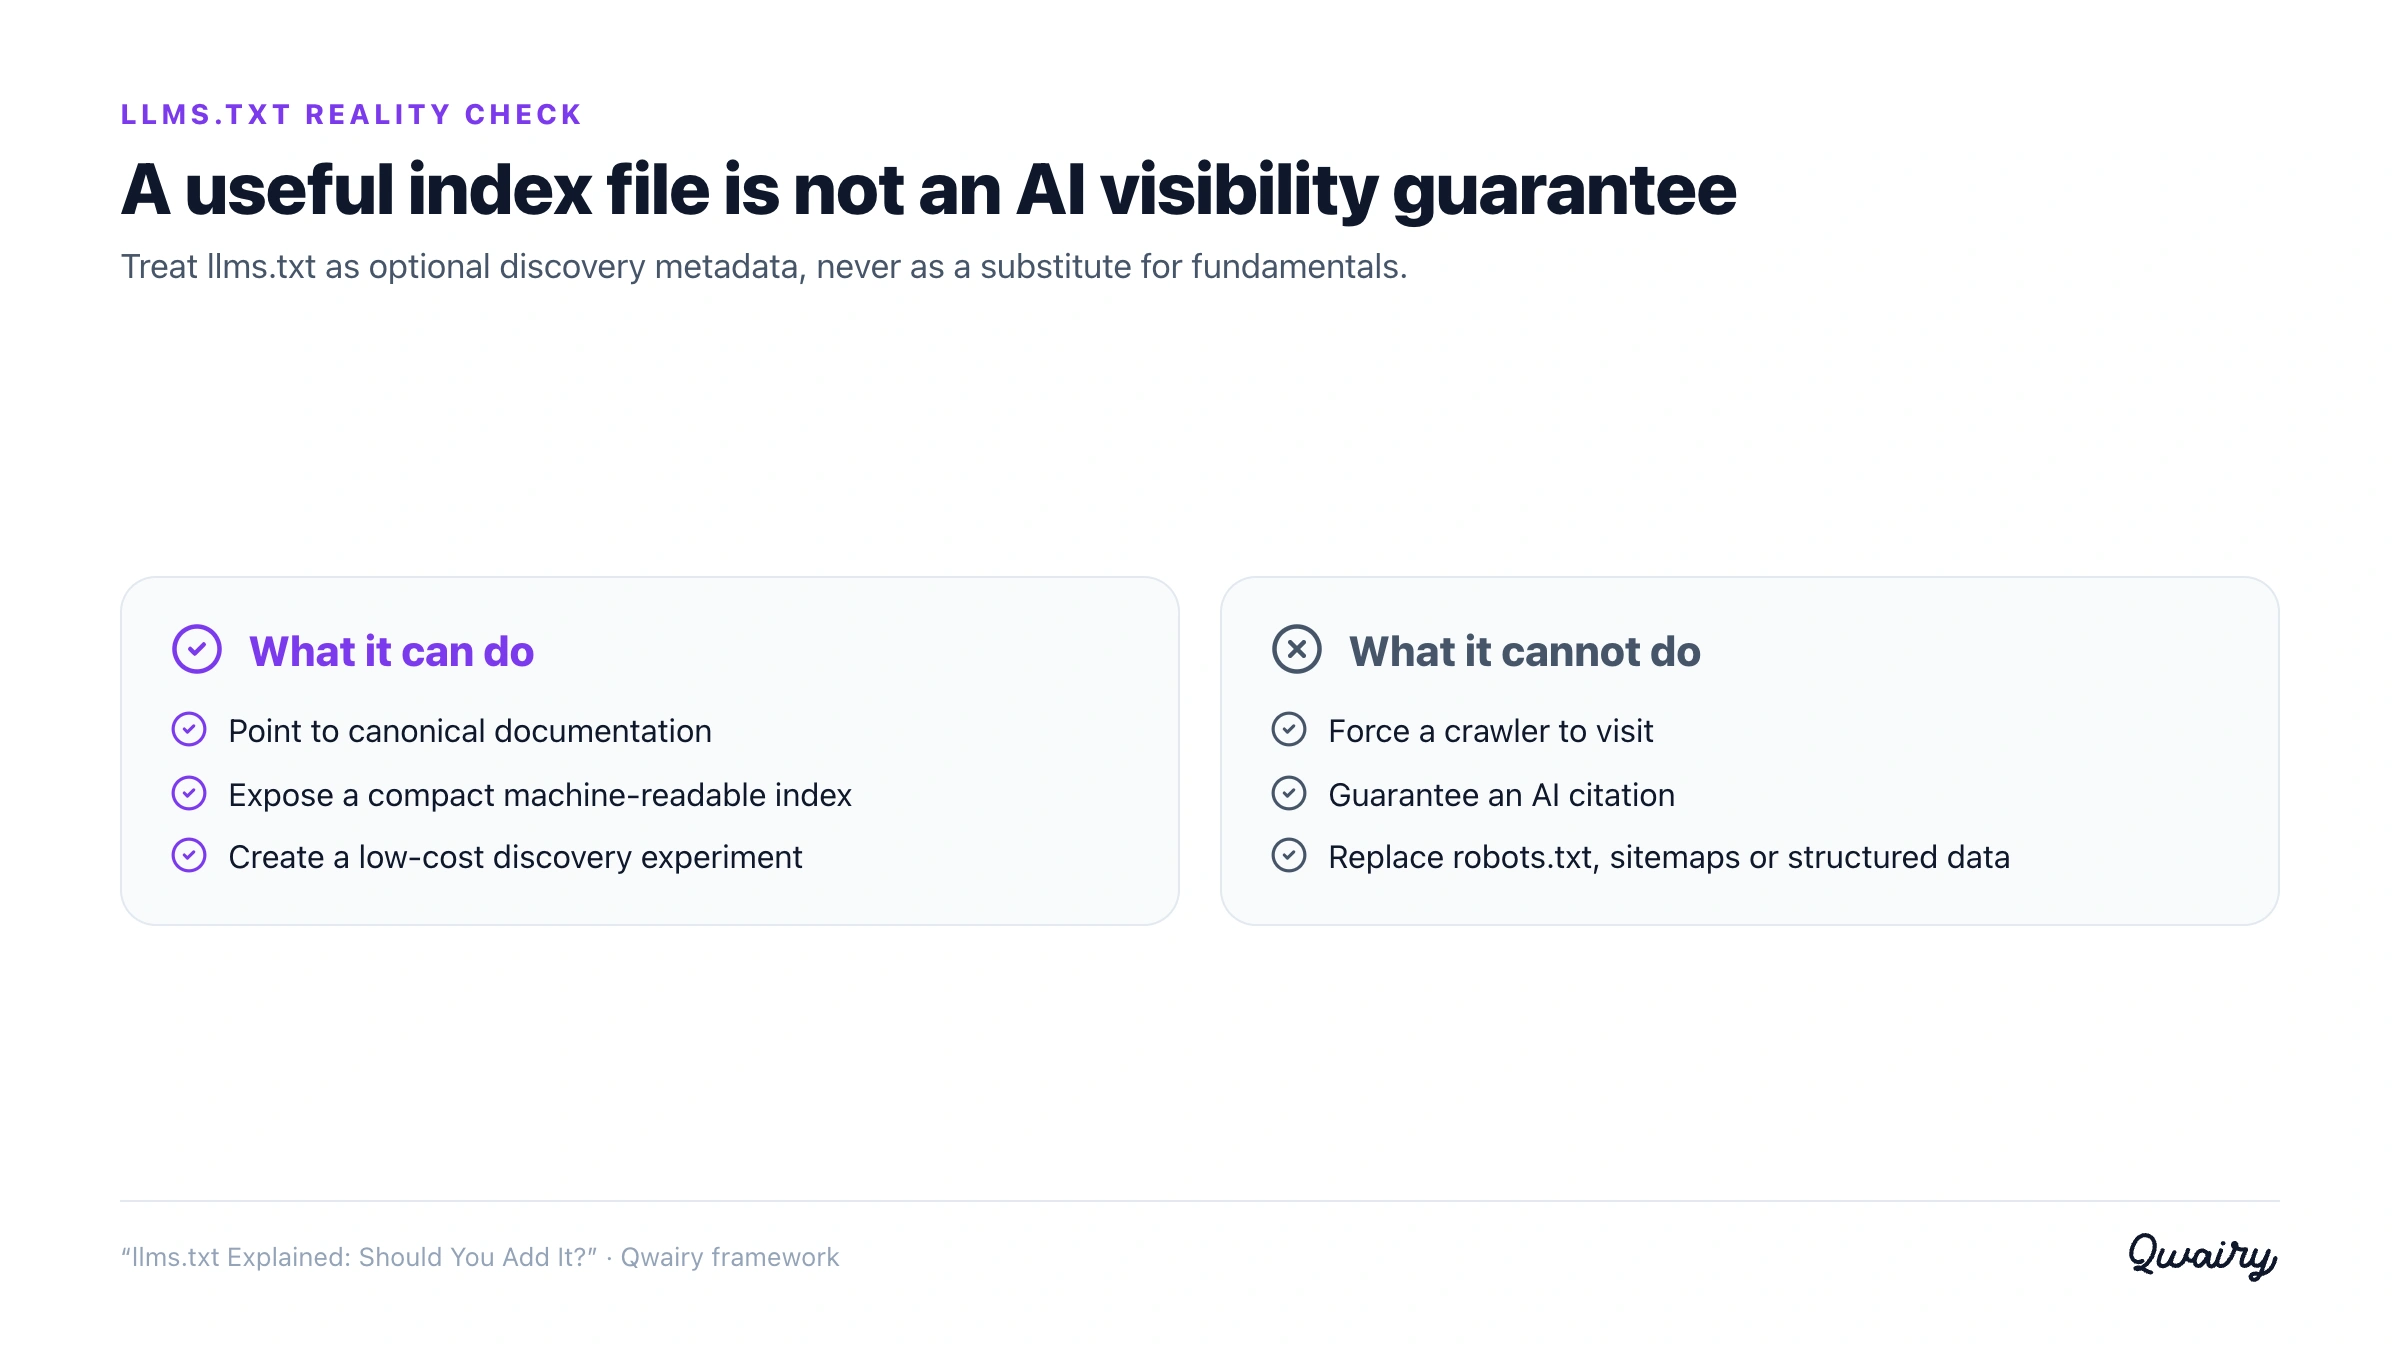
llms.txt et llms-full.txt.Côté consommateurs, les preuves restent limitées. OpenAI, Anthropic et Perplexity ne se sont pas engagés publiquement à utiliser llms.txt comme signal de citation ou de récupération. Google est explicite : son guide des fonctionnalités d’IA générative dans la recherche indique que Google Search n’utilise pas llms.txt, et que maintenir ce fichier n’aide ni ne nuit à la visibilité ou au classement dans la recherche, dans AI Overviews ou dans AI Mode.
Le bilan honnête : llms.txt bénéficie désormais d’un support crédible côté outils et d’un cas d’usage plus clair pour la découverte par les agents, mais rien ne prouve qu’il améliore la visibilité organique dans les grands moteurs de réponse.
Il n’existe toujours aucune preuve publique que l’ajout de llms.txt améliore les citations ou la visibilité dans ChatGPT, Claude, Perplexity, Gemini, Google AI Overviews ou AI Mode. Le support de Lighthouse valide le fichier comme convention facultative de navigation agentique ; il n’en fait pas un signal de classement dans la recherche. Cela ne rend pas le fichier inutile. Sa valeur est plus étroite, et plus facile à défendre :
Le coût est faible : une mise en œuvre propre peut donc constituer une expérience raisonnable. Présentez-la honnêtement comme une expérience, et mesurez les requêtes des crawlers et les résultats en citations au lieu de promettre un gain de classement.
Si vous décidez d’en ajouter un, faites-le correctement et gardez-le à jour : un llms.txt périmé est pire que pas de llms.txt, car il égare activement. Voici une marche à suivre simple et peu coûteuse.
https://yourdomain.com/llms.txt en texte brut ou markdown, accessible publiquement, sans mur d’authentification./llms.txt, accessible publiquementllms-full.txt facultatif pour les consommateurs de texte complet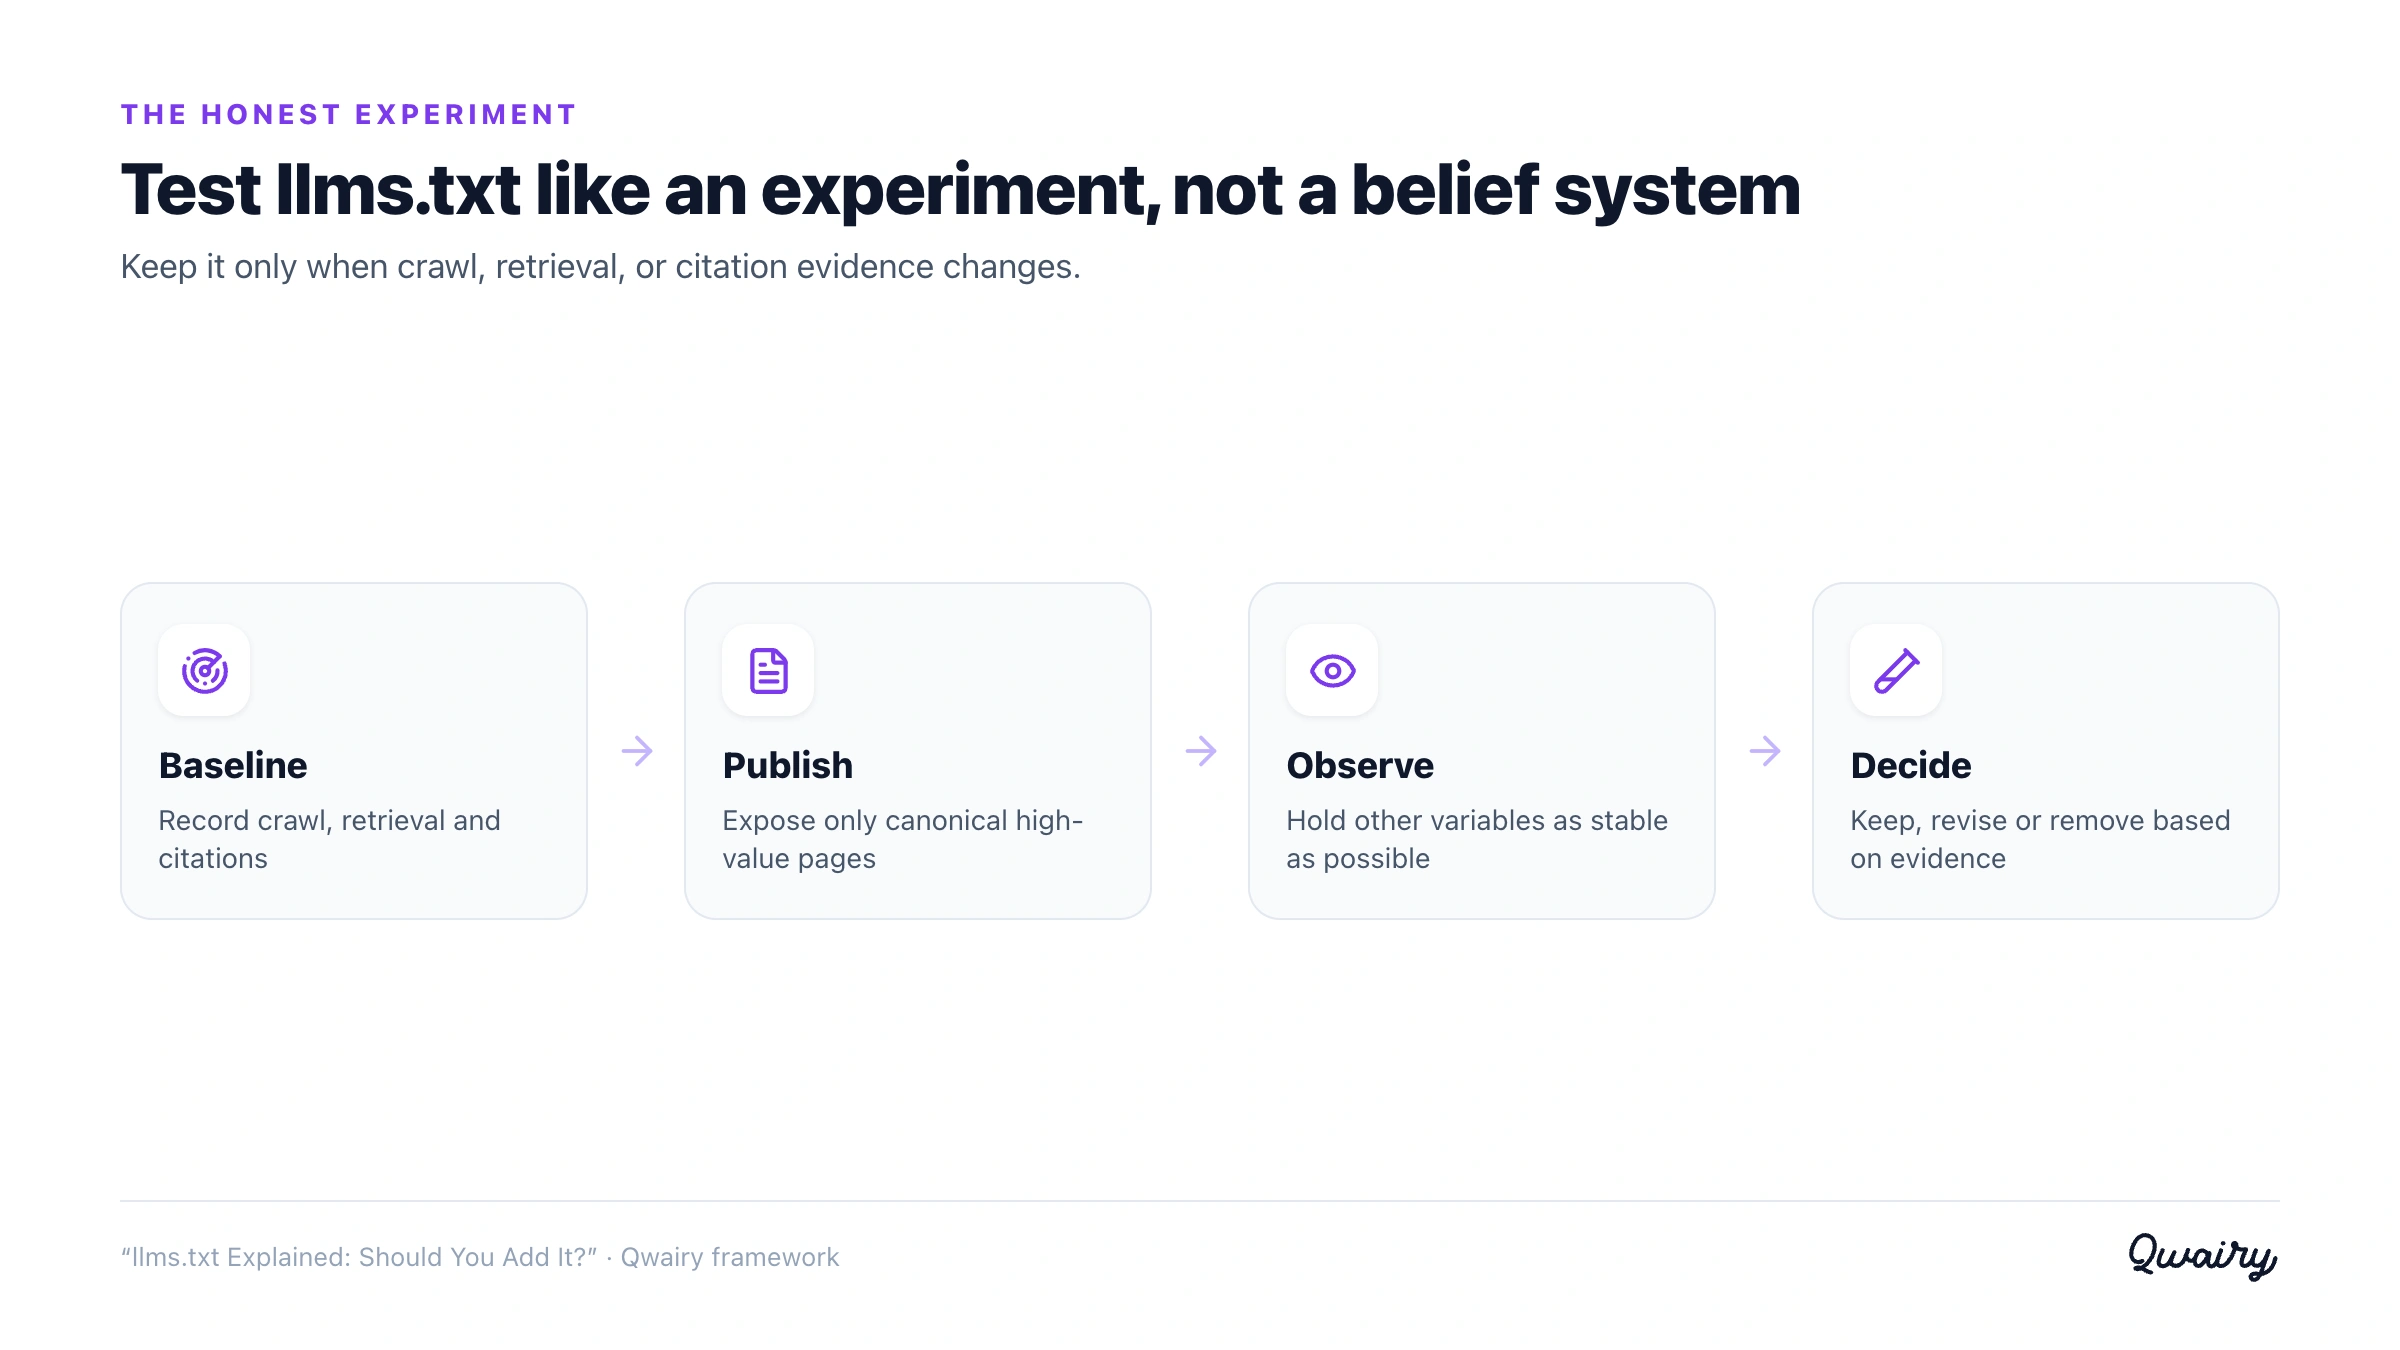
Si vous mettez en place llms.txt, testez-le comme un changement de produit au lieu de déclarer le succès dès que le fichier renvoie un code 200.
/llms.txt, les visites de crawlers sur les pages liées, les citations IA et les URL citées.L’expérience ne peut pas prouver la causalité dans tous les moteurs externes, mais elle évite l’erreur la plus courante : traiter l’adoption d’un fichier comme la preuve d’un effet sur la visibilité.
Vérifiez les règles de votre robots.txt, votre llms.txt et votre sitemap pour les crawlers IA avant de réécrire la moindre page.
Considérez llms.txt comme une expérience peu coûteuse et peu risquée, pas comme une stratégie de croissance. Les leviers durables de la visibilité IA sont peu glamour et bien connus : être explorable, structurer le contenu pour que les réponses soient faciles à extraire, bâtir une vraie autorité et une identité d’entité claire, garder vos contenus à jour, et obtenir des citations sur des sources tierces. Un fichier markdown à la racine ne change rien à ces fondamentaux. La discipline la plus importante ici, c’est la mesure. Comme les fournisseurs d’IA n’ont pas confirmé s’ils utilisent llms.txt, ne croyez personne sur parole, y compris cet article, quant à son effet sur votre site. Observez ce qui se passe réellement : les crawlers IA demandent-ils le fichier, et votre part de citations évolue-t-elle après sa mise en ligne ? C’est exactement le type de signal avant/après pour lequel existe une plateforme de suivi. Qwairy suit la présence de votre marque dans ChatGPT, Claude, Perplexity, Gemini et Google AI Overviews, y compris les sources citées et le comportement des crawlers IA sur votre site, pour que vous puissiez tester un changement comme l’ajout de llms.txt à l’aide de données réelles de visibilité et de citations, au lieu d’espérer. Si cela corrèle avec davantage de citations, tant mieux. Sinon, vous aurez passé un après-midi et appris quelque chose de concret.
Priorisez d’abord les fondations éprouvées : passez en revue la checklist GEO technique, rendez vos pages clés découvrables grâce à une architecture de site pensée pour l’IA, et configurez l’accès des crawlers IA avant de traiter llms.txt comme une expérience.
llms.txt est une proposition intelligente et bien intentionnée pour un problème bien réel : les systèmes d’IA peinent à lire du HTML encombré, et un guide markdown soigné en est une solution élégante. Mais le standard ne fonctionne que si les consommateurs l’adoptent, et aujourd’hui les grands moteurs d’IA n’ont pas confirmé qu’ils le font. Ajoutez-le si cela vous coûte peu, surtout si vous avez de la documentation et que votre plateforme le génère automatiquement. Gardez-le exact. Et ne confondez pas la mise en ligne d’un fichier avec l’obtention de visibilité. Ce qui vous fait citer par l’IA reste les mêmes fondamentaux qu’avant ; llms.txt n’est, au mieux, qu’un petit complément facultatif. Mesurez, ne supposez pas.
Non. C’est une proposition de la communauté publiée sur llmstxt.org, présentée par Jeremy Howard en septembre 2024. Elle dispose d’une spécification claire et d’un nombre croissant de sites qui l’appliquent, mais aucun organisme de normalisation ne l’a ratifiée et les grands fournisseurs d’IA ne l’ont pas validée comme protocole officiel.
Google indique explicitement que Search n’utilise pas llms.txt. OpenAI, Anthropic et Perplexity n’ont pas confirmé publiquement que leurs systèmes l’utilisent pour la récupération, l’ancrage des réponses ou l’entraînement. Certaines analyses indépendantes suggèrent que les grands crawlers IA demandent rarement le fichier. Considérez tout bénéfice de visibilité en dehors de Google comme non démontré, et mesurez-le comme une expérience.
Ils résolvent des problèmes différents. robots.txt contrôle la permission (quels crawlers peuvent accéder à quels chemins) et il est largement respecté. llms.txt concerne la compréhension : un guide de vos meilleurs contenus, choisi par des humains, à destination des modèles de langage. L’un filtre l’accès ; l’autre cherche à faciliter la compréhension.
C’est un fichier complémentaire qui intègre le texte complet de vos pages clés dans un seul document markdown, au lieu de simplement les référencer par des liens. Il est pratique lorsqu’un outil consommateur veut tout récupérer en une seule requête. De nombreuses plateformes de documentation peuvent le générer automatiquement en même temps que llms.txt.
Rien ne prouve aujourd’hui qu’il améliore directement le classement ou les citations IA. Votre visibilité dépend toujours de l’explorabilité, de la structure du contenu, de l’autorité, de la fraîcheur et des citations hors de votre site. llms.txt est un complément facultatif et peu coûteux, pas un substitut à ces fondamentaux.
Mesurez avant et après. Regardez dans vos logs si les crawlers IA demandent réellement /llms.txt, et suivez l’évolution de votre part de citations dans les réponses IA après sa publication. Comme les fournisseurs n’ont pas confirmé son utilisation, un vrai suivi, et non les promesses des éditeurs, est la seule façon honnête de juger de l’impact sur votre site.
# Votre entreprise

> Un résumé en une ligne de ce que fait votre site ou votre produit.

## Docs

- [Premiers pas](https://example.com/docs/start): Installation et premières étapes
- [Référence de l’API](https://example.com/docs/api): Endpoints et authentification

## Guides

- [Tarifs](https://example.com/pricing): Offres et limites
Suivez les questions qui comptent pour votre activité, voyez quelles marques chaque réponse mentionne et quelles sources elle cite, puis travaillez sur les manques.
Offre gratuite avec 120 crédits initiaux • Sans carte bancaire
Autres articles
How to Improve Your Brand Sentiment in ChatGPT and AI Search
Being mentioned by ChatGPT is not enough if it calls your products overpriced. A step-by-step process to analyze and improve how AI assistants talk about your brand, with Nike as an example.
Stratégie GEO : 5 vérités sur la recherche IA et un cadre en 4 étapes
Cinq vérités sur la recherche IA partagées au SEO & GEO Summit de Paris, et le cadre GEO en 4 étapes de Qwairy pour être recommandé par ChatGPT ou Gemini.