Loading page

Guide pour bâtir le graphe de connaissances de votre marque : sources d’entités, construction pas à pas, plan de mise en œuvre, test de recette et mesure.
Pendant dix ans, l’enjeu était de classer une page. Désormais, l’enjeu est d’être compris. Quand quelqu’un interroge ChatGPT, Perplexity ou les AI Overviews de Google sur votre catégorie, le modèle ne renvoie pas dix liens : il compose une réponse et décide quelles marques sont des entités réelles et crédibles, dignes d’être nommées. Cette décision s’appuie sur des connaissances structurées à propos de choses, et non sur des chaînes de mots-clés. Ces connaissances structurées forment un graphe de connaissances. Google a popularisé l’idée en 2012 avec le lancement de son Knowledge Graph , une carte des entités (personnes, entreprises, produits, lieux) et des relations qui les unissent. Aujourd’hui, cette même couche d’entités, complétée par des sources ouvertes comme Wikidata et Wikipedia, façonne discrètement ce que les moteurs génératifs disent de vous. Si votre marque n’est pas une entité bien définie, l’IA a deux options : vous ignorer ou deviner. Aucune n’est bonne. Quand elle devine, vous vous retrouvez confondu avec une entreprise au nom proche, décrit avec un slogan périmé ou crédité au mauvais fondateur. Ce guide se concentre sur la mise en œuvre : transformer les faits canoniques de votre marque en un graphe first-party maintenu dans le temps, publier ces relations de façon cohérente, rapprocher les identifiants externes et surveiller les dérives. Pour la discipline plus large qui consiste à gagner la reconnaissance de votre entité sur le web, reportez-vous au guide du SEO d’entités pour l’IA.
Un graphe de connaissances est une base de données d’entités et de leurs attributs vérifiés, reliées entre elles par des relations : c’est la différence entre « une suite de lettres qui épelle le nom de votre marque » et « une entreprise connue, avec un fondateur, une catégorie, un siège et un site web ». Google l’a résumé ainsi : « des choses, pas des chaînes de caractères ». Une entité possède une identité stable, qui persiste d’une mention, d’une langue et d’une orthographe à l’autre. Pour les systèmes d’IA, cela compte plus que jamais pour la recherche classique. Une liste de liens bleus classés tolère l’ambiguïté : l’internaute lève le doute en cliquant. Une réponse générée, non. Le modèle doit s’engager sur une seule interprétation de « qui est cette marque » avant d’écrire la moindre phrase. Des données d’entité claires réduisent le risque de cet engagement ; des données rares ou contradictoires l’augmentent.
On emploie souvent ces deux termes l’un pour l’autre, mais ils ne désignent pas la même chose. Le Knowledge Graph est la base de données d’entités sous-jacente. Le panneau de connaissances est l’encadré qui s’affiche à droite des résultats Google (ou en haut sur mobile) lorsque Google est sûr d’avoir compris une entité : il présente votre logo, votre description, votre date de création, vos profils sociaux, etc. Un panneau de connaissances est en somme un reçu visible qui prouve que Google vous a modélisé comme une entité distincte. Il n’est pas nécessaire d’avoir un panneau pour exister dans le graphe, mais en obtenir un est un indice solide que vos données d’entité sont cohérentes et bien sourcées.
Les moteurs génératifs s’ancrent dans des données d’entités, qu’ils le disent ou non. Les AI Overviews de Google et Gemini s’appuient sur la même infrastructure de recherche et de Knowledge Graph que les résultats traditionnels. Google décrit les AI Overviews comme construits sur ses systèmes de classement principaux, même si le poids exact du Knowledge Graph n’est pas détaillé publiquement. Des moteurs comme ChatGPT et Perplexity s’appuient fortement sur les références d’entités canoniques du web ouvert, avant tout Wikipedia et Wikidata, parce que ce sont des sources denses, structurées et largement reconnues du « qui est qui ». À retenir en pratique : plus votre marque est décrite de façon cohérente dans les sources auxquelles ces systèmes font confiance, plus ils vous nommeront avec assurance, vous décriront avec exactitude et vous citeront.
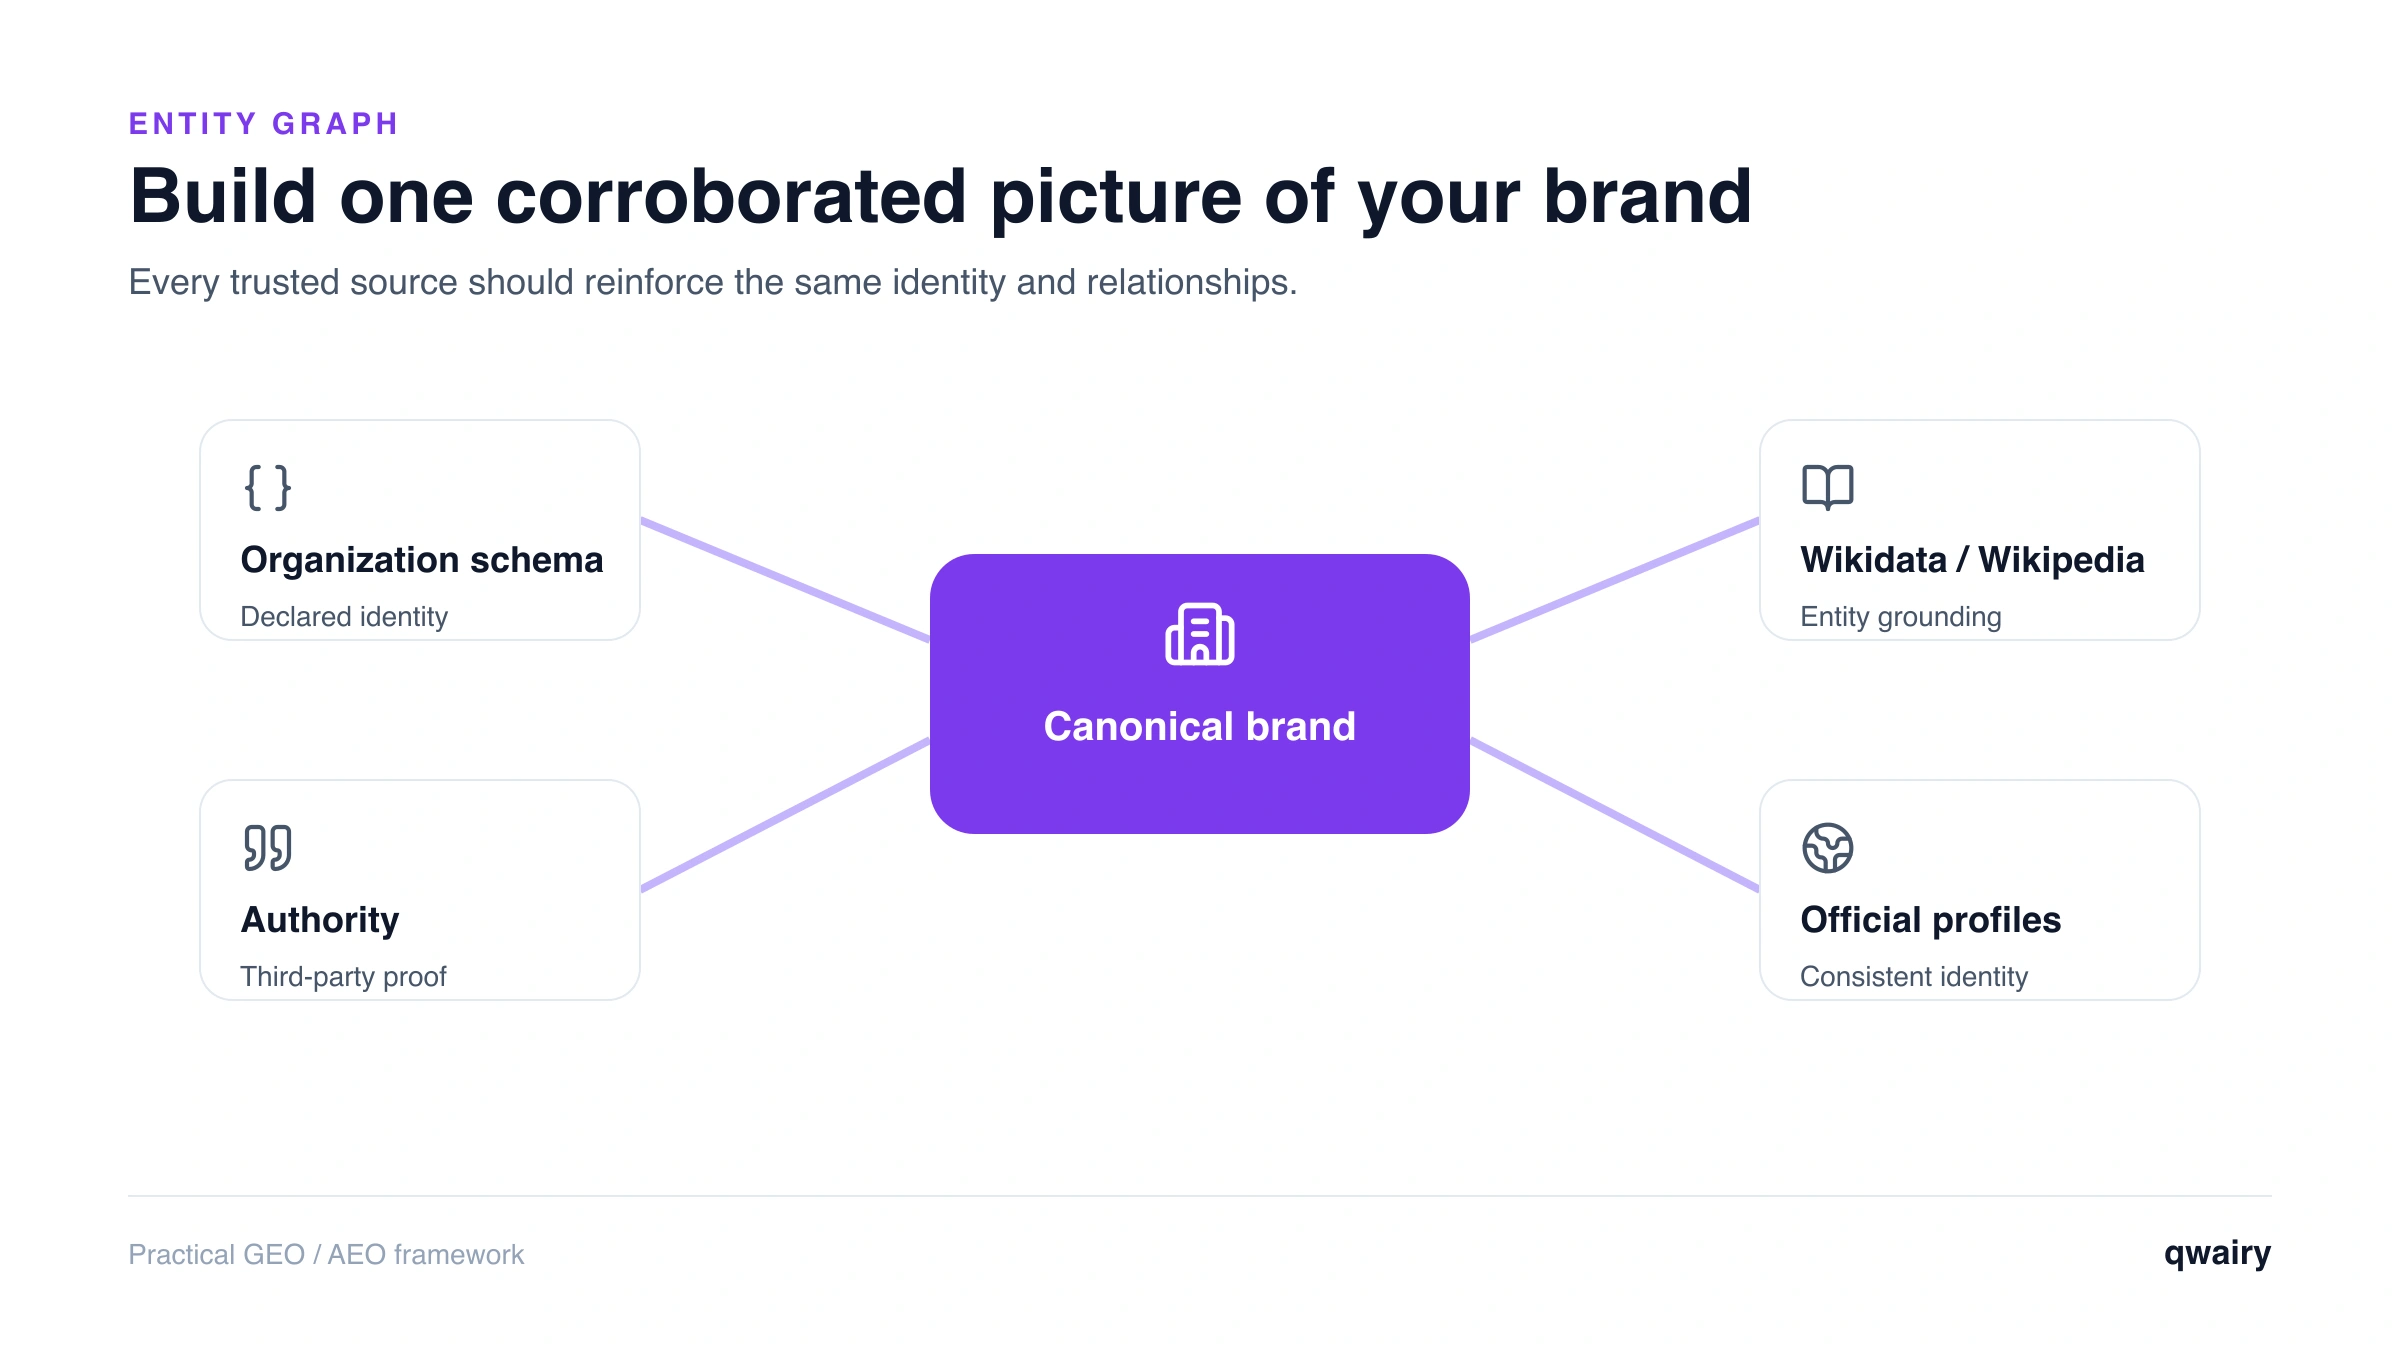
Aucune action isolée ne crée une entité. Un graphe de connaissances s’assemble à partir de signaux qui se corroborent, issus de sources indépendantes et faisant autorité. Voici celles qui pèsent le plus.
sameAs qui pointe vers vos profils officiels. C’est vous qui dites au graphe, en termes lisibles par les machines, de quelle entité il s’agit exactement.Traitez cela comme un programme de construction d’entité, et non comme une tâche ponctuelle. Chaque étape corrobore les autres ; l’effet cumulatif est tout l’intérêt. Suivez-les dans l’ordre.
sameAs. Sur votre page d’accueil, publiez des données structurées Organization comprenant votre raison sociale, votre logo et un tableau sameAs qui renvoie à chacun de vos profils officiels (Wikipedia, Wikidata, LinkedIn, Crunchbase, comptes sociaux). Validez-les avec le Rich Results Test de Google. C’est le signal le moins coûteux et le plus rapide, et vous le maîtrisez entièrement.Lancez un audit gratuit : en quelques minutes, ChatGPT, Gemini et Perplexity répondent en direct à 8 questions d’achat sur votre marché, et vous voyez qui ils recommandent.
Avant de considérer la base comme posée, vérifiez que chacun des points ci-dessous renvoie la même réponse :
sameAs complet ?L’actif décisif n’est pas un profil public de plus, mais un système de référence gouverné que toutes vos surfaces publiques peuvent réutiliser. Construisez le graphe minimum viable autour d’identifiants stables et de relations explicites.
organization → owns → product, person → founded → organization et organization → locatedIn → place. Ajoutez des dates d’effet pour qu’un ancien dirigeant ou un produit abandonné ne reste pas d’actualité indéfiniment.sameAs renvoie à la bonne entité et testez des prompts à risque pour repérer des faits périmés ou des confusions.C’est ce modèle d’exploitation qui distingue un graphe de connaissances de marque entretenu d’une liste de contrôle de SEO d’entités faite une seule fois.
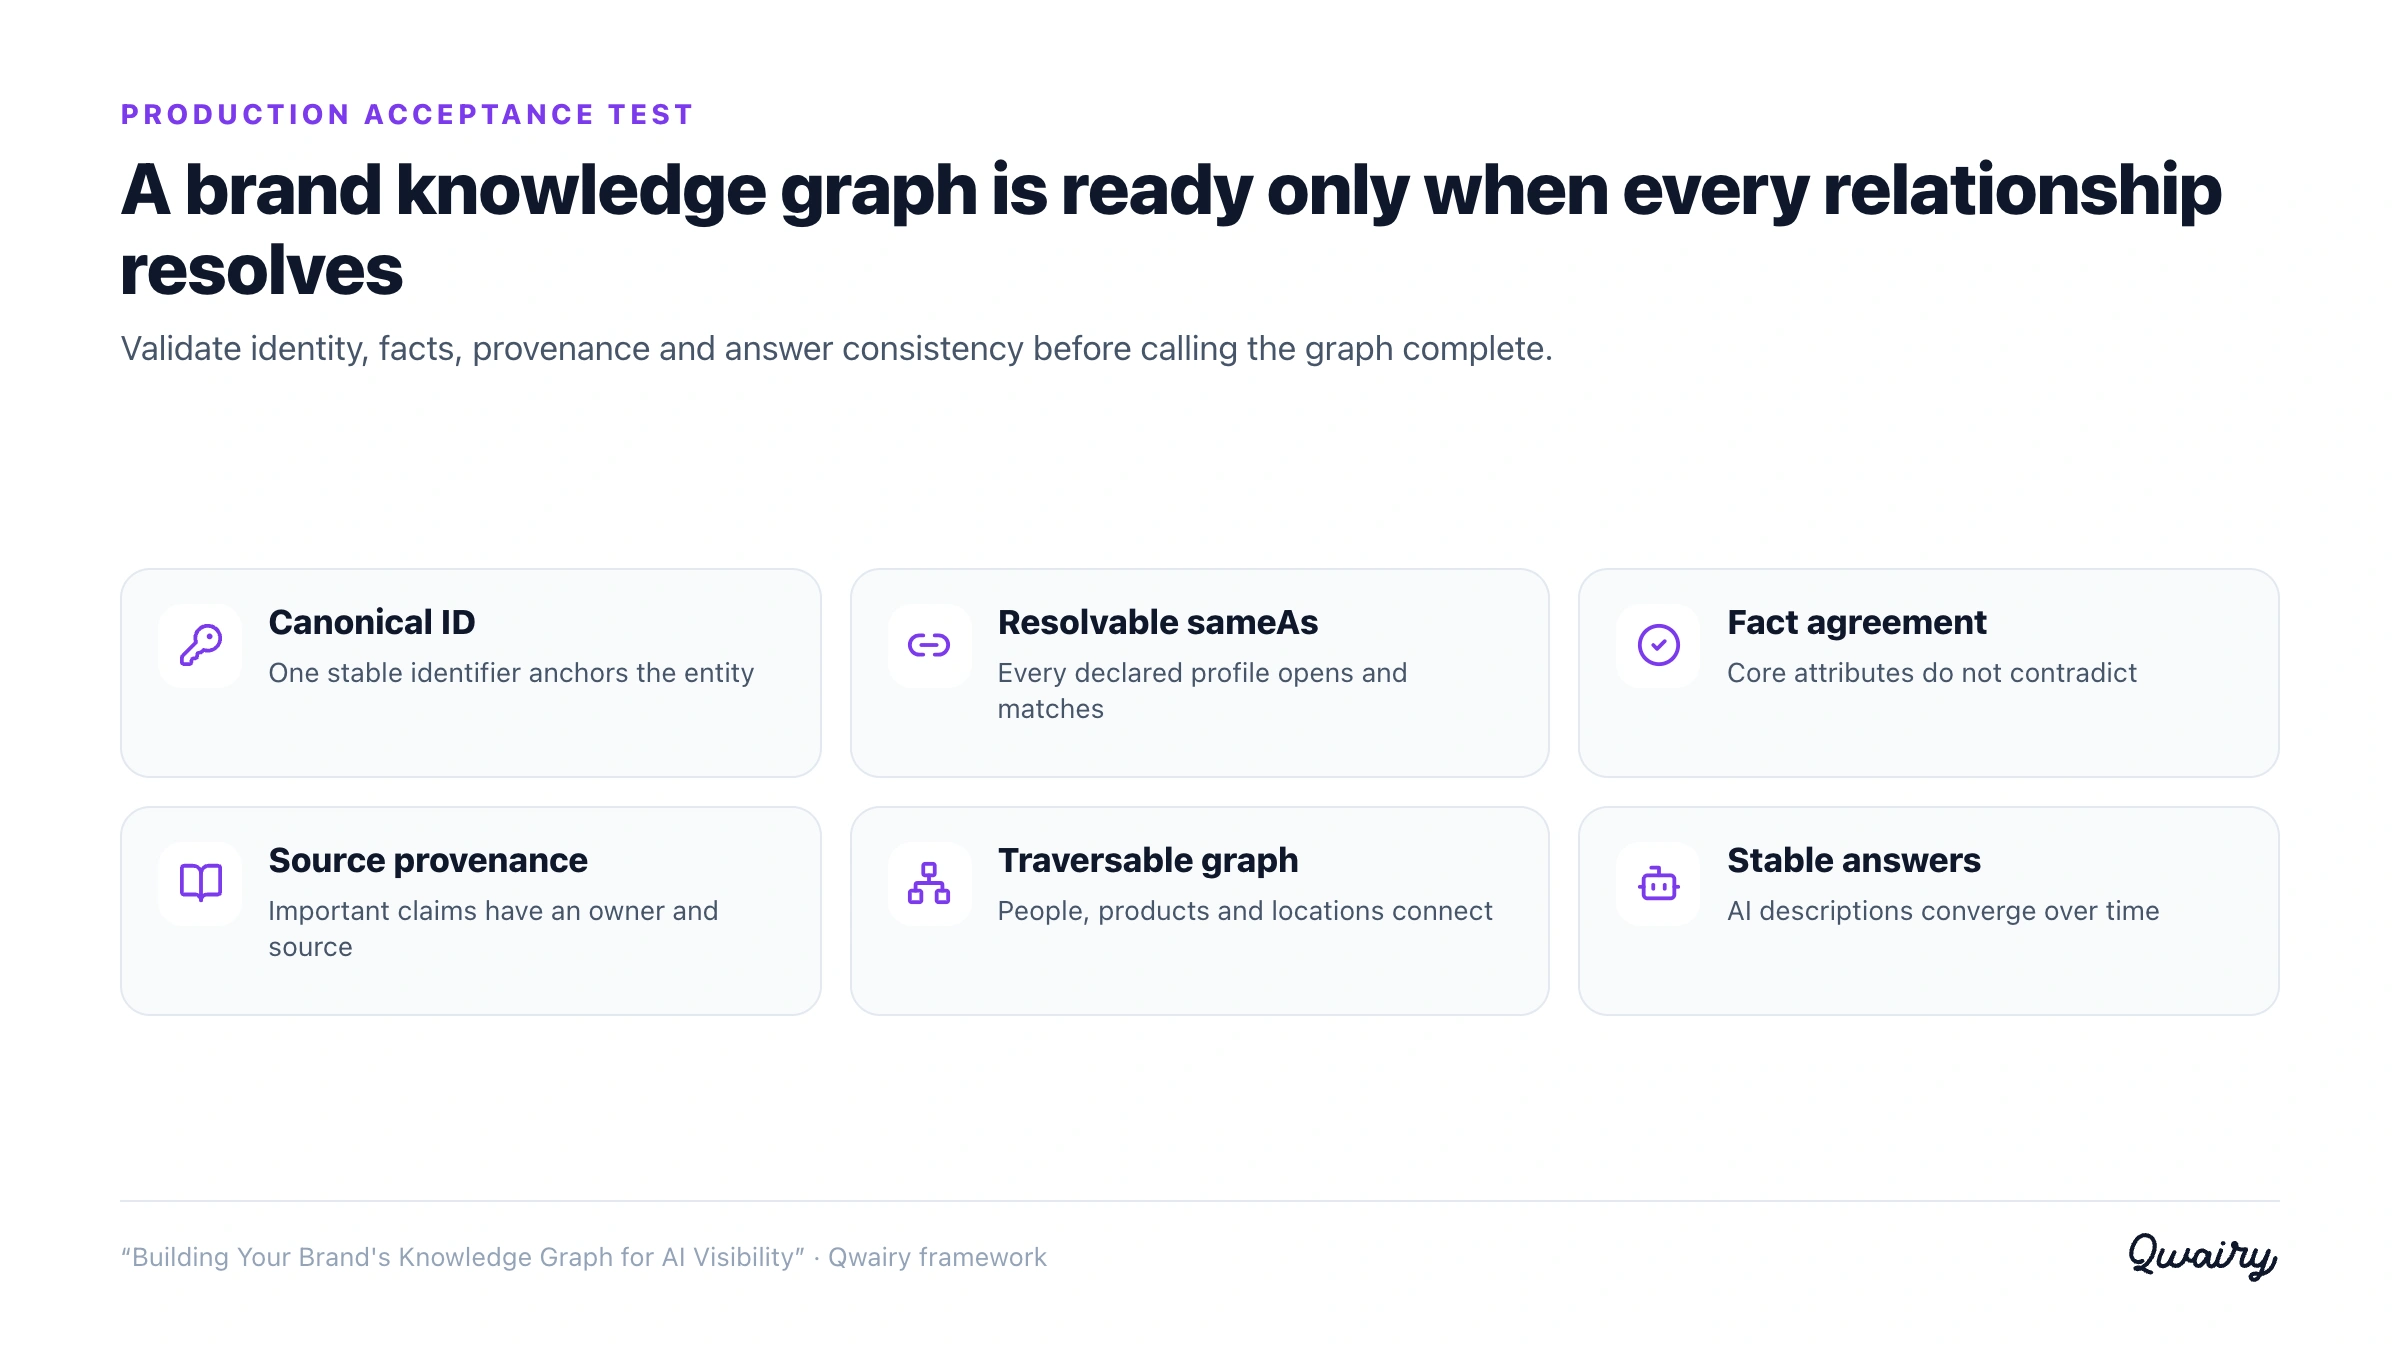
Ne considérez pas le graphe comme terminé parce que le schema Organization est valide. Un graphe de marque prêt pour la production passe les huit critères ci-dessous :
Un critère non validé bloque la mise en production pour l’entité concernée. Ce niveau d’exigence dépasse volontairement celui d’un validateur de schema : la syntaxe peut être parfaite alors que le graphe est faux sur le plan sémantique. Le test de recette protège contre les défaillances coûteuses dans les réponses de l’IA, notamment la confusion, les dirigeants périmés, les erreurs de propriété et l’attribution à la mauvaise marque.
Vérifiez les règles de votre robots.txt, votre llms.txt et votre sitemap pour les crawlers IA avant de réécrire la moindre page.
Construire des signaux d’entité n’est que la moitié du travail : il faut savoir si les moteurs d’IA les ont réellement assimilés et comment ils vous décrivent en conséquence. Le suivi de positions classique ne vous le dira pas. Les questions qui comptent désormais sont les suivantes : ChatGPT vous nomme-t-il dans votre catégorie ? Perplexity cite-t-il votre site ? L’AI Overview de Google vous décrit-il avec exactitude, ou avec un fait périmé ou faux ? Suivez quelques éléments dans le temps :
C’est exactement la couche que Qwairy est conçu pour surveiller : il suit la façon dont votre marque apparaît dans ChatGPT, Claude, Perplexity, Gemini et les AI Overviews de Google, les sources citées et la précision avec laquelle vous êtes décrit, afin que vous sachiez si votre travail sur les entités porte ses fruits et où il cale. Pour la stratégie plus large qui vise à établir votre marque comme entité reconnue, consultez les guides associés sur le blog Qwairy.
La plupart des chantiers de graphe de connaissances échouent pour des raisons prévisibles et évitables. Surveillez celles-ci :
sameAs est le seul signal que vous maîtrisez entièrement ; s’en passer, c’est laisser un levier inutilisé.Reliez le graphe au programme d’entités plus large : utilisez le SEO d’entités pour l’IA pour la carte complète des signaux, le guide de désambiguïsation d’entités pour les conflits entre noms proches et le guide Wikipedia et Wikidata pour les sources de connaissances publiques conformes aux règles.
Le passage des liens aux réponses récompense la clarté de l’identité. Les moteurs d’IA ne peuvent décrire, et citer, que les marques qu’ils comprennent comme des entités cohérentes. Bâtir le graphe de connaissances de votre marque, c’est rendre cette compréhension inévitable : une définition canonique de qui vous êtes, des données structurées qui l’énoncent et des sources indépendantes faisant autorité qui la corroborent sur tout le web. Commencez par ce que vous maîtrisez (un nommage cohérent, le schema Organization, des profils officiels propres, un élément Wikidata bien référencé), puis obtenez les citations qui rendent le tout durable. Ensuite, mesurez : en recherche IA, on ne pilote pas ce qu’on ne voit pas dire par le modèle.
Le graphe de connaissances est la base de données sous-jacente des entités, de leurs attributs et de leurs relations. Le panneau de connaissances est l’encadré visible sur la page de résultats de Google, qui apparaît dès que Google est sûr d’avoir compris une entité. Le panneau est un symptôme de données de graphe solides, pas les données elles-mêmes : vous pouvez être une entité bien modélisée sans panneau, mais en obtenir un est un bon indice que vos données d’entité sont cohérentes.
Non. Wikipedia est un signal de corroboration fort, mais elle n’est ni nécessaire ni suffisante. De nombreuses marques sont bien représentées dans le Knowledge Graph de Google et citées par les moteurs d’IA sans article Wikipedia, grâce à Wikidata, aux données structurées et à une couverture tierce faisant autorité. Ne visez Wikipedia que si vous remplissez réellement ses critères de notoriété.
Les moteurs génératifs doivent s’engager sur une seule interprétation de votre marque avant de pouvoir écrire à son sujet. Des données d’entité claires, cohérentes et bien sourcées réduisent le risque de cet engagement : les moteurs sont alors plus enclins à vous nommer, à vous décrire avec exactitude et à citer vos contenus. Des données rares ou contradictoires conduisent les moteurs à vous ignorer ou à deviner, c’est ainsi que s’installent les attributions erronées et les faits périmés. Les mécanismes exacts diffèrent selon les moteurs et ne sont pas entièrement divulgués.
Dès qu’un panneau apparaît pour votre marque, utilisez le processus officiel de vérification d’entité de Google pour le revendiquer. La vérification vous permet de proposer des corrections aux faits inexacts. Vous ne pouvez pas créer un panneau à la demande, il n’apparaît que lorsque les systèmes de Google reconnaissent votre entité, mais vous pouvez entretenir et corriger celui qui existe.
Les signaux que vous maîtrisez (schema Organization, profils cohérents, élément Wikidata) peuvent être en place en quelques jours à quelques semaines. Ceux que vous devez mériter (citations faisant autorité, panneau de connaissances, article Wikipedia) s’accumulent sur plusieurs mois et dépendent d’une vraie couverture et d’une notoriété réelle. Voyez-y un programme continu, pas un lancement.
Il faut observer ce que les moteurs disent réellement. Suivez la présence de votre marque, l’exactitude des faits que l’IA énonce à votre sujet, les sources citées et tout signe de confusion avec d’autres marques, sur les principaux moteurs et dans la durée. Des plateformes comme Qwairy sont conçues pour surveiller précisément cela, afin que vous repériez une dérive ou une mauvaise attribution et que vous la remontiez jusqu’à la source à corriger.
Suivez les questions qui comptent pour votre activité, voyez quelles marques chaque réponse mentionne et quelles sources elle cite, puis travaillez sur les manques.
Offre gratuite avec 120 crédits initiaux • Sans carte bancaire
Autres articles
How to Improve Your Brand Sentiment in ChatGPT and AI Search
Being mentioned by ChatGPT is not enough if it calls your products overpriced. A step-by-step process to analyze and improve how AI assistants talk about your brand, with Nike as an example.
Stratégie GEO : 5 vérités sur la recherche IA et un cadre en 4 étapes
Cinq vérités sur la recherche IA partagées au SEO & GEO Summit de Paris, et le cadre GEO en 4 étapes de Qwairy pour être recommandé par ChatGPT ou Gemini.