Loading page

Wikipedia et Wikidata nourrissent les descriptions de marques par l’IA : règles de notoriété et de sourçage, et voie conforme pour obtenir une présence durable.
Demandez à ChatGPT, à Perplexity ou aux AI Overviews de Google de décrire une entreprise, un fondateur ou une catégorie de produits, et vous remarquerez quelque chose : la réponse ressemble souvent à un résumé de Wikipedia. Ce n’est pas un hasard. Wikipedia et son pendant structuré, Wikidata, comptent parmi les sources qui influencent le plus la façon dont les systèmes d’IA comprennent le monde, et la façon dont ils vous décrivent, vous. Elles alimentent les données d’entraînement, ancrent les entités et nourrissent les panneaux de connaissances sur lesquels s’appuient les moteurs d’IA. Mais on ne peut pas y entrer en payant, ni en enjolivant. Les deux projets reposent sur des règles strictes, appliquées par la communauté, sur ce qui est assez notable pour être inclus et sur ce qui constitue une source fiable. Enfreignez-les et vous n’échouez pas seulement : votre page peut être supprimée et votre compte bloqué. Ce guide explique pourquoi Wikipedia et Wikidata comptent pour la visibilité IA, les règles de notoriété et de sourçage que vous devez réellement respecter, la voie conforme pour viser une présence, une introduction à Wikidata et les erreurs qui coûtent cher aux marques.
Wikipedia est surreprésentée dans les systèmes d’IA parce qu’elle l’est à la fois dans leurs données d’entraînement et dans leur récupération en direct. Les grands modèles de langage sont entraînés sur d’immenses corpus web, et Wikipedia est un incontournable de presque tous : l’article scientifique sur GPT-3, par exemple, cite Wikipedia parmi ses jeux de données d’entraînement nommés (arXiv ). Elle est propre, vaste, bien structurée et sous licence ouverte, exactement ce que recherchent les concepteurs de modèles. Les moteurs fondés sur la récupération s’y appuient aussi. Quand Perplexity, la recherche de ChatGPT ou les AI Overviews de Google assemblent une réponse en direct, Wikipedia figure fréquemment parmi les sources citées : plusieurs analyses indépendantes des domaines cités par l’IA l’ont placée à maintes reprises parmi les premiers, aux côtés de Reddit et de YouTube. La part exacte varie selon le moteur, le type de requête et le mois ; prenez donc tout chiffre isolé avec prudence.
L’influence de Wikidata est plus discrète, mais sans doute plus profonde. Wikidata est une base de connaissances structurée et lisible par les machines : chaque entité reçoit un identifiant stable (un « QID ») et un ensemble de déclarations typées. Elle alimente les infobox de Wikipedia et elle nourrit le Knowledge Graph de Google depuis que Google a mis fin à sa propre base Freebase et en a migré les données vers Wikidata. C’est ce Knowledge Graph qui génère les panneaux de connaissances à côté des résultats de recherche, soit les mêmes faits canoniques que les systèmes d’IA réutilisent de plus en plus.
Le vrai gain n’est pas une note de bas de page : c’est d’être reconnu comme une entité. Quand un modèle peut relier « votre marque » à un identifiant stable assorti d’un type clair (« entreprise SaaS », « fondée en 2021 », « siège à Paris »), il cesse de deviner. Il sait de quel « Apollo », de quel « Luna » ou de quel « Notion » il s’agit, et il arrête de vous confondre avec le dieu, la lune ou le concurrent installé deux villes plus loin. Wikipedia et Wikidata comptent parmi les sources les plus solides et les plus fiables de cet ancrage. Une citation vous fait mentionner une fois ; l’ancrage d’entité façonne la manière dont vous êtes décrit partout. Soyez toutefois lucide : la présence est un signal fort, pas une garantie. Le recours à Wikipedia et à Wikidata varie selon les moteurs et les questions, et aucune des deux n’est un interrupteur magique qui forcerait l’IA à vous recommander.
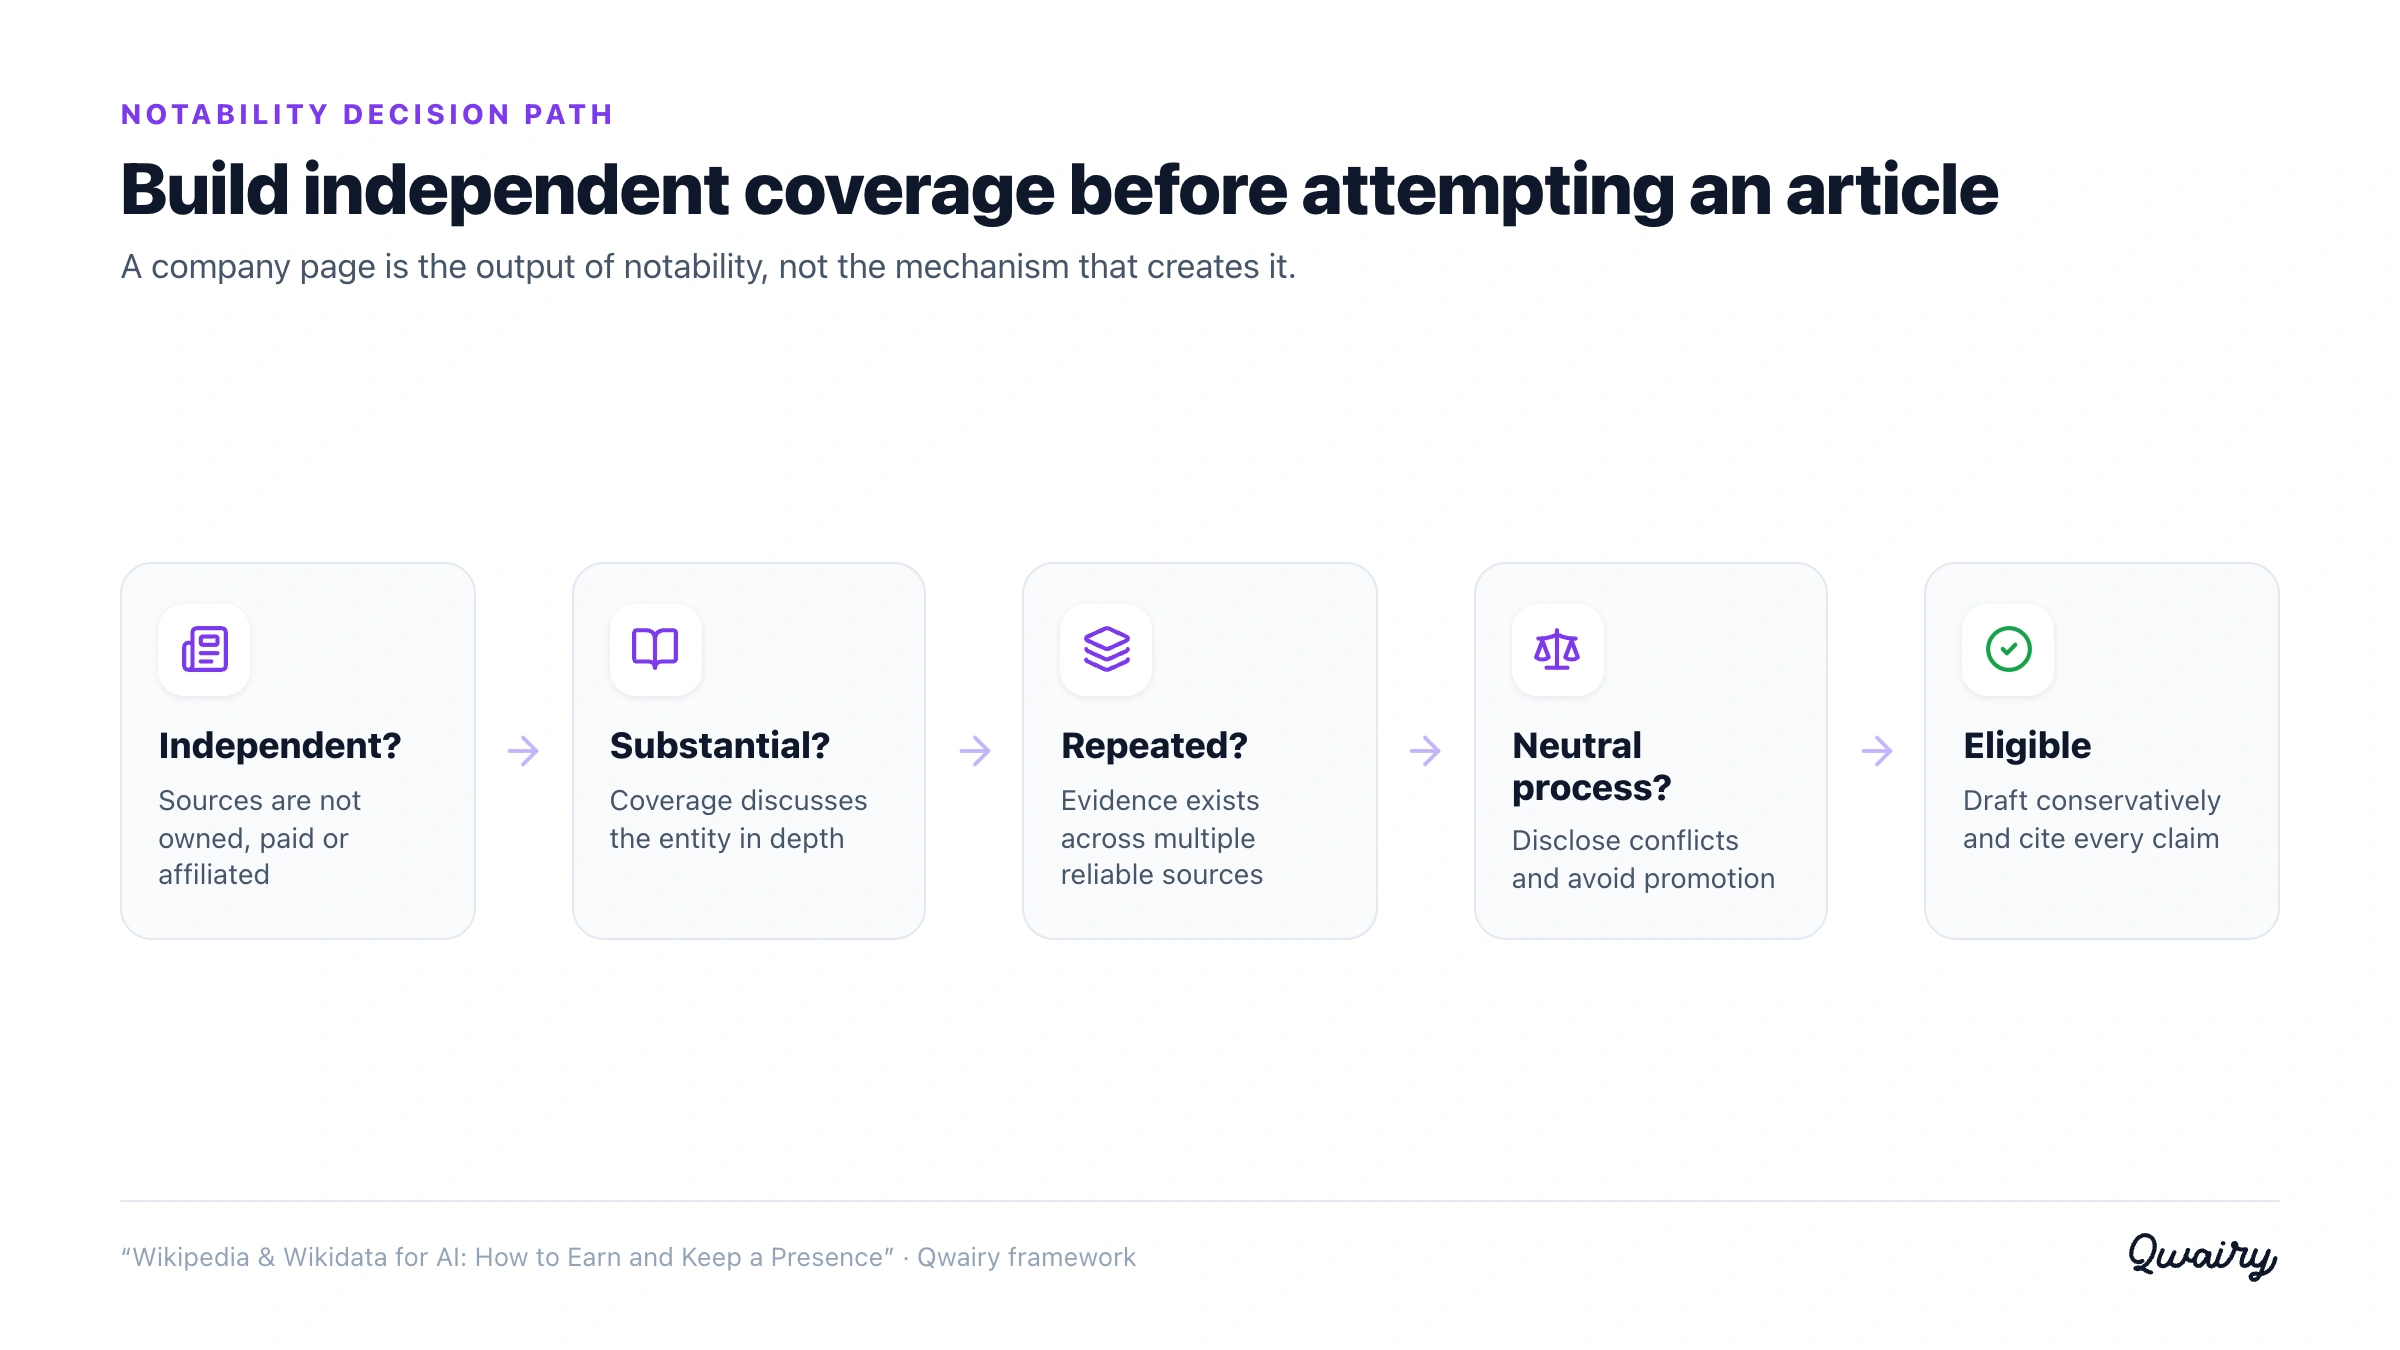
La sélectivité de Wikipedia est voulue, ce n’est pas un défaut, et elle s’applique à vous que cela vous plaise ou non. Le seuil s’appelle la notoriété, et c’est le standard de sourçage qui la sous-tend qui tient la plupart des marques à l’écart.
Le critère général de notoriété de Wikipedia exige « une couverture significative dans des sources fiables et indépendantes du sujet » (Wikipedia:Notability ). Lisez-le lentement, car chaque mot porte du poids :
Pour les entreprises et les organisations, le seuil est plus haut, pas plus bas. La ligne directrice dédiée (WP:NCORP) écarte explicitement la couverture de routine comme les levées de fonds, les lancements de produits et les articles dictés par les relations presse, et exige une analyse réellement indépendante et approfondie (WP:NCORP ). De nombreuses start-up bien financées ne sont tout simplement pas notables selon ce standard, pas encore, et c’est un résultat normal et légitime.
Lancez un audit gratuit : en quelques minutes, ChatGPT, Gemini et Perplexity répondent en direct à 8 questions d’achat sur votre marché, et vous voyez qui ils recommandent.
Tout ce qui figure sur Wikipedia doit pouvoir être vérifié dans des sources fiables et publiées (WP:V ). La ligne directrice sur les sources fiables privilégie les sources secondaires dotées d’un contrôle éditorial et d’une réputation de vérification des faits (WP:RS ). En pratique :
Compte | Ne compte pas |
Reportages indépendants dans la presse établie | Communiqués de presse et diffusions par agences de communiqués |
Livres, analyses académiques et sectorielles | Votre propre site, blog ou documentation |
Portraits tiers approfondis | Placements sponsorisés ou payés |
Couverture soumise à des standards éditoriaux identifiés | La plupart des publications sociales et des forums |
Si vous ne pouvez pas citer plusieurs sources de la colonne de gauche, vous n’avez pas encore d’article Wikipedia. La solution n’est pas de mieux écrire : c’est d’obtenir d’abord une vraie couverture.
Le seuil d’inclusion de Wikidata est bien plus bas que celui de Wikipedia, ce qui en fait souvent la meilleure première cible. Sa politique de notoriété accepte un élément s’il renvoie à une entité clairement identifiable pouvant être décrite avec au moins une référence sérieuse et publiquement disponible, ou s’il répond à un besoin structurel, par exemple relier d’autres éléments entre eux (Wikidata:Notability ). Vous n’avez pas besoin d’un article Wikipedia pour avoir un élément Wikidata. Wikidata devient ainsi un point de départ réaliste et légitime pour de nombreuses marques qui ne sont pas encore notables sur Wikipedia, à condition que les déclarations soient exactes et sourcées.
Le moyen le plus rapide de ruiner votre réputation sur Wikipedia est de modifier votre propre article en croyant que personne ne s’en apercevra. Ils s’en apercevront. Wikipedia déconseille fortement de modifier les articles qui vous concernent, qui concernent votre employeur ou vos clients : c’est un conflit d’intérêts (WP:COI ). Et si vous êtes rémunéré pour modifier, y compris comme salarié, agence ou freelance, les Conditions d’utilisation de Wikimedia exigent que vous le déclariez, et la politique de déclaration des contributions rémunérées de Wikipedia en précise les modalités. L’édition rémunérée non déclarée et l’autopromotion se terminent régulièrement par :
Ne créez pas de comptes factices (sockpuppets), ne payez pas discrètement quelqu’un pour glisser votre page et ne traitez pas l’article comme un texte marketing. Wikipedia n’est pas un actif de marque que vous contrôlez : c’est une encyclopédie qui se trouve vous décrire.
Il existe une voie légitime, simplement plus lente et plus honnête que ce que la plupart des agences admettent. Suivez-la dans l’ordre :
{{request edit}} et laissez un éditeur non impliqué agir.Content Opportunities liste les sujets où l’IA mentionne vos concurrents mais pas votre marque, chacun avec un score d’impact.
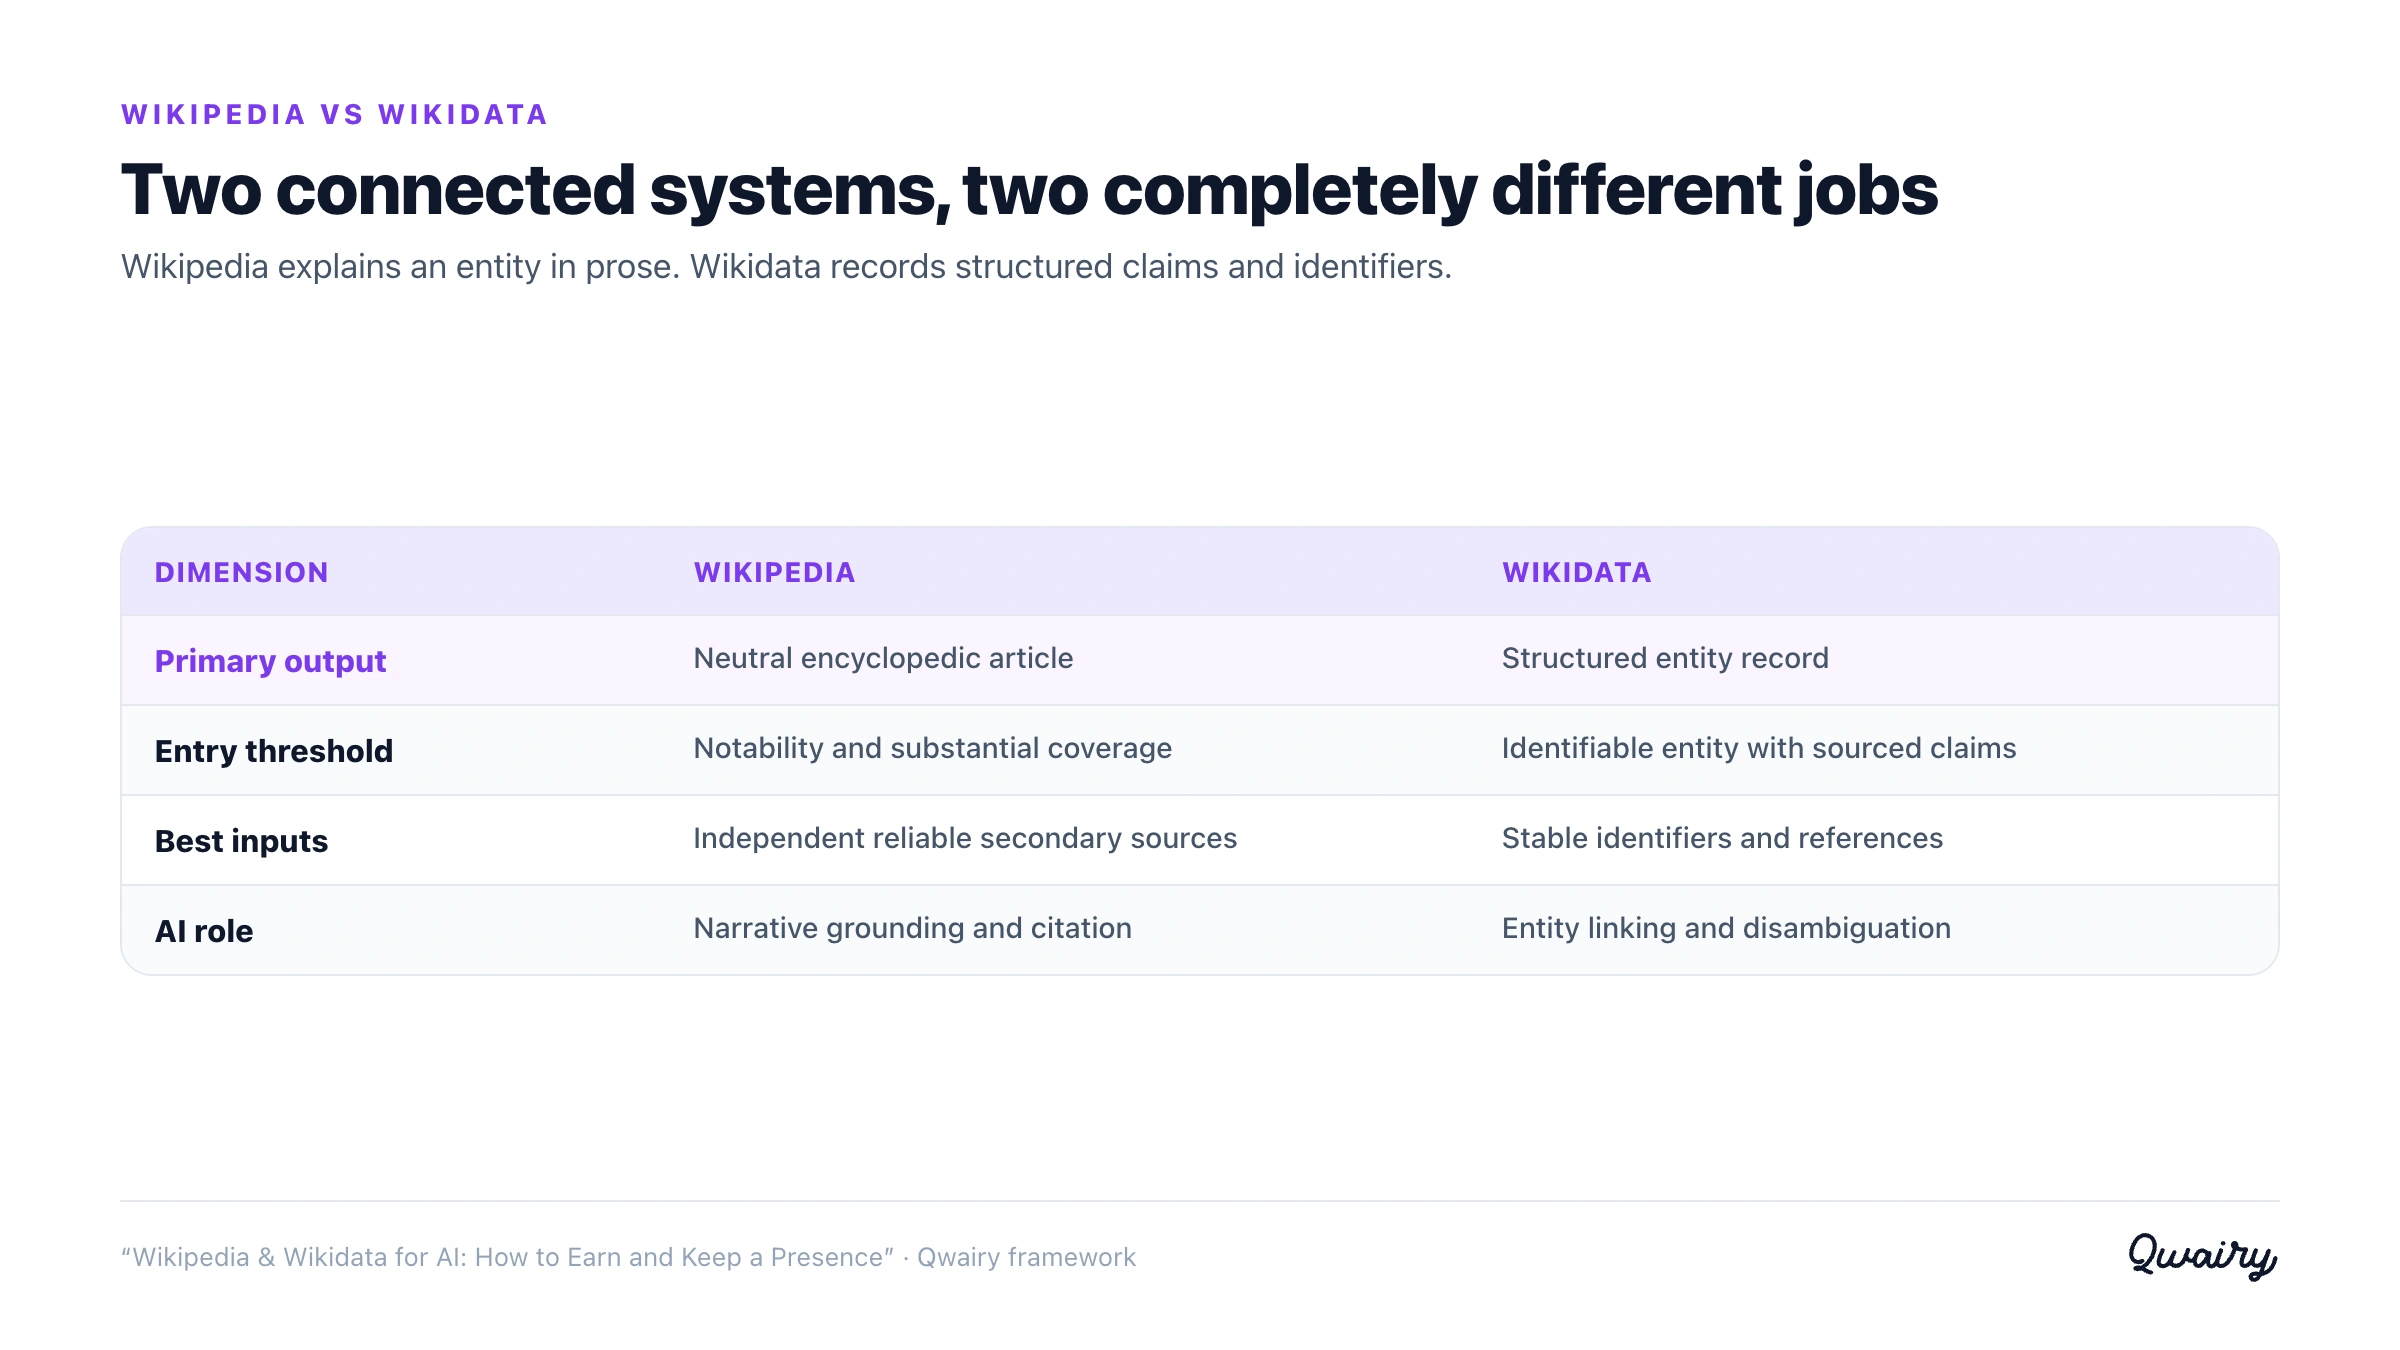
Wikidata est une base de données d’éléments, et une fois quatre notions comprises, on s’y repère.
Q42. Ce QID est l’ancre canonique vers laquelle d’autres systèmes, dont l’IA, peuvent vous résoudre.sameAs. Wikidata relie votre élément à d’autres bases de données et profils faisant autorité. Ces liens croisés sont exactement les signaux de désambiguïsation d’entités que les systèmes d’IA valorisent.Pour procéder de façon légitime : cherchez d’abord dans Wikidata pour confirmer qu’aucun élément n’existe déjà, créez l’élément avec un libellé et une description clairs, ajoutez des déclarations bien référencées pour les faits essentiels et renvoyez vers des identifiants faisant autorité. Restez factuel : Wikidata n’est pas un lieu pour des slogans. Commencez par l’introduction à Wikidata .
On ne peut pas piloter ce qu’on ne voit pas, et le travail sur Wikipedia et Wikidata est assez lent pour qu’il vous faille un retour afin de le justifier. Les questions à suivre : les moteurs d’IA décrivent-ils votre marque de façon exacte et cohérente ? Wikipedia apparaît-elle comme source citée dans les réponses sur votre catégorie ? Une déclaration Wikidata corrigée a-t-elle changé la manière dont les modèles parlent de vous ? C’est là que le suivi continu de la visibilité IA prend tout son sens. Des plateformes comme Qwairy suivent la façon dont votre marque apparaît dans ChatGPT, Claude, Perplexity, Gemini et les AI Overviews de Google : quelles sources sont citées, comment vous êtes décrit et comment cela évolue dans le temps. Vous pouvez ainsi relier le travail sur les entités à une évolution réelle plutôt que de deviner. Associez le travail de fond honnête et conforme décrit plus haut à la mesure, et vous saurez si votre présence rapporte vraiment.
Posez les fondations avant la couche encyclopédique : commencez par le SEO d’entités pour l’IA, construisez un graphe de connaissances de marque cohérent et utilisez le guide de désambiguïsation d’entités quand des noms ou des faits sont confondus.
Wikipedia et Wikidata comptent parmi les signaux d’entité les plus puissants de la recherche IA, mais elles récompensent la patience et punissent les raccourcis. Obtenez une vraie couverture, respectez les règles de notoriété et de sourçage, déclarez tout conflit d’intérêts et laissez le processus communautaire jouer. Commencez par Wikidata quand vous le pouvez, ne visez Wikipedia que lorsque les sources le justifient vraiment, et mesurez l’effet en aval sur la façon dont l’IA vous décrit. Faites-le honnêtement et la présence tient ; tentez de tricher et vous dépenserez plus d’énergie à vous faire supprimer que vous n’en aurez jamais économisé.
Non. Un article Wikipedia aide, mais il n’est pas obligatoire. Un élément Wikidata bien référencé, des données structurées cohérentes sur votre propre site et une couverture tierce faisant autorité contribuent tous à la reconnaissance de l’entité. Wikipedia est un signal fort parmi d’autres, pas un prérequis.
Techniquement, vous pouvez modifier, mais vous ne devriez pas créer directement un article sur votre propre marque. C’est un conflit d’intérêts, et l’édition rémunérée doit être déclarée selon les Conditions d’utilisation de Wikimedia. La bonne approche consiste à déclarer votre conflit d’intérêts et à soumettre un brouillon via Articles for Creation, pour qu’un relecteur indépendant tranche.
Wikipedia est une encyclopédie d’articles lisibles par des humains ; Wikidata est une base de données structurée et lisible par les machines, qui recense des entités et des faits. Wikidata a un seuil d’inclusion bien plus bas et peut exister sans article Wikipedia, ce qui en fait souvent la première cible la plus réaliste pour une marque.
Elle est stricte. La ligne directrice sur les organisations et les entreprises (WP:NCORP) écarte explicitement la couverture de routine, comme les annonces de levées de fonds et les lancements de produits, et exige des sources significatives, indépendantes et approfondies. De nombreuses start-up financées ne sont tout simplement pas encore notables, et c’est un résultat attendu, pas un échec de vos relations presse.
Non. La présence est un signal d’ancrage fort, pas une garantie. L’importance que chaque moteur accorde à Wikipedia ou à Wikidata varie selon le modèle et la requête, et être décrit avec exactitude n’est pas la même chose qu’être recommandé. Voyez-y un moyen d’améliorer vos chances, et l’exactitude de votre représentation.
Surveillez dans le temps la façon dont les moteurs d’IA décrivent et citent votre marque. Observez si Wikipedia apparaît comme source citée dans les réponses sur votre catégorie, si vos faits sont correctement représentés et si les modifications de votre élément Wikidata font bouger les lignes. Un suivi continu de la visibilité IA, par exemple avec Qwairy, transforme cela en quelque chose que vous pouvez réellement voir plutôt qu’en suppositions.
Suivez les questions qui comptent pour votre activité, voyez quelles marques chaque réponse mentionne et quelles sources elle cite, puis travaillez sur les manques.
Offre gratuite avec 120 crédits initiaux • Sans carte bancaire
Autres articles
How to Improve Your Brand Sentiment in ChatGPT and AI Search
Being mentioned by ChatGPT is not enough if it calls your products overpriced. A step-by-step process to analyze and improve how AI assistants talk about your brand, with Nike as an example.
Stratégie GEO : 5 vérités sur la recherche IA et un cadre en 4 étapes
Cinq vérités sur la recherche IA partagées au SEO & GEO Summit de Paris, et le cadre GEO en 4 étapes de Qwairy pour être recommandé par ChatGPT ou Gemini.