Loading page

Désambiguïsation d’entités : pourquoi l’IA fusionne ou attribue mal des marques aux noms proches, comment le diagnostiquer sur ChatGPT, et les correctifs.
Interrogez ChatGPT ou Perplexity sur votre entreprise, et vous risquez de ne pas reconnaître la réponse. Le modèle décrit le produit d’un concurrent, attribue votre fondateur à une autre start-up ou mélange deux sociétés au nom proche en un seul profil assuré, mais faux. Ce n’est pas une hallucination au sens habituel : c’est un échec de résolution d’entités. Les moteurs de réponse IA ne traitent pas les noms de marque comme des chaînes de texte. Ils résolvent les noms vers des entités : des « choses » distinctes dans un graphe de connaissances, chacune avec ses propres attributs, ses relations et ses sources. Quand l’entité de votre marque est mal définie, ou ressemble trop à une autre, le modèle rattache la requête au mauvais nœud, et tout ce qui en découle hérite de l’erreur. Pour les acheteurs, c’est pire que l’invisibilité. Une mauvaise réponse dans une conversation avec une IA atteint directement le prospect, porte l’autorité du modèle, et vous avez rarement l’occasion de la corriger sur le moment. Ce guide explique pourquoi les modèles confondent des marques et des personnes aux noms proches, comment le diagnostiquer sur les principaux moteurs et quels correctifs de désambiguïsation d’entités rendent votre entité incontestable, ainsi que la manière de surveiller pour qu’une correction reste effective.
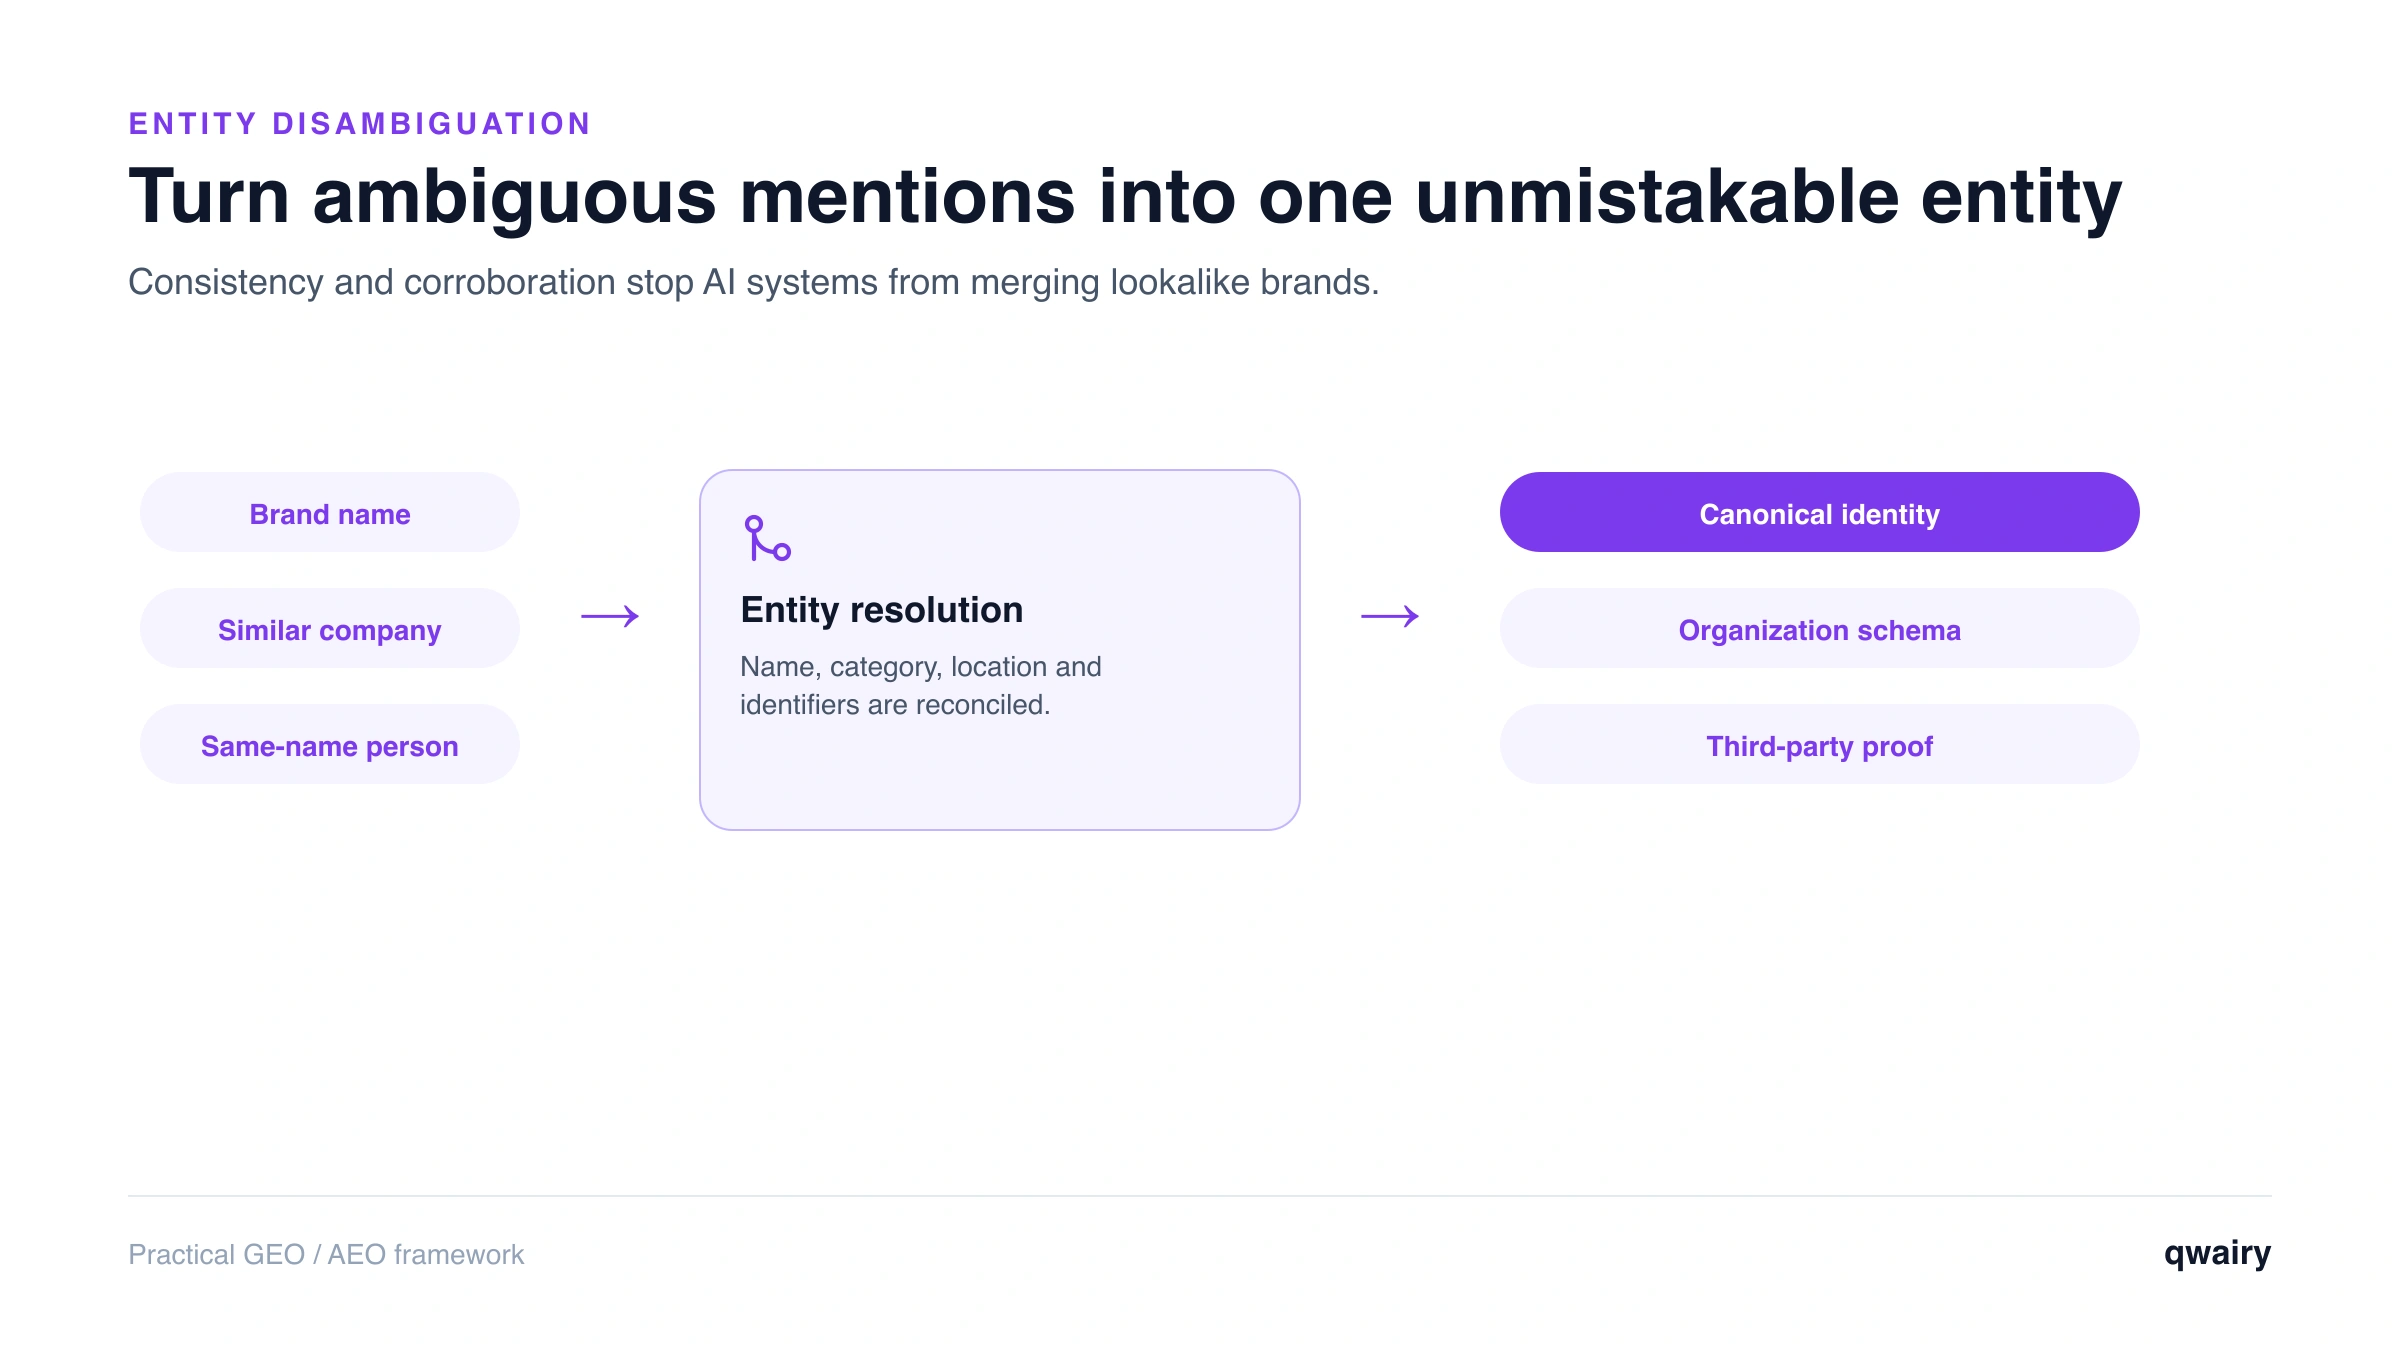
Les systèmes modernes de recherche et d’IA indexent des entités, et pas seulement des mots-clés. Google l’a rendu explicite en 2012 avec le Knowledge Graph, dans la formule restée célèbre « des choses, pas des chaînes de caractères » . Les moteurs de réponse fondés sur des LLM héritent du même principe : un nom est un pointeur vers une entité, et le travail du modèle consiste à résoudre de quelle entité vous parlez. En termes académiques, il s’agit de la désambiguïsation d’entités nommées, ou liaison d’entités (entity linking) : associer une mention dans un texte à la bonne entrée d’une base de connaissances. La résolution déraille quand les signaux sont rares ou contradictoires. Les déclencheurs habituels :
La confusion se manifeste selon quelques schémas reconnaissables :
Le mécanisme est toujours le même : le modèle est sûr de lui, et l’assurance n’est pas l’exactitude. La logique interne de désambiguïsation diffère selon les moteurs et n’est pas documentée publiquement en détail, mais les leviers qui la façonnent sont constants, et vous les maîtrisez.
Avant de corriger quoi que ce soit, vérifiez ce que chaque moteur croit réellement savoir de vous. Traitez cela comme un audit, pas comme un sondage ponctuel. Lancez ce diagnostic :
Consignez chaque constat : le moteur, la mauvaise entité, les faits intervertis et les sources citées. Ce journal devient à la fois votre liste de correctifs et votre référence avant/après.
Désambiguïser, c’est donner aux machines des signaux non ambigus et corroborés sur ce que vous êtes, et sur ce que vous n’êtes pas. Suivez-les dans l’ordre : les premiers font l’essentiel du travail.
Choisissez un nom de marque canonique et un nom juridique ou d’entité cohérent, et cessez de les faire dériver. Alignez votre nom, et, le cas échéant, votre adresse et vos coordonnées (NAP), sur votre site, vos profils sociaux, les annuaires, les app stores et votre profil d’établissement Google . Un nom incohérent est la cause la plus fréquente pour laquelle un modèle ne parvient pas à rattacher proprement votre entité.
Lancez un audit gratuit : en quelques minutes, ChatGPT, Gemini et Perplexity répondent en direct à 8 questions d’achat sur votre marché, et vous voyez qui ils recommandent.
Les données structurées donnent aux crawlers une identité explicite et lisible par les machines. Sur votre page d’accueil et votre page À propos, ajoutez des données structurées Organization (ou LocalBusiness / Person pour des individus), et utilisez la propriété sameAs pour renvoyer vers chaque profil de référence qui représente la même entité :
sameAs est la déclaration explicite du web : « tout cela, c’est la même chose ». C’est l’un des signaux de désambiguïsation les plus nets que vous puissiez publier, et vous le contrôlez entièrement. Validez-le avec le Rich Results Test de Google et le Schema Markup Validator. Le schema seul n’obligera pas un LLM à se mettre à jour, mais c’est un signal peu coûteux et très clair, qui renforce tout le reste.
Wikidata est une base de connaissances structurée, sous licence ouverte, qui alimente le Knowledge Graph de Google et qui est largement réutilisée comme donnée d’ancrage sur le web. Un élément Wikidata correct, avec votre nom officiel, une description précise, des déclarations instance of / secteur et des identifiants externes, vous désambiguïse directement.
Donnez aux modèles une page canonique qui dit clairement qui vous êtes, dans quelle catégorie vous êtes, qui vous n’êtes pas et les faits qui vous définissent (création, localisation, direction, produits). Une page À propos ou d’entité sans ambiguïté, rédigée pour l’extraction, en phrases déclaratives simples, est ce que les moteurs de récupération citent quand ils veulent une auto-description propre.
Les modèles font confiance aux entités que des sources indépendantes et faisant autorité décrivent de la même manière. Chaque mention cohérente (presse, annuaires sectoriels, sites d’avis réputés, podcasts, biographies de conférenciers) renforce le bon rattachement.
Bâtir une entité de façon générale aide ; un contraste ciblé termine le travail. Une fois que vous savez exactement avec quelle entité on vous confond, rendez les différences lisibles :
Ce que vous observez | Cause probable | Correctif principal |
Deux marques fusionnées dans une même réponse | Séparation faible des entités, nom partagé | Alias Wikidata + `sameAs` • texte de contraste explicite |
Fonctionnalités ou fondateur attribués à un concurrent | Sources faisant autorité rares | Corroboration tierce + page de référence de l’entité |
Ancien nom ou ancien positionnement après un changement de marque | Données d’ancrage périmées | Mettre à jour le schema, Wikidata, les annuaires ; publier une note sur le changement de marque |
Détails inventés | Entité peu décrite | Publier des faits déclaratifs ; ajouter le schema Organization |
Site d’un concurrent cité sous votre nom | Ancrage de la récupération sur la mauvaise source | Renforcer vos propres pages citables ; obtenir des mentions pertinentes sur le sujet |
Content Opportunities liste les sujets où l’IA mentionne vos concurrents mais pas votre marque, chacun avec un score d’impact.
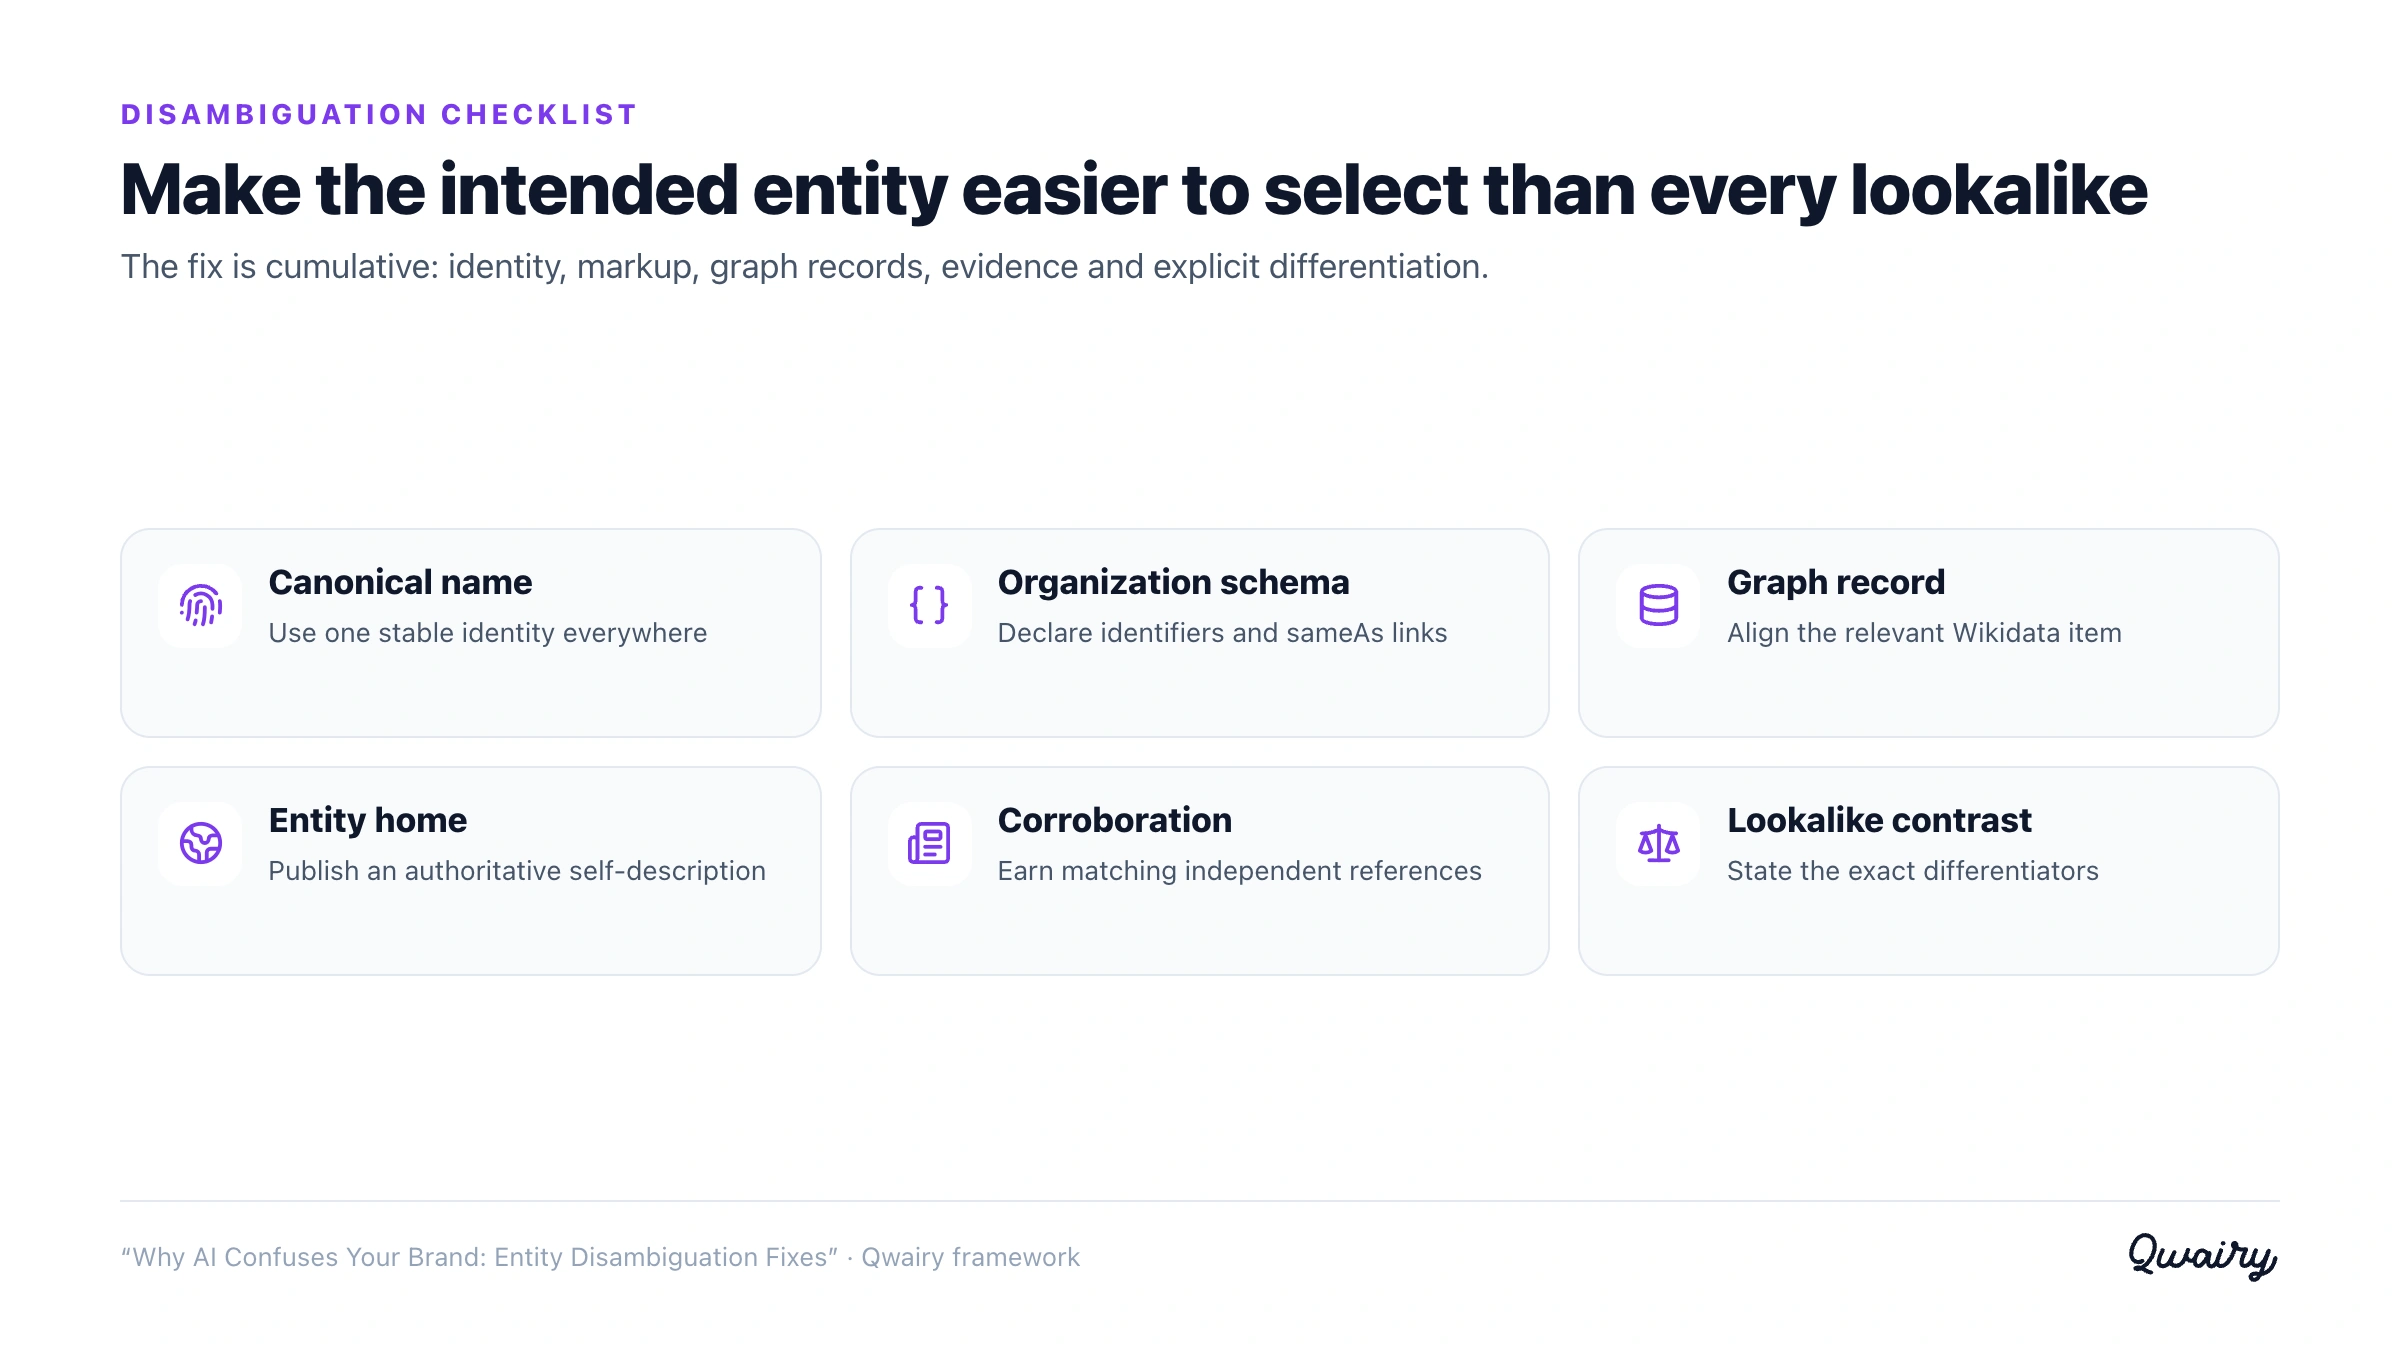
Utilisez-la comme checklist de travail :
sameAs renvoyant vers chaque profil de référenceLes correctifs d’entité s’érodent. Les sources changent, les concurrents publient, les modèles actualisent leurs données d’ancrage, et un changement de marque peut réintroduire discrètement la confusion. La désambiguïsation est autant un problème de surveillance qu’un correctif ponctuel. Vous avez besoin d’une visibilité continue sur la façon dont chaque moteur important vous décrit, et pas d’un sondage manuel trimestriel. Il faut donc suivre, pour chaque moteur : si la bonne entité est renvoyée, quels faits vous sont attribués, quelles sources sont citées et comment la perception évolue une fois la confusion levée. C’est la couche pour laquelle Qwairy est conçu. Il surveille la façon dont votre marque apparaît dans ChatGPT, Claude, Perplexity, Gemini et les AI Overviews de Google, fait ressortir les sources qui alimentent ces réponses, suit les mentions des concurrents et la perception, et signale quand un modèle attribue de mauvais faits : une mauvaise attribution apparaît ainsi dans un tableau de bord, et non dans une vente perdue. Pour les équipes qui veulent que leurs propres agents interrogent ces données, un MCP pensé pour les agents est disponible. Pour d’autres tactiques GEO, parcourez le blog Qwairy.
Poursuivez le travail sur les entités : utilisez le SEO d’entités pour l’IA comme feuille de route plus large, construisez un graphe de connaissances de marque maintenu dans le temps, et ne visez Wikipedia ou Wikidata que lorsque l’éligibilité et les sources sont légitimes.
L’IA confond votre marque quand votre entité est mal définie ou trop proche d’une voisine. Le remède n’est pas un prompt astucieux : c’est de rendre votre identité non ambiguë là où les machines lisent. Un nom cohérent, le schema Organization avec sameAs, un élément Wikidata correct, une page de référence déclarative, des sources tierces alignées et un contraste ciblé avec l’homonyme précis. Posez ces signaux, vérifiez que chaque moteur les prend en compte et surveillez pour que la correction tienne. Le modèle cessera alors de deviner, parce que vous lui aurez dit, dans sa propre langue, exactement qui vous êtes.
Les moteurs de réponse résolvent les noms vers des entités d’une base de connaissances, et non vers du texte littéral. Quand votre entité est mal définie ou partage un nom avec une autre entité bien documentée, le modèle se rattache à la mauvaise et hérite de ses faits. Renforcer et séparer vos signaux d’entité règle la cause profonde plutôt que le symptôme.
Demandez à chaque moteur « Qu’est-ce que [Marque] ? » puis « Que fait [Marque], la plateforme de [catégorie] ? », comparez les réponses et inspectez les sources citées. Un écart entre les réponses, des faits intervertis ou des URL de concurrents dans les citations indiquent tous une confusion d’entités. Faites-le sur chaque moteur, car ils peuvent se contredire.
Les données structurées (schema Organization et sameAs) donnent aux crawlers une déclaration explicite, lisible par les machines, de votre identité et de ses profils équivalents. Elles n’obligeront pas à elles seules un LLM à se mettre à jour, mais c’est un signal peu coûteux et très clair qui appuie tous les autres correctifs, et que vous contrôlez entièrement.
Non. Wikipedia aide si vous êtes réellement notable, mais un élément Wikidata correct, un nom cohérent, des liens sameAs et des sources tierces alignées établissent une entité claire sans cela. Ne visez Wikipedia que dans le respect des règles, appuyé sur une couverture secondaire indépendante.
Cela varie. Les changements ne se propagent qu’une fois que les moteurs ont ré-exploré votre site et que leurs sources d’ancrage se sont mises à jour, ce qui peut prendre des semaines. C’est pourquoi il faut relever une référence de départ avant de changer quoi que ce soit et refaire un audit ensuite, plutôt que de supposer une correction immédiate.
L’invisibilité signifie que le modèle ne vous fait pas apparaître du tout ; la confusion signifie qu’il fait apparaître de mauvais faits sous votre nom. La confusion est souvent plus dommageable, parce qu’une mauvaise réponse atteint l’acheteur avec l’assurance du modèle derrière elle et paraît faire autorité.
Suivez les questions qui comptent pour votre activité, voyez quelles marques chaque réponse mentionne et quelles sources elle cite, puis travaillez sur les manques.
Offre gratuite avec 120 crédits initiaux • Sans carte bancaire
Autres articles
How to Improve Your Brand Sentiment in ChatGPT and AI Search
Being mentioned by ChatGPT is not enough if it calls your products overpriced. A step-by-step process to analyze and improve how AI assistants talk about your brand, with Nike as an example.
Stratégie GEO : 5 vérités sur la recherche IA et un cadre en 4 étapes
Cinq vérités sur la recherche IA partagées au SEO & GEO Summit de Paris, et le cadre GEO en 4 étapes de Qwairy pour être recommandé par ChatGPT ou Gemini.